Teach Learn Med. 2023 Aug-Sep;35(4):467-476. doi: 10.1080/10401334.2022.2074423. Epub 2022 May 26.

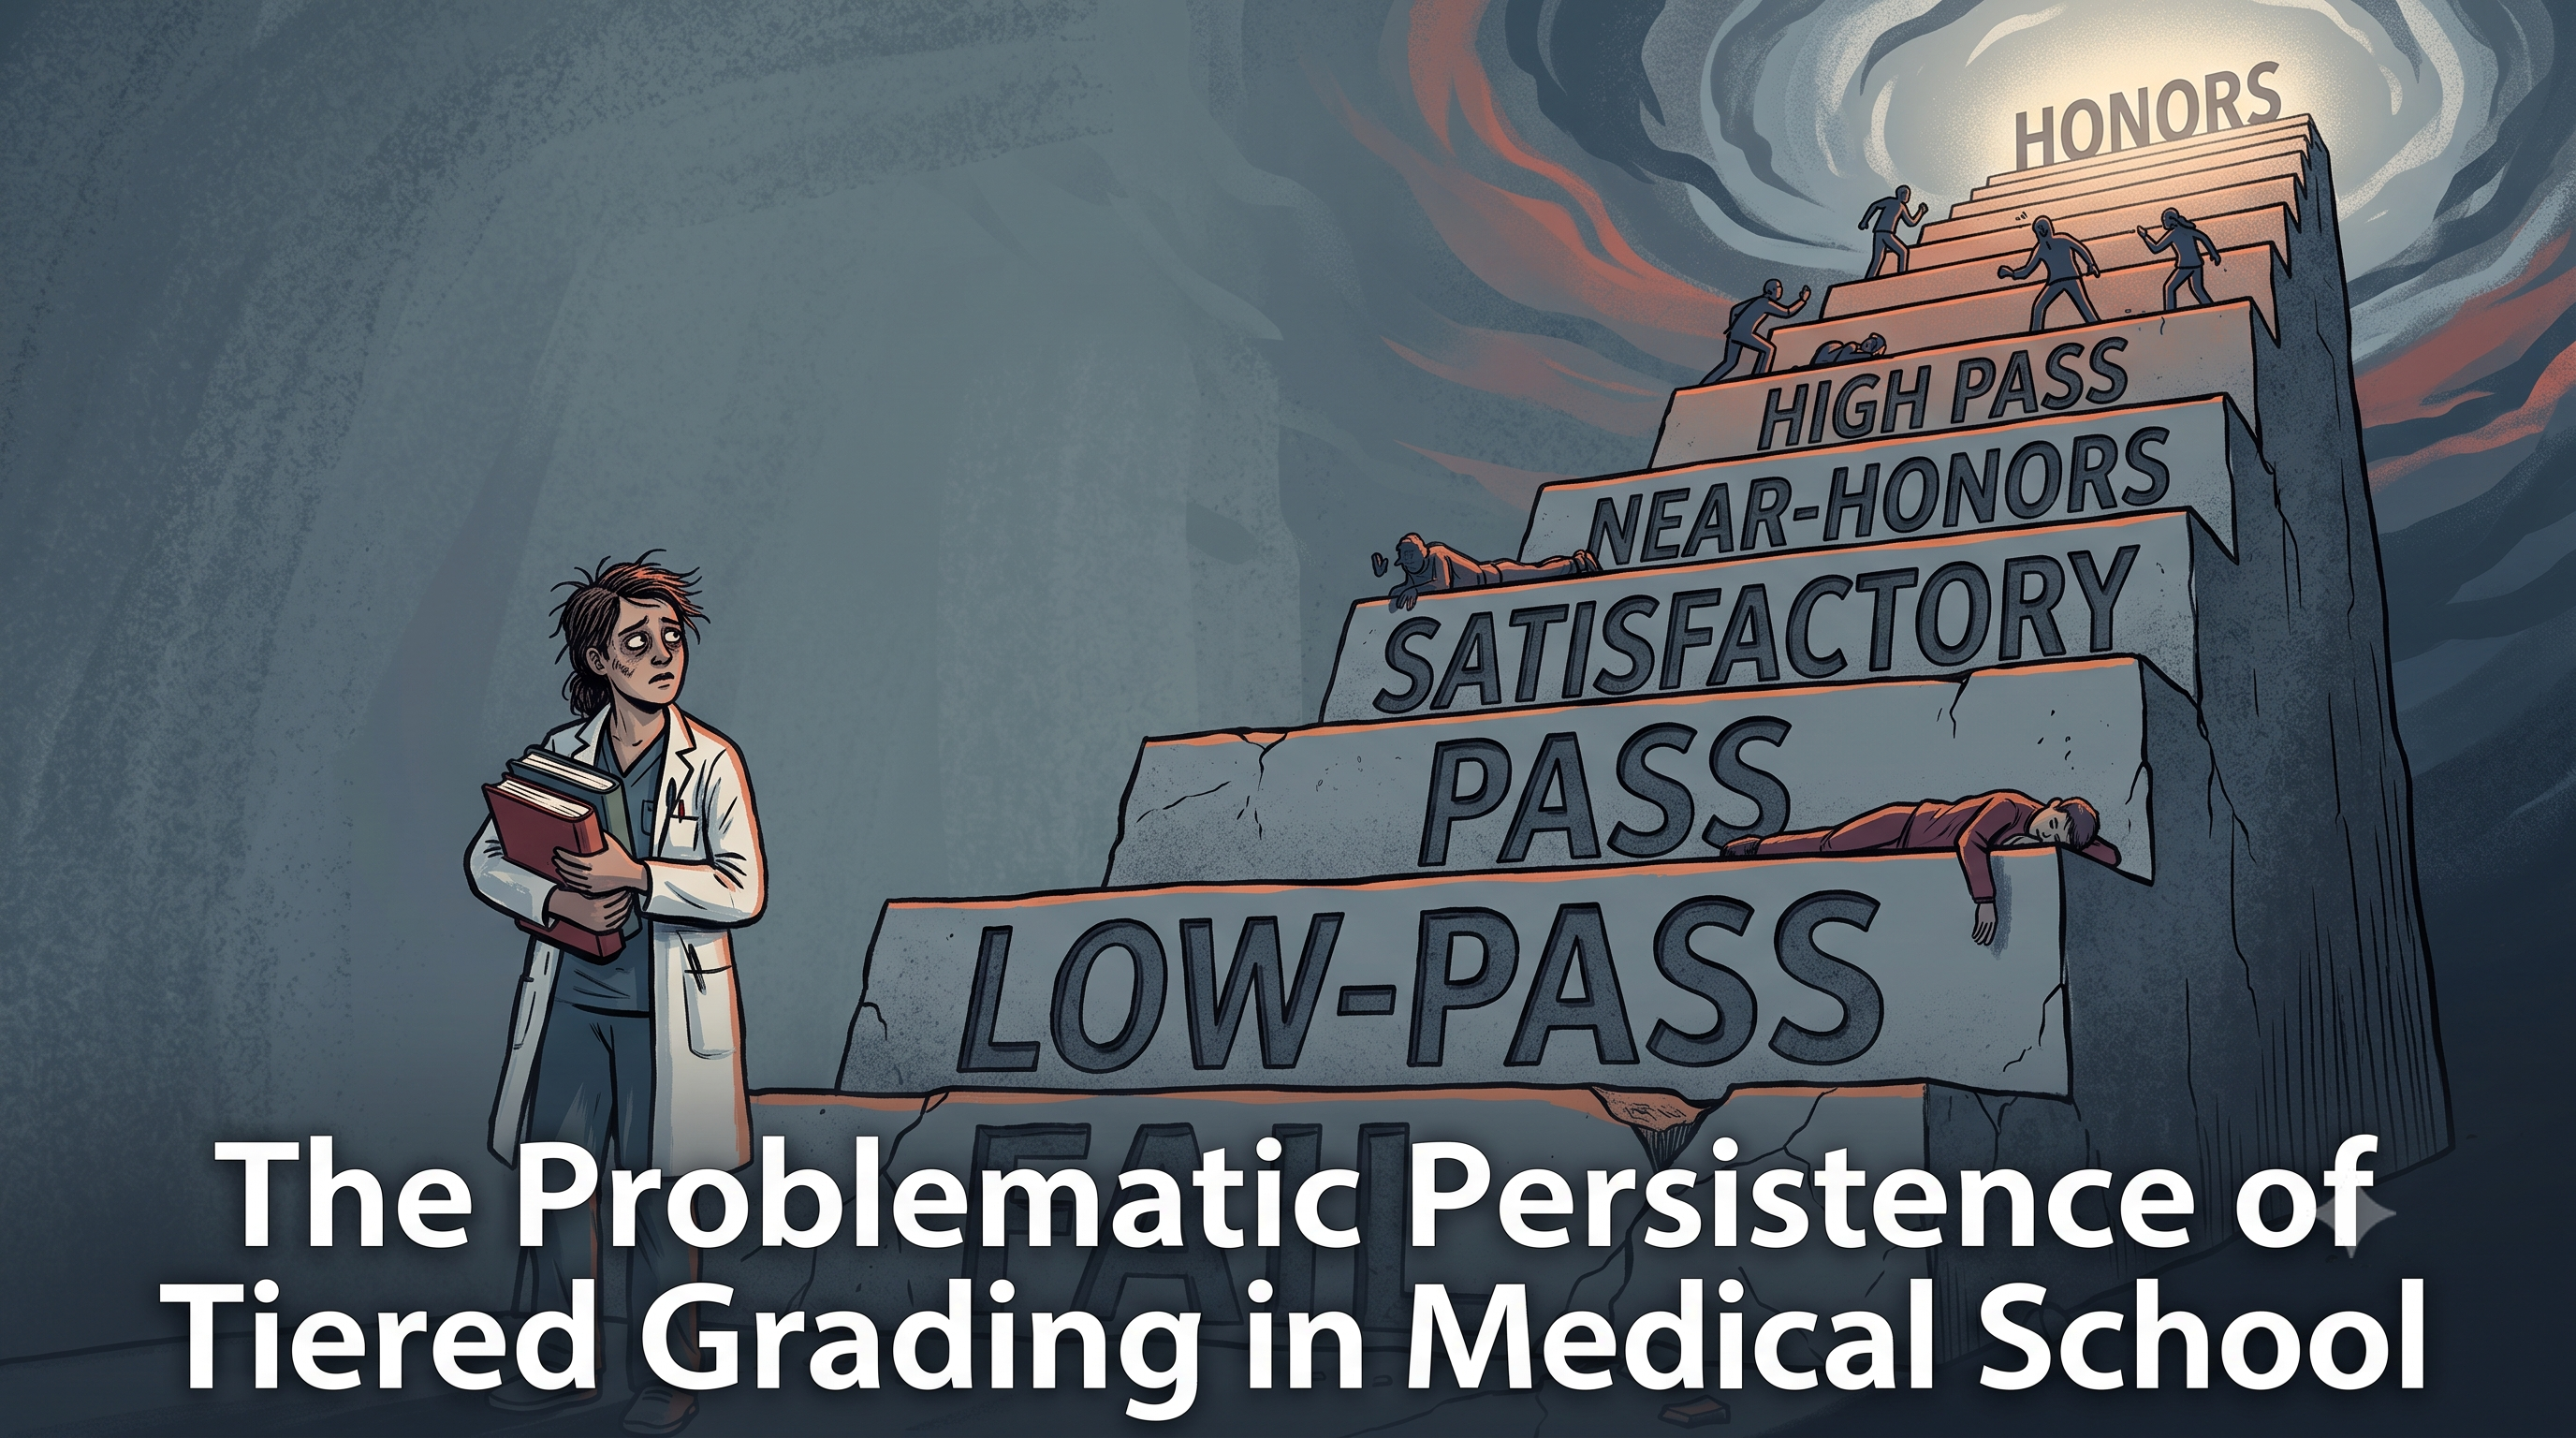
The Problematic Persistence of Tiered Grading in Medical School 


🏷️ 의대 성적 "우수·양호·통과", 왜 아직도 계속될까? 등급제 성적(Tiered Grading)의 문제적 지속성

📄 Smith JF Jr, Piemonte NM. The Problematic Persistence of Tiered Grading in Medical School. Teaching and Learning in Medicine. 2023;35(4):467–476. doi:10.1080/10401334.2022.2074423


안녕하세요! 지난번에 임상추론의 프로그램식 평가와 타당도를 다뤘는데요. 그 논문의 결과 추론(consequences) 이야기를 기억하시나요? 평가 결과를 어떻게 쓰느냐가 낳는 의도하지 않은 결과까지 타당도의 문제라는 거였죠. 오늘 소개할 논문은 바로 그 질문을 의대 성적 체계에 던져요.


미국 크레이턴대학교(Creighton University)의 의학교육학자 James F. Smith Jr. 와 의료인문학자 Nicole M. Piemonte가 쓴 관찰(Observation) 논문이에요. 새로운 데이터를 제시하는 연구가 아니라, 역사, 심리측정, 심리사회, 도덕의 네 측면에서 문헌을 검토하고 주장을 펴는 글이에요. 2023년에 나온 논문이라 앞에서 다룬 글들보다 조금 이르지만, 주제가 잘 이어져서 함께 읽어 볼게요.


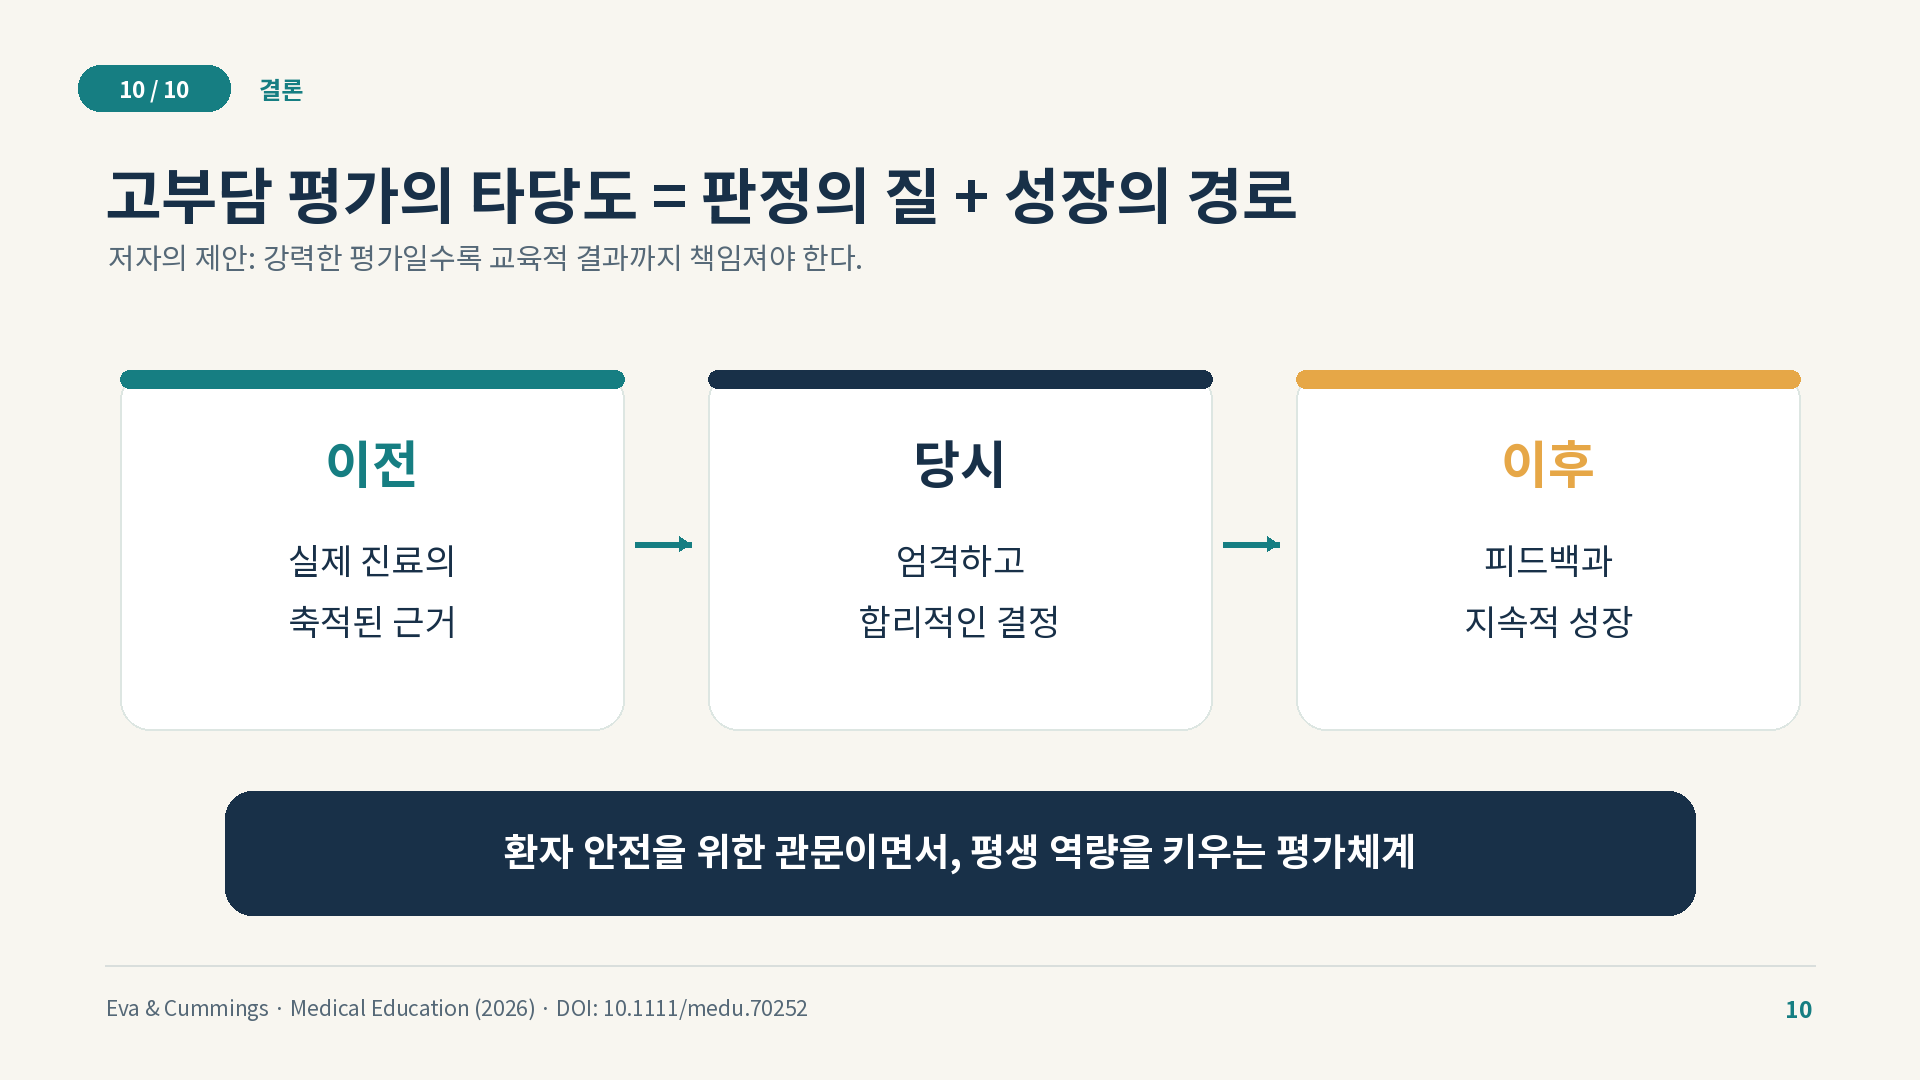
한 줄로 줄이면 이래요. "의대의 등급제 성적은 교육적 근거가 빈약한 대학의 관행에서 왔고, 학생의 정신건강, 협력, 다양성을 해친다는 증거가 쌓이고 있다. 등급제를 유지하려는 학교는 그 이유를 스스로 입증해야 한다."


📌 1. 등급제 성적이란?

저자들은 의대 평가를 크게 두 가지로 나눠요.

  • ✅ 비등급제(non-tiered): 정해진 기준을 충족했는지만 보는 합격/불합격(pass/fail)
  • 🏷️ 등급제(tiered): 수행 수준을 여러 범주로 나누는 방식. 석차, 학점(A, B, C), 점수, 그리고 "우수(honors)", "준우수(high pass)", "통과(pass)", "낙제(fail)" 같은 서술어

등급은 다시 두 가지 기준으로 나눌 수 있어요.

  • 규준참조(norm-based): 학생들을 서로 비교해서 등급을 매김
  • 준거참조(standards-based): 동료 집단의 수행과 상관없이 미리 정한 성취 수준을 기준으로 함

저자들이 주로 문제 삼는 건 학생을 서로 비교해서 줄 세우는 규준참조식 등급제예요.


🏛️ 2. 역사: 등급제는 어디서 왔나?

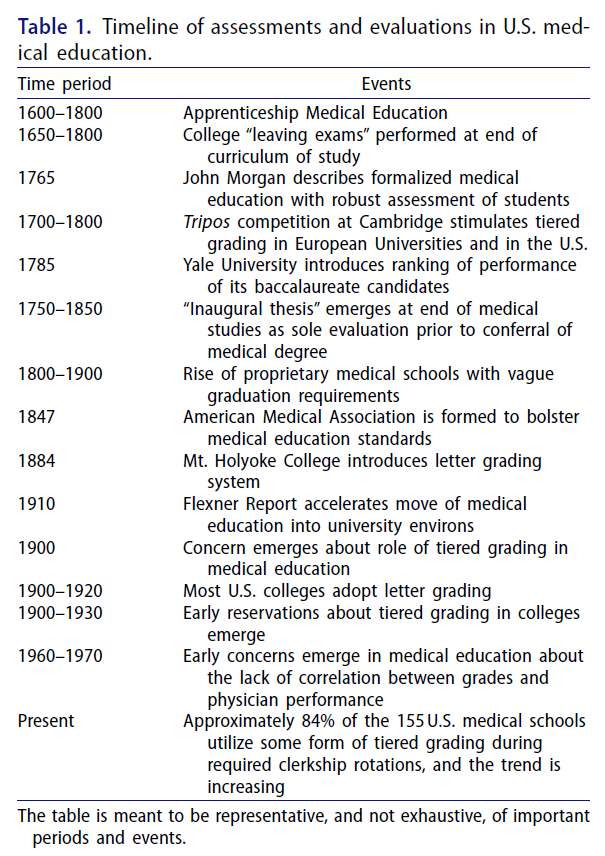
저자들은 먼저 등급제가 어떻게 의학교육에 들어왔는지 추적해요. 그 과정을 보면 교육적 근거가 생각보다 빈약하다는 거예요.

  • ① 도제식 교육 시대 🧑‍⚕️
    • 초기 미국 의사들은 한 명의 개업의 밑에서 몇 년 동안 도제식으로 배웠어요. 의술은 일종의 "기예(craft)" 였고, 역량의 증거는 이후 평판과 상류층 환자 명단이었어요.
  • ② 강의실 교육과 사설 의학교의 난립 🏫
    • 18세기 말에서 19세기로 오면서 강의 중심 교육이 늘었어요. 일부는 대학의 학과로 시작해서 대학 학부의 평가 방식, 곧 등급제를 그대로 따랐고요. 반면 우후죽순 생긴 사설 의학교(proprietary medical schools) 는 입학 기준도 느슨하고 평가도 엉성했어요. 학생을 낙제시키면 등록금 수입이 줄어드니 낙제는 거의 없었고요.
  • ③ 플렉스너 보고서(1910)와 대학 모델의 정착 📜
    • 1910년 플렉스너 보고서(Flexner Report) 가 미국 의학교육의 낮은 수준을 알리면서 사설 의학교가 몰락하고 대학 기반 의학교육이 자리 잡았어요. 그러면서 대학 학부의 행정, 재정, 교육 철학이 의학교육의 기본 틀이 됐죠.

암묵적으로, 등급제는 대학 환경에서 의대생 평가의 패러다임으로 받아들여졌다.
"Tacitly, tiered grading was accepted as the paradigm for medical student assessment in the university environment."

  • ④ 비판도 오래됐다 🗣️
    • 20세기 초부터 대학의 학문 환경을 의학교육에 그대로 들이는 것에 대한 비판이 있었고, 50여 년 전에도 이미 등급, 평점(GPA), 석차가 졸업 후 의사로서의 수행과 별 관계가 없다는 지적이 나왔어요.

저자들은 역사 검토를 이렇게 정리해요.

현재 의대생들은 미국 대학의 18~19세기 지배적인 학문 철학 안에서, 그리고 그 철학을 위해 개발된 구성물로 평가받고 있으며, 그것은 의대생들이 결국 몸담게 될 임상 실무를 위해 만들어진 것이 아니다.
"currently, medical students are assessed by a construct that was developed in and intended for the prevailing academic philosophies of the American universities of the 18th and 19th centuries, not the clinical practices in which medical students will eventually find themselves."


📊 3. 현황: 임상실습에서는 오히려 등급제가 늘고 있다

미국에는 의대생 평가에 대한 국가 표준이 없어서 학교마다 다른 체계를 써요. 그런데 흥미로운 흐름이 있어요. 최근 5년 동안 임상실습 전(pre-clerkship) 에는 합격/불합격이 늘고, 임상실습(clerkship) 에서는 등급제가 늘었다는 거예요.

2020년 AAMC 자료를 보면 차이가 뚜렷해요.

단계 합격/불합격 등급제
임상실습 전 125개교 42개교
필수 임상실습 11개교 141개교

임상실습에서 가장 흔한 방식은 "우수, 준우수, 통과, 낙제" 의 4단계예요.

🎈 등급 인플레이션 문제

등급제가 제 역할을 못 하는 이유 중 하나는 등급 인플레이션(grade inflation) 이에요.

  • 같은 학교 안에서도 과마다, 학교마다 기준이 달라요.
  • 임상실습 책임자의 40% 이상이 등급 인플레이션이 학생들이 더 좋은 수련병원에 가는 데 도움이 된다고 생각하고, 60% 는 합격/불합격 방식에 반대해요.
  • 20% 넘는 학교가 등급 분포를 정해 두지 않아요. 아이러니하게도 등급 분포를 정하지 않은 것이 최고 등급 비율을 높이는 유일한 유의미한 요인이었어요.
  • 등급을 더 세분화해도 인플레이션은 줄지 않고 오히려 늘 수 있어요.

또 하나의 문제는 타이밍이에요. 임상실습 등급은 대개 실습이 끝난 뒤 총괄평가로 나와요. 그러니 학생이 실습 중에 등급을 보고 기술을 보완하는 건 사실상 불가능하죠. 등급이 피드백으로 기능하지 못한다는 거예요.


⚖️ 4. 등급제를 유지하는 논리, 하나씩 따져 보기

등급제를 지지하는 전통적인 논리는 크게 두 가지예요. 학생의 노력을 자극한다는 것, 그리고 수련 프로그램이 전공의를 선발하는 데 도움이 된다는 것. 저자들은 둘 다 근거가 약하다고 봐요.

① "등급이 있어야 공부한다"?

실제로, 의대생이 등급제 같은 외적 요인으로 동기부여되어야 한다는 전제 자체가, 평생에 걸친 내재적 동기의 학습이라는 전문직의 근본적 요청을 위협한다.
"Indeed, even the premise that medical students must be motivated by extrinsic factors, such as tiered grading, threatens the underlying professional imperative of life-long, and intrinsically motivated, learning."

근거를 보면 이래요.

  • 등급제는 단기적으로 외적 동기를 높일 수 있지만, 외적 동기 요인(등급)을 없애면 전체 동기가 원래보다 낮아질 수 있어요.
  • 학생들의 공부 습관이나 독서량은 등급제의 영향을 받지 않았고, 국가 표준화 시험 성적도 마찬가지였어요.
  • 등급 대신 서술형 피드백을 주면 스트레스와 불안을 줄이면서 학업 동기를 높일 수 있다는 연구도 있어요.

그리고 저자들은 의학교육 개혁에서 동기 이론이 제대로 반영되지 않았다고 지적해요.

② "전공의 선발에 필요하다"?

  • 수련 프로그램 책임자 상당수는 성적을 "지금 그대로" 유지하길 원해요. 그런데 임상실습 등급으로 전공의 수행을 예측하는 연구 결과는 거의 50년 동안 일관되지 않았어요. 양의 상관을 보인 연구도 있고, 그렇지 않은 연구도 있죠.
  • 저자들은 여기서 날카로운 지적을 해요. "합격/불합격은 비판적으로 검증되지 않았으니 등급제를 유지해야 한다"는 주장이 있는데, 정작 등급제 자체도 비판적 검증 없이 역사적으로 들어왔다는 점은 무시한다는 거예요. 🤔

③ "스트레스도 수련의 일부"?

평가로 인한 스트레스를 실제 진료의 스트레스에 대비해 학생을 단련하는 과정으로 보는 시각도 있어요. 저자들은 이걸 강하게 비판해요.

등급제를 의례적이고, 불안을 유발하며, 의대생 형성에 필요한 것으로 규정하는 것은 신고식(hazing)의 여러 요소를 불러낸다.
"Framing tiered grading as ritualistic, angst-provoking, and necessary in the formation of medical students invokes many of the elements of hazing."

그리고 이렇게 이어가요.

숙달이 회상을 평가하는 표준화 시험으로 측정될 때, 공감, 연민, 참여, 결속, 판단처럼 의료 실무의 숙달에 필요하고 현대 의학에서 성공하는 데 더 중요하다고 할 수 있는 속성들은 덜 평가되고, 따라서 덜 가치 있게 여겨질 것이다.
"When 'mastery' is measured by standardized tests assessing recall, then those attributes of mastery in the practice of medicine that require compassion, empathy, engagement, cohesiveness, and judgment—arguably more important for success in modern medicine—will be under-evaluated, and thus undervalued."


"측정되는 것이 가치 있게 여겨진다" 는 오래된 격언이 떠오르는 대목이에요.


😰 5. 심리사회적 맥락: 스트레스, 숨은 교육과정, 불평등

💔 가장 강력한 교육과정 스트레스 요인

실제로, 등급제는 현대 의학교육 환경에서 스트레스, 번아웃, 정서적 소진의 가장 강력한 교육과정 요인 중 하나이거나, 어쩌면 가장 강력한 요인으로 보인다.
"Indeed, tiered grading appears to be one of the strongest, if not the strongest, curricular source of stress, burnout, and emotional exhaustion in the contemporary medical educational environment."


등급제는 경쟁을 높이고 집단 결속을 낮춰요. 반대로 등급제를 없앤 곳에서는 이런 변화가 보고됐어요.

  • 😌 우울, 불안, 격차 감소
  • 🤝 협력, 집단 결속, 전문직 정체성 증가
  • 🏥 임상실습에서 필기시험 공부하느라 병동을 비우는 대신 임상 몰입, 환자·교수와의 접촉, 임상추론 능력 향상 가능성
  • ⚖️ 학생들의 공정성 인식 향상

🎭 숨은 교육과정과 등급제

저자들은 등급제가 숨은 교육과정(hidden curriculum) 을 강화한다고 봐요. 교수들은 "좋은 의사가 되는 데는 성적보다 훨씬 많은 것이 필요하다"고 말하지만, 학생들이 보기엔 현실이 다르다는 거예요.

"의사가 되는 데는 좋은 성적을 받는 것보다 훨씬 더 많은 것이 있다"는 격언은, 자신의 가까운 미래와 진로가 주로 성적, 국가면허시험 점수, 임상실습 전후의 평가로 결정된다는 것이 의대생들에게 분명해지는 순간 회의, 불신, 무시에 부딪힌다.
"The adage, 'There is much more to becoming a doctor than getting good grades' is met with skepticism, distrust, and dismissiveness when it becomes apparent to medical students that their immediate future and career path will be determined primarily by their grades, national licensure exam scores, and evaluations in the pre-clerkship and clerkship years of medical education."


결국 등급제는 의도했든 아니든 학생들의 진로 선택 자격을 자의적으로 층화하면서, 무엇이 정말 중요한지에 대한 암묵적 메시지를 전한다는 거예요.

⚖️ 인종적 불평등

저자들이 "가장 중요하다" 고 강조한 부분이에요.

아마 가장 중요한 것은, 등급제가 인종적 불평등과 관련된 것으로 보인다는 점이다. 인지적 수행 같은 변수를 통제해도 과소대표 소수자(URM)가 더 낮은 평가를 받는다.
"Perhaps most importantly, tiered grading appears to be associated with racial inequalities, in which URM receive lower evaluations even when variables such as cognitive performance are controlled."


이런 차이는 명예학회 가입, 수련 기회, 전공 선택으로 이어져서 다양한 의사 인력을 만드는 데 걸림돌이 돼요.


🧭 6. 도덕적 맥락: 교육자의 딜레마와 도덕 발달

⚖️ 판단하지 않으면서 판단해야 하는 교육자

교육자와 학생 사이에는 권력 불균형이 있고, 등급을 매기는 건 결국 교수의 몫이에요. 게다가 교육자는 분명한 이해상충에 놓여 있어요.

의학교육자이자 멘토는 학생과 안전하고 지지적이며 형성적인 관계를 맺기 위해 비판단적이어야 한다. 하지만 의학교육자는 학생의 역량을 비판적이고 정직하게 평가하는 데 있어서는 판단적이어야 하기도 하다.
"The medical educator/mentor must remain non-judgmental to form a safe, supportive, and formative relationship with the student/protégé. However, the medical educator must also be judgmental in critical and honest assessment of the competencies of students."


지난번 교육 동맹 논문에서 본 "코치이자 심판" 문제와 똑같은 이야기죠. 여기에 교수들도 학생에게 강의평가를 받으니, 박한 평가를 주면 자기 평가가 나빠질 수 있다는 부담까지 있어요. 이게 임상실습에서 교수들이 낮은 평가를 주길 꺼리는 이유 중 하나일 수 있다고 해요.

🧒 도덕 발달의 정체

저자들은 콜버그(Kohlberg)의 도덕 발달 이론을 끌어와서 꽤 과감한 주장을 해요.

낮은 석차의 수치심을 피하고, 인정을 얻고, 임상실습 전후 교수들에게 충성을 보이려는, 등급제가 만든 학업적 유인은 전인습적 및 인습적 도덕 단계의 특징이다. 이러한 도덕 단계는 대개 아동기와 청소년기와 연관된다.
"Academic incentives established by tiered grading to avoid the shame of low ranking, gain approval, and demonstrate loyalty to pre-clerkship and clerkship faculty characterize the preconventional and conventional moral stages. These moral stages are typically associated with childhood and adolescence."


부적절한 학업 유인이 인간의 존엄과 권리를 원칙으로 삼는 후인습적(post-conventional) 단계로 나아가는 걸 막을 수 있다는 거예요. 그래서 교수와 기관은 학생의 도덕 발달을 위협하는 요소를 적극적으로 없애야 한다고 말해요.


🌱 7. 등급제를 넘어서: 대안은?

🎯 기준을 낮추자는 게 아니다

저자들은 오해를 막으려고 분명히 해요.

분명히 하자면, 우리는 학생들이 높은 기준을 적용받지 않아야 한다고 제안하는 것도, 높은 기준이 충족되는지 확인하기 위해 학생들을 더 이상 시험 보지 않아야 한다고 주장하는 것도 아니다.
"To be clear, we are not suggesting that students ought not be held to high standards, nor are we arguing that students should no longer be tested in order to assure high standards are being met."


오히려 시험 강화 학습(test-enhanced learning) 은 엄격한 시험을 학습 도구로 계속 써야 하는 강력한 근거라고 봐요. 다만 평가는 학생을 줄 세우고, 등급 매기고, 분류하는 데 쓰일 게 아니라, 다양하고 전인적으로 훈련된 의사 인력을 만든다는 기관의 헌신 속에서 쓰여야 한다는 거예요.

📐 타당도는 "결과"까지 포함한다

지난번 Runyon 논문과 직접 이어지는 부분이에요. 저자들은 타당도는 도구의 속성이 아니라 결과의 해석과 추론의 속성이라는 점을 상기시키면서, Cook 등의 말을 인용해요.

"평가의 의도한 결과나 의도하지 않은 결과를 평가하면 이전에 알아차리지 못한 비타당성의 원천이 드러날 수 있다."
"evaluating intended or unintended consequences of an assessment can reveal previously unnoticed sources of invalidity."


예를 들어 번아웃 감소, 경쟁 완화, 집단 결속이 의학교육의 중요한 성과라면, 이 영역에서 등급제가 낳는 부정적 결과는 등급제의 타당도 자체를 위협한다는 거예요. 특정 소수자 집단이 일관되게 낮은 점수를 받는다면 그것도 마찬가지고요.

🏥 작업장 기반 평가와 서술형 평가

  • 작업장 기반 평가(WBA) 가 복잡하고 변화하는 실제 진료 환경의 평가와 더 잘 맞는다고 봐요.
  • 서술형 평가는 객관성 중심 평가보다 실행 가능한 피드백을 주고, 임상 진료를 위임하는 결정에도 도움이 될 수 있어요.

그런데 저자들은 대안에도 한계가 있다는 걸 솔직히 인정해요.

하지만 합격/불합격과 서술 중심의 평가 과정도 완벽하지 않으며, 편향이나 과소대표 소수자 학생에게 불리한 평가에서 자유롭지 않다는 점을 말해 두어야 한다.
"It should be said, however, that a pass/fail, narrative-driven assessment process is not infallible and is not immune to bias or disfavoring URM students."


그래서 어떤 평가든 의도하지 않은 결과를 계속 검토해야 하고, 타당도 평가는 지속적인 과정이어야 한다고 해요.

🎓 학점(credit) 기반 체계와 낙제시킬 용기

저자들은 필수 경로와 개별화된 경로에서 역량을 입증하면 "학점(credits)" 을 주는 체계도 제안해요. 합격/불합격과 결합하면 스트레스를 줄이고, 웰빙을 높이고, 평생학습에 맞는 숙달 지향 학습을 도울 수 있다는 거예요.

그리고 합격/불합격 체계에서는 교수에게 용기가 필요하다고 강조해요.

의학교육자는 학생들을 최선을 다해 의료 실무에 준비시켜야 하며, 동시에 역량 기준을 충족할 수 없는 학생들을 낙제시킬 준비가 되어 있어야 한다.
"Medical educators must prepare students as best they can for the practice of medicine, and at the same time be prepared to fail those students incapable of meeting competency standards."


임상실습에서 낙제는 역사적으로 아주 드문 일이었기 때문에, 이건 의도적인 노력이 필요하다고 해요.


✅ 8. 결론: 입증 책임을 뒤집자

저자들은 이상적인 평가를 이렇게 정의해요. 안전하고 효과적인 진료에 필요한 모든 기술의 진척을 비판적으로 평가하면서, 동시에 미래 의사 인력의 개인적 관심, 기여, 다양성을 증진하는 평가. 그리고 짧지만 분명한 한 문장을 덧붙여요.

그것은 의대생을 개인적으로도 집단적으로도 해쳐서는 안 된다.
"It must not harm medical students personally or collectively."


마지막 문단은 입증 책임을 뒤집자는 제안이에요.

적어도, 등급제를 유지하는 학교는 등급제와 연관된 해로운 효과를 고려할 때 그러한 모델의 사용을 옹호하도록 요구받아야 한다. 이러한 부정적 효과를 해결하지 않고 두는 것은 그것이 용인될 수 있다는 인식을 주며, 의학교육에서 등급제의 문제적 지속을 암묵적으로 지지하는 것이다.
"At the very least, those schools that retain tiered grading systems must be called to defend their use of such models, given the deleterious effects with which tiered grading has been associated. Leaving these negative effects unaddressed gives the perception that they are acceptable and tacitly supports the problematic persistence of tiered grading in medical education."


💡 9. 읽으며 든 생각과 한국 의학교육에 주는 시사점

마지막으로 제 생각을 덧붙일게요. 어디까지나 제 해석이에요.

  • ① 우리 의대의 성적 체계를 다시 보기 🔍
    • 우리 의과대학도 대부분 학점제와 석차를 쓰고, 이 성적이 인턴이나 전공의 선발에 반영되는 경우가 많은 것으로 알고 있어요. 이 논문의 질문을 우리에게 적용해 보면 이래요. 우리 성적 체계는 무엇을 위해 존재하나? 학습을 돕기 위해서인가, 선발을 위한 분류 도구인가? 만약 후자라면, 그 분류가 실제로 이후 수행을 예측하는지, 그리고 그 과정에서 어떤 대가를 치르고 있는지 따져 볼 필요가 있을 것 같아요.
  • ② 임상실습 평가의 "타이밍" 문제 ⏰
    • 실습이 끝난 뒤에 등급만 통보되면 피드백으로서의 가치가 거의 없다는 지적은 바로 적용할 만해요. 등급제를 유지하든 아니든, 실습 도중에 형성 피드백이 이뤄지는 구조가 먼저 필요하다는 이야기죠.
  • ③ 앞의 글들과 이어서 보기 🔗
    • Runyon 등의 타당도 논문: 등급제의 해로운 결과는 결과 추론의 문제이고, 여러 점수를 합산해 등급을 매기는 방식은 합산의 함정과도 연결돼요.
    • 교육 동맹 논문: 교육자가 코치이면서 심판이어야 하는 긴장이 두 논문에서 똑같이 등장해요.
    • AAMC 기초역량과 CBHPE: 역량바탕교육은 학생들을 서로 비교하기보다 기준 대비 성취를 보는 방향이라, 규준참조식 등급제와는 기본 철학이 잘 맞지 않아요.
  • ④ 비판적으로 읽을 지점 🤔
    • 이 글은 관찰(Observation) 논문이라 체계적 문헌고찰이 아니에요. 등급제에 불리한 근거를 중심으로 논지를 펴는 주장 글이라는 점을 감안해서 읽어야 해요.
    • 인용된 근거 중에는 오래된 연구나 관찰 연구가 적지 않아요. 등급제가 정신건강 문제나 인종적 격차의 원인이라는 인과적 결론을 내리기에는 조심스러운 부분이 있어요.
    • 콜버그 이론을 들어 등급제가 도덕 발달을 정체시킨다는 주장은 흥미롭지만, 경험적 근거보다는 이론적 추론에 가까워요.
    • 선발의 문제는 여전히 남아요. 등급을 없애면 수련 프로그램은 무엇으로 지원자를 구별할까요? 미국에서 USMLE Step 1이 합격/불합격으로 바뀐 뒤 경쟁이 다른 지표로 옮겨 갔다는 지적도 있는데, 이 논문은 이 질문에 대한 답은 충분히 다루지 않았어요.
    • 미국 맥락의 논의라서 URM의 범주나 수련 선발 구조가 우리와 다르다는 점도 염두에 둘 필요가 있어요.

📝 정리하며

  • 의대의 등급제 성적은 교육적 근거보다는 18~19세기 대학 학부의 관행에서 왔어요.
  • 미국에서는 임상실습 전에는 합격/불합격이 늘었지만, 임상실습에서는 오히려 등급제가 대세예요. 등급 인플레이션과 학교별 편차로 정확성도 떨어져요.
  • "동기를 자극한다", "선발에 필요하다", "스트레스도 수련이다"라는 유지 논리는 근거가 약하거나 신고식의 논리와 닮았다고 비판해요.
  • 등급제는 스트레스와 번아웃, 경쟁, 숨은 교육과정, 인종적 불평등과 관련이 있다는 증거가 쌓이고 있어요.
  • 교육자는 판단하지 않으면서 판단해야 하는 딜레마에 놓이고, 등급제의 유인은 도덕 발달을 방해할 수 있어요.
  • 대안은 기준을 낮추는 게 아니라 합격/불합격, WBA, 서술형 평가, 학점 기반 체계와 낙제시킬 용기예요. 다만 대안도 편향에서 자유롭지 않으니 결과를 계속 검토해야 해요.
  • 결론은 입증 책임의 전환이에요. 등급제를 유지하려는 학교가 그 이유를 스스로 입증해야 한다는 거죠.

함께 읽으면 좋은 글로는 Hauer & Lucey(2019), "Core clerkship grading: the illusion of objectivity"(Acad Med 94:469–472), 그리고 Lucey 등(2020), "Medical Education's Wicked Problem: Achieving Equity in Assessment for Medical Learners"(Acad Med 95(12S):S98–S108) 를 추천해요. 📎


매년 미국의 의학박사 학위 수여 의과대학(allopathic medical schools)에서는 약 2만 명의 학생이 졸업한다.1 이들은 의과대학에 재학하는 동안 엄격한 교육과정과 중요하고 복잡하며 논쟁적인 평가 과정을 거친다. 최근 이 과정에 관심이 집중되었음에도 현재 인가를 받은 미국의 의학박사 학위 수여 의과대학 155곳에는 통일된 평가 체계가 없다.1 많은 학교가 역량(competencies)에 초점을 맞추지만, 역량을 성공적으로 습득하고 입증했는지를 분류하는 방식은 다양하다.

  • 가장 기본적인 수준에서는 의과대학생이 진급에 필요한 인지적·기술적 능력을 습득하고 입증했는지에 따라 ‘합격(pass)’ 또는 ‘불합격(fail)’으로 판정하며, 성취도를 더 세분하지 않는다.
  • 그러나 문자 성적(letter grades), 숫자 점수(numeric scores), 석차(class ranking), ‘최우수(honors)’, ‘우수(superior)’, ‘상위 합격(high-pass)’, ‘최우수 근접(near-honors)’, ‘만족(satisfactory)’, ‘하위 합격(low-pass)’ 같은 기술어(descriptors)를 사용하는 추가적인 등급 범주 체계도 존재하며, 각 학교는 자체 기준에 따라 이를 다양하게 적용한다.2–5

의학교육에서 등급별 성적평가 체계가 형성·발전한 역사적 토대를 살펴보면 그 발전의 바탕이 된 원칙이 명확해지고 오늘날의 적용 방식도 더 잘 이해할 수 있으리라 기대할 수 있다. 그러나 우리의 검토에 따르면, 의과대학 성적평가 체계는 인지적·심리사회적 기술의 습득, 전문직 정체성 형성(professional identity formation), 의료행위에 필요한 판단력을 돕는 원칙보다는 취약한 교육학적 전제와 학생의 등급별 성적이나 서열을 통한 경쟁적 평가를 강조하는 대학 환경의 학문적 통념에 기반해 왔다.6–9 또한 우리의 검토는 의학교육에서 등급별 성적평가의 사용과 효과가 적절한 평가 방식인지에 관해 한 세기 넘게 의문이 제기되어 왔음을 보여준다.6–10 이러한 성적평가 체계가 의학교육에서 계속 사용되는 상황에는 학생의 안녕(well-being)11,12과 다양성13–15에 미치는 해로운 영향, 표준화된 의사면허시험(standardized licensing examination)16,17 또는 역사적으로는 성공적인 의료행위9와 유의한 상관관계가 없다는 점을 보여주는 문헌의 축적이 맞물려 있다. 우리는 이 관찰 논문(Observations article)에서 이러한 문제를 다루고자 한다.

의학교육과 학생 평가의 역사적 관점 (Historic perspective of medical education and student assessment) 

역사적으로 미국 초기 의사의 교육과 수련은 학생 한 명이 개업의 한 명의 지도를 받는 도제식 경험(apprenticeship-based experience)으로 이루어졌다.18,19 이러한 ‘교육’은 식민지 주민과 신생 미국 시민의 필요를 충족했지만, 실용성에 기반했고 의료행위를 하나의 ‘기술(craft)’로 규정했다.19,20 수련생은 개업의와 함께 여러 해를 일했고, 결국 독립적으로 진료하는 것이 성공적인 성장의 표지였다. 이후 의사가 얻은 평판은 역량의 증거였으며, 상류층 고객을 확보한 것은 전문직으로서 성취했다는 증거로 여겨졌다.18


18세기 말과 19세기에 미국 의학교육이 발전하면서 강의실 기반 의학교육(classroom-based medical education)의 효율성이 분명해졌다.19 학생들은 주로 현직 의사로 구성된 소수 교수진의 강의를 통해 집단으로 교육받았다.19 이 방식은 학생에게 더 짧은 교육기간을, 교수진에게 사회적 명성과 경제적 유인을 제공했다. 일부 의과대학은 대학 내 학과로 출발했지만,21 학문 지향적인 이들 학과의 발전 속도는 독립적인 영리 의과대학(proprietary medical schools)의 증가세를 따라가지 못했다.19

  • 대학 소속 의학과의 학생 평가는 당시 대학 학부생에게 적용하던 평가 방식에 따랐으며,22 여기에는 등급별 성적평가도 포함되었다.8,23
  • 반면 영리 의과대학은 느슨한 입학 기준, 체계 없는 교육과정, 의심스러운 학생 평가를 갖고 있었다.20 영리 의과대학에서 낙제하는 일은 드물었다. 낙제는 교수진의 등록금 수입 감소로 이어졌고, 가장 저렴하고 빠르게 의료행위에 진입할 길을 찾는 지원자들의 외면을 받을 위험도 있었기 때문이다.20

의학교육이 도제식에서 공식적인 대학 기반 교육으로 옮겨가기 시작한 기원은 1847년 미국의사협회(American Medical Association)의 설립으로 거슬러 올라간다.20 그러나 미국 의학교육의 열악한 수준을 일반 국민에게 알린 것은 1910년 에이브러햄 플렉스너(Abraham Flexner)가 카네기재단(Carnegie Foundation)에 제출한 보고서였다.20,24 이 보고서는 영리 의과대학의 쇠퇴를 가속하고 대학 기반 의학교육의 중심적 지위를 확고히 했다. 그 결과 대학 학부 교육과정의 지배적인 행정적·재정적 철학, 그리고 무엇보다 교육학적 철학이 의학교육의 기본 틀로 자리 잡았고 대학 총장들은 이를 강하게 옹호했다.25 대학 환경에서 등급별 성적평가는 묵시적으로 의과대학생 평가의 전형으로 받아들여졌다.


그러나 20세기 초에는 대학의 학문적 환경이 의학교육에 강요된다는 비판이 나타났고,26 대학 학부과정의 등급별 성적평가와 석차에 대한 일반적인 비판도 등장했다.27–30 의과대학에서 학생 평가의 적절한 형태와 역할을 둘러싼 최근 논쟁은 50년도 더 전에 이미 뚜렷한 뿌리를 두고 있었다. 당시에도 의과대학생의 등급별 성적, 평점 평균(grade-point averages), 석차는 졸업 후 의사로서의 궁극적인 수행과 거의 관련이 없다는 사실이 인식되었다.9,31


따라서 미국 의과대학생 평가의 역사에 대한 이 짧은 검토는, 현재의 의과대학생이 장차 일하게 될 임상현장이 아니라 18·19세기 미국 대학의 지배적인 학문적 철학 속에서 개발되고 그것을 위해 설계된 체계로 평가받고 있음을 시사한다.

현재의 평가 모형과 추세 (Current assessment models and trends) 

오늘날 의과대학생 평가 모형은 성격, 규준(normative standards), 적용, 활용 면에서 다양하다.32–35 그러나 모든 의과대학 졸업생은 재학 기간 내내 어떤 형태로든 평가를 받았다. 크게 보면 이러한 평가 방식은 인지적 또는 기술적 역량을 입증하기 위한 정해진 기준을 포함하는 비등급별 방식(합격/불합격)과, 수행 수준의 범주를 구별하기 위해 층화(stratification)를 설정하는 등급별 방식으로 나뉜다. 후자에는 석차, 문자 성적, 숫자 점수, ‘최우수(honors)’, ‘상위 합격(high pass)’, ‘합격(pass)’, ‘불합격(fail)’ 등 등급을 구분하는 질적 기술어가 포함된다. 구분하는 등급 범주는 학생을 서로(또는 다른 코호트를 집합적으로) 비교하는 규준 기반 자료(normative data)에 근거할 수도 있고, 코호트의 수행과 독립적으로 사전에 성취 또는 역량 수준을 명시한 기준 기반(standards-based)일 수도 있다.


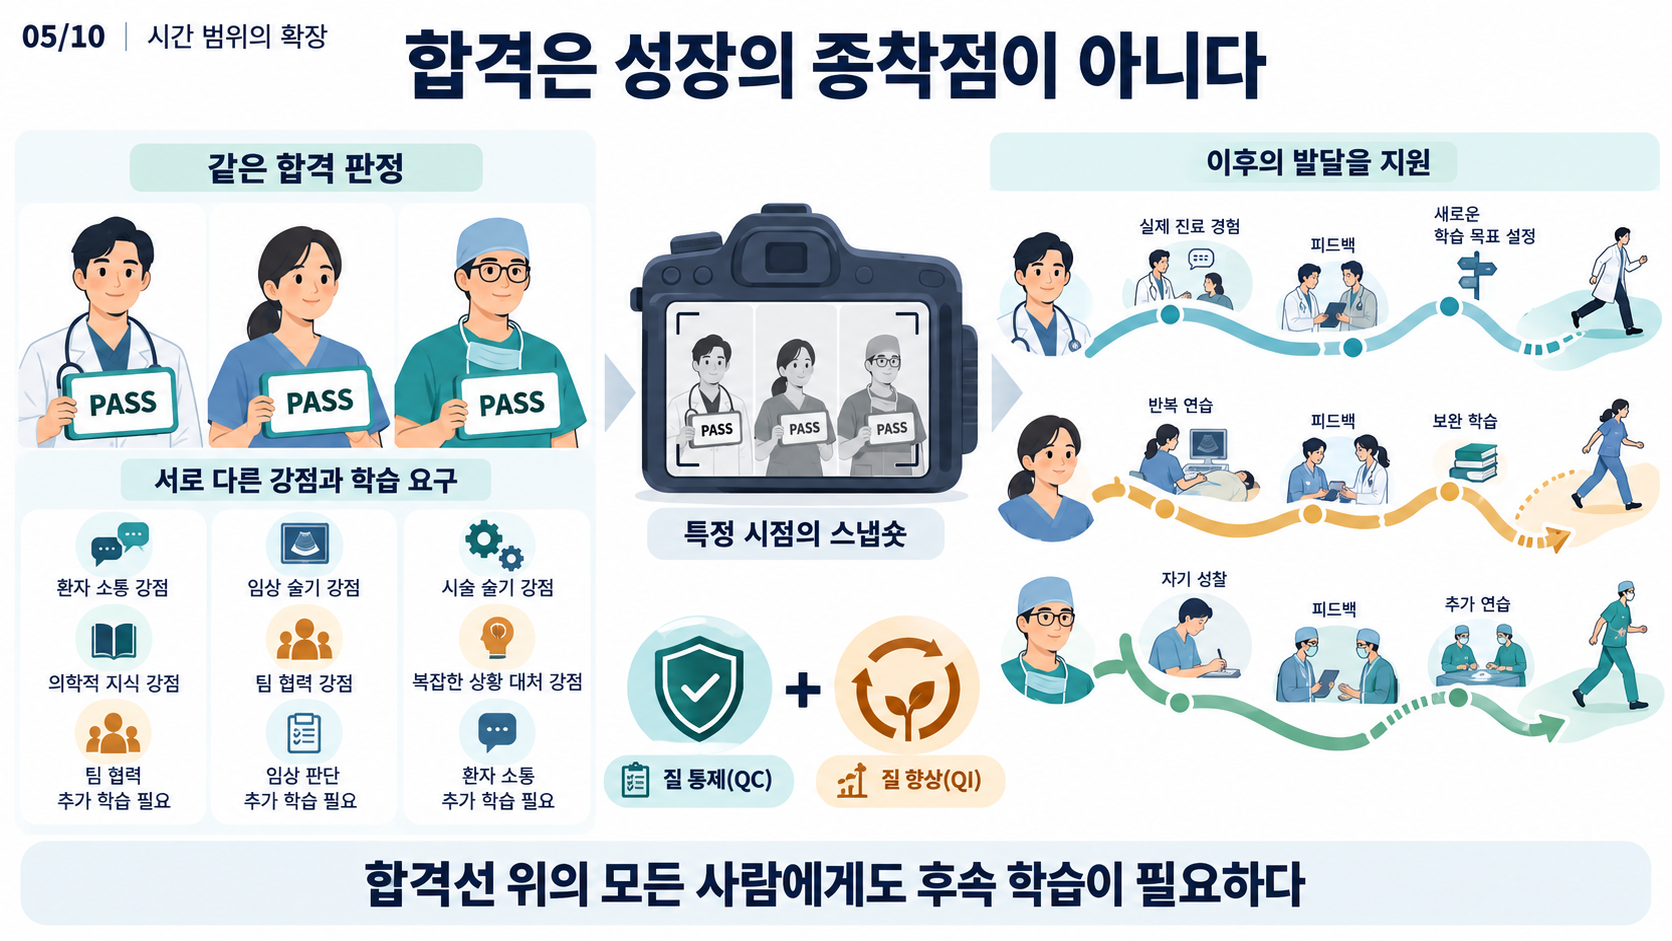
지난 5년 동안 임상실습 전 교육과정(pre-clerkship years)에서는 합격/불합격 성적평가의 사용이 해마다 늘었고, 임상실습 교육과정(clerkship years)에서는 등급별 성적평가의 사용이 해마다 늘었다.33,34 2020년에 끝난 학년도에는 의과대학 125곳이 임상실습 전 교육에서 합격/불합격 체계를 사용했고, 42곳은 어떤 형태로든 등급별 성적평가 체계를 사용했다.34 반면 필수 임상실습(required clerkships)에서 합격/불합격 평가 체계를 사용한 의과대학은 11곳뿐이었고, 141곳은 등급별 체계를 사용했다.34 가장 흔한 임상실습 평가는 ‘최우수(honors)’, ‘상위 합격(high pass)’, ‘합격(pass)’, ‘불합격(fail)’의 네 범주로 이루어졌다. 한 학교 안에서 서로 다른 평가 체계를 사용하는 경우, 필수·선택 여부와 관계없이 임상실습 전 과목과 임상실습 과목을 경계로 나뉘는 경우가 가장 흔해 보인다.


의과대학생 평가에 관한 국가적 표준은 없으며, 각 학교가 사용할 평가 체계를 결정한다.

  • 의과대학은 흔히 임상실습 전 과목(예: 기초과학 또는 장기계통 과목)에 한 체계를 쓰고, 임상실습이나 임상 과목에는 다른 체계를 쓴다.34
  • 의과대학 안팎의 성적평가 방식이 다양하므로 학생들이 이를 주관적이고, 많은 경우 불공정하다고 느끼는 것은 이해할 만하다.36–39
  • 등급별 성적평가 체계의 효과성과 적절성에 관해 과거부터 현재까지 의견이 다양한 것도 놀랍지 않다.40–44

개별 의과대학이 임상실습 전 교육과 임상실습 교육 사이에서 평가 방식을 바꾸는 구체적인 이유는 여러 요인이 복합적으로 작용하기 때문일 것이다. 그럼에도 이러한 변화는 흔하다.34 등급별 성적평가는 졸업후의학교육(graduate medical education, GME) 프로그램 지원자의 임상 능력과 판단력(clinical ability and acumen)을 가려내려는 전공의 수련 프로그램에 도움이 될 수 있다.35,41,45,46 이는 역량을 평가할 뿐 아니라 수행 수준을 층화함으로써 이루어진다고 한다.42 임상 수행에 대한 등급별 성적평가는 학생이 졸업 후 전공의 수련을 준비하면서 임상 기술을 향상할 기회를 찾는 데 도움이 될 수 있다. 그러나 등급별 성적은 흔히 총괄평가(summative assessment) 결과이며, 학생이 임상실습을 마친 뒤에야 공개된다. 이 때문에 임상실습 중 등급별 성적을 바탕으로 특정 전문과목에 필요한 기술을 높이는 일은 어렵거나 불가능하다. 이러한 체계에서 학생들은 일반적으로 임상실습 중이 아니라 종료 후에 총괄평가로서 등급별 성적의 형태로 피드백을 받는다.


임상 판단력에 대한 평가로서 임상실습의 등급별 성적평가는 학생이 전공의 지원 과정을 거칠 때 유리한 모습으로 보이게 하는 경향이 있다.14 의과대학 임상실습 학년에서 부여되는 성적의 기준은 한 학교 안의 임상실습끼리도, 학교 사이에서도 다르다.2,5,12,32 또한 임상실습 성적은 현재에도, 역사적으로도 성적 인플레이션(grade inflation)이 특징이다.2,31,32,35,44 이는 등급별 성적평가의 전반적인 정확성과 활용 가능성을 떨어뜨린다. 그런데도 임상실습 책임자의 40% 이상은 성적 인플레이션이 학생이 더 선호하는 전공의 수련 자리를 얻는 데 도움이 된다고 생각하고, 60%는 ‘합격/불합격’ 체계의 사용에 반대한다.35 대부분의 의과대학이 임상 교육과정에서 등급별 성적의 전체 분포를 명시하지만, 20% 이상은 명시하지 않는다. 따라서 이들 학교 지원자의 ‘최상위 성적(top grade)’이 다른 지원자에 비해 얼마나 두드러진 성취인지 불분명하다. 역설적으로, 성적 분포를 명시하지 않는 것은 ‘최상위 성적’ 부여 비율이 더 높은 것과 유의하게 관련된 유일한 요인으로 확인되었다. 이는 성적 인플레이션을 부추기고 실제 성취도를 해석하기 어렵게 한다.35 성적평가 체계에 등급을 더 많이 추가해도 이에 수반되는 성적 인플레이션이 줄어들지 않으며, 오히려 증가할 수 있다.35

현상 유지로서의 등급별 성적평가 (Tiered grading as a status quo) 

등급별 성적평가를 지지하는 전통적인 주장에는 이것이 학생의 노력을 촉진하고47,48 졸업후의학교육(GME)에서 프로그램 책임자가 전공의를 선발하는 데 도움이 된다는 점이 있다.16,40–42,45–47 이러한 장점으로 인식되는 속성들은 해로운 영향에도 불구하고 의학교육에서 등급별 성적평가가 지속되는 것을 충분히 정당화하는 근거로 제시되어 왔다. 이 주장들은 타당도(validity), 신뢰도(reliability), 효율성, 졸업후의학교육 성취에 대한 예측 가치(predictive value)와 같은 평가의 특성에 초점을 맞춘다. 일부는 등급별 성적평가 자체가 의과대학생 사이에 해로운 경쟁을 만들지 않으며 학생 자신에게 책임이 있다는 주장을 반박했다.49 그러나 등급별 성적평가가 의료행위에 적합하거나 효과적인 학업 동기 요인이라는 근거는 부족하다.11,12 실제로 의과대학생에게 등급별 성적평가 같은 외재적 요인(extrinsic factors)으로 동기를 부여해야 한다는 전제 자체가, 평생 지속되는 내재적으로 동기화된 학습(intrinsically motivated learning)이라는 전문직의 근본적 책무를 위협한다.50


동기 이론(motivation theories)은 의학교육과정 개혁에서 충분히 반영되지 않았다.51 존재하는 근거에 따르면 등급별 성적평가는 단기적으로 외재적 동기를 높일 수 있지만, 외부 동기 요인인 등급별 성적을 제거하면 전반적인 동기 수준이 초기보다 낮아진다.52 또한 독서를 포함한 학생의 학습 습관은 등급별 성적평가의 영향을 받지 않으며,52 전국 표준화 시험의 성적 역시 영향을 받지 않는다.17 등급별 성적평가를 대신하는 서면 또는 구두의 서술형 피드백(narrative feedback)은 학업 동기를 높이면서 스트레스와 불안을 줄일 수 있다.53


그럼에도 많은 전공의 수련 프로그램 책임자와 일부 의과대학생은 성적평가를 ‘현재대로(as is)’ 유지하기를 원한다고 밝혀 왔다. 이는 등급별 성적이나 숫자 점수가 이후 임상 수행의 중요한 예측 인자로 남아 있다는 제한적인 근거 때문일 수 있다.41,42,45,46,54 졸업후의학교육 수행을 예측하기 위해 임상실습의 등급별 성적을 사용하는 데에는 일관성이 없으며, 이러한 문제는 거의 50년 동안 지적되어 왔다.40 비교적 최근의 일부 연구는 등급별 성적과 전공의 수행 사이에 양의 상관관계가 있다고 시사하지만45,46 다른 연구는 그렇지 않다.18,55–57 역설적으로, 합격/불합격 평가가 비판적으로 검토되지 않았으므로 등급별 성적평가를 유지해야 한다는 주장42은, 자체의 근거가 의심스러운 등급별 성적평가가 미국 의학교육에 역사적으로 도입된 사실을 비판 없이 수용하고 의존해 온 것은 도외시하는 듯하다. 석차, 성적, 우등생 학회(honor societies) 가입, 전국 표준화 시험 점수에 초점을 맞추는 것은 균형 잡힌 전인적 의학교육(holistic medical education)의 표지가 되어야 할 개인적 성장과 전문직 정체성 형성보다 측정된 수행에 관심이 쏠려 있음을 보여준다. 또한 의과대학의 평가 유발 스트레스(assessment-induced stress)를, 임상실무의 스트레스에 대비해 의과대학생을 단련하거나 길들이는 수단으로 치부해 왔다. 과거 의학교육의 어려움에 고전하는 학생에게 권했던 ‘스스로 자신을 호되게 다그치기(self-kick in the seat of the pants)’58는 당시에도 적절해 보이지 않았고,59 의과대학생과 그들이 돌보게 될 환자의 필요에 가장 잘 부응하는 오늘날의 전인적 교육 환경에도 맞지 않는다. 등급별 성적평가를 의과대학생의 형성에 필요한, 의례적이고 불안을 유발하는 과정으로 규정하는 것은 신고식 괴롭힘(hazing)의 여러 요소를 떠올리게 한다.60 이런 상황에서 수치심은 학생 간 연대(solidarity)를 약화하고, 의학교육의 집단 응집력과 임상실무의 팀 기반 진료(team-based care)라는 이상을 훼손한다. ‘숙달(mastery)’을 기억해낸 내용을 평가하는 표준화 시험으로 측정한다면, 연민(compassion), 공감(empathy), 참여(engagement), 응집력(cohesiveness), 판단력처럼 현대 의학에서 성공하는 데 더 중요하다고 주장할 수 있는 의료행위상의 숙달 속성은 충분히 평가받지 못하고, 따라서 저평가될 것이다. 등급별 성적평가에 의존하는 것은 인지적 수행과 포괄적인 현대 의료서비스 제공에 가장 중요한 의사 발달의 속성 사이의 거리를 더 벌린다.3

의과대학의 심리사회적 맥락에서 본 등급별 성적평가 (Tiered grading in the psychosocial context of medical school) 

의과대학의 학업 환경과 의과대학생의 스트레스·불안 사이의 연관성은 80년도 더 전에 분명히 인식되었다.61,62 의과대학생에게 심각한 정신건강 문제가 발생할 위험은 오늘날에도 지속된다.43 합격/불합격이라는 평가 범주를 넘어서는 등급별 성적평가가 학생의 불안, 우울, 번아웃에 기여한다는 설득력 있는 근거가 있다.38,39,43,63,64 실제로 등급별 성적평가는 오늘날 의학교육 환경에서 스트레스, 번아웃, 정서적 소진(emotional exhaustion)을 일으키는 교육과정상의 가장 강력한 원인 중 하나, 어쩌면 가장 강력한 원인으로 보인다.65 등급별 성적평가는 학생 간 경쟁 심화와 집단 응집력 저하와 관련된다.12,66,67 의과대학생 평가 과정에서 등급별 성적평가를 제거한 곳에서는 우울, 불안, 격차(disparities)가 줄고, 협력, 집단 응집력, 전문직 정체성이 높아진다.68,69 임상실습에서 등급별 성적을 평가 결과로 사용하지 않으면, 표준화 시험이나 총괄 서면시험을 준비하려고 학생이 임상현장에서 빠져나갈 유인이 없어져 임상 몰입(clinical immersion), 환자 및 교수진과의 접촉, 임상추론 능력(clinical reasoning skills)이 향상될 수 있다.70 이는 의과대학생의 공정성 인식 향상과도 관련된다.71


오늘날 의학교육의 지배적인 문화와 학업 환경이 학생의 안녕과 전문직 발달에 가할 수 있는 위협은 여전히 비판적 검토를 피해 가고 있다.72 학업 환경 자체는 ‘환경적 위해(environmental hazard)’에 비유되었으며,72 이는 산업보건과 안전(occupational health and safety)의 설득력 있는 관점을 불러온다. 학문의학(academic medicine)의 문화는 상당 부분 숨은 교육과정(hidden curriculum)에 의해 형성되며, 여기에는 지도전문의(attending physicians), 전공의, 동료와의 대인관계적 경험과 상호작용이 포함된다.73 전문직 정체성의 발달과 의학교육 중 실제로 중요한 것이 무엇인지에 대한 학생의 인식에 영향을 미치는 것은 바로 이 숨은 교육과정이다. 이는 60여 년 전 ‘하위문화(subculture)’로 불리기도 했다.74 실제로 의과대학생과 전공의·교수 교육자 사이의 이러한 상호작용이 ‘의학 전문직업성(professionalism)에 대한 학생의 이해에 가장 강력한 영향을 미친다’.75 (p16) ‘의사가 되는 데에는 좋은 성적을 받는 것보다 훨씬 더 많은 것이 필요하다’라는 격언도, 의과대학생의 가까운 미래와 진로가 주로 성적, 전국 의사면허시험 점수, 임상실습 전 및 임상실습 교육과정에서의 평가에 따라 결정된다는 사실이 분명해지면 회의와 불신, 일축으로 받아들여진다. 이론적 지식, 중요한 결과가 걸린 시험(high-stakes exams)의 수행, 임상환경에 대한 순응을 강조하는 숨은 교육과정은 의사가 어떤 사람이 되어야 하는지에 대한 도덕적 성찰의 여지를 거의 남기지 않는다. 이러한 사회화의 목적은 직업적 가치, 윤리, 규범을 ‘집단 또는 개인 수준의 성찰에 의한 검토를 거치기보다는 미묘하고 점진적인 방식’으로 정상적이고 일상적인 것으로 만드는 데 있다.76 (p59) 따라서 의과대학생의 인격적 형성과 의료문화로의 사회화 과정은 암묵적으로 전달되는 것에 크게 좌우된다. 여기에는, 그렇게 인식되든 아니든 의과대학생이 원하는 전문과목이나 수련 지역에 들어갈 자격을 자의적으로 층화함으로써 숨은 교육과정을 강화하는 등급별 성적평가 체계를 만들고 유지하는 일이 전달하는 메시지도 포함된다.


등급별 성적평가가 초래할 수 있는 스트레스와 불안뿐 아니라, 이러한 평가 체계는 소수화된 집단(minoritized groups)에 속한 학생들의 학업 수행에서 부당한 격차를 지속시킬 수도 있다. 최근의 사회·정치 운동은 매우 다원적인 미국 인구의 보건의료 요구를 충족하고, 우리 의과대학에 입학하고 졸업하는 과소대표 소수집단(under-represented minorities, URM)의 격차를 해소할 수 있는 다양한 의사 인력을 배출하는 데 의학교육 체계가 보여온 일부 실패에 주목하게 했다.13,77 아마 가장 중요한 점은, 인지적 수행 등의 변수를 통제해도 과소대표 소수집단 학생이 더 낮은 평가를 받는 인종적 불평등과 등급별 성적평가가 관련되어 보인다는 것이다.13,15,78 이는 다시 과소대표 소수집단 학생의 우등생 학회 가입, 전공의 수련 선택지, 전문과목 선택에 영향을 준다. 의과대학생 평가를 둘러싼 수많은 교육학적·사회적·과학적·임상적 쟁점과 의사의 전문직 정체성 형성에 기여하는 학업 과정은 평가 과정의 복잡성과 논쟁성을 더한다.5

의과대학생 성적평가의 도덕적 맥락 (The moral context of medical student grading) 

의학교육의 도덕적 맥락에서는 교육과 멘토링 모두 중요하다. 이는 상당 부분 교육자와 학생 사이의 권력 불균형 때문이다. 등급별 성적, 석차 또는 다른 형태의 학생 층화를 결정하는 궁극적인 책임이 교수에게 있으므로, 학업 환경 자체가 이러한 권력 불균형을 지속시킬 가능성이 있다. 또한 의학교육의 교수·평가 과정은 교육자를 이해상충(conflict of interest)이 분명한 위치에 놓는다. 효과적인 교사는 학생이 성공하기를 바라면서 동시에 성공했는지도 판단해야 한다. 의학교육자이자 멘토는 학생이자 피지도자(protégé)와 안전하고 지지적이며 형성적인 관계를 맺기 위해 비판단적인 태도를 유지해야 한다. 그러나 의학교육자는 학생의 역량을 비판적이고 정직하게 평가할 때에는 판단도 내려야 한다.79 의학교육자는 흔히 자신의 교수 효과성(teaching effectiveness)에 대해 의과대학생의 평가를 받는다. 학생 수행을 비판적으로 평가하면 학생에게서 좋지 않은 교수평가를 받을 수 있다.80 이러한 갈등은 교사가 임상실습 학년의 학생 수행을 부정적으로 비평하기를 주저하는 이유를 어느 정도 설명할 수 있다.31,32


역량 평가를 개선한다는 목적으로 의과대학생의 서열을 매기는 수학적 접근법을 개발·정교화·적용하고 강조하면, 성공적인 의료행위의 심리사회적 차원을 간과할 위험이 있으며9,12 궁극적으로 의과대학생과 교육기관 사이의 신뢰도 위협할 수 있다.81,82 의과대학생을 서열화하는 체계에 의존하면, 의학교육자와 학생 관계의 도덕적 토대가 학사 운영상의 편의에 종속될 수 있다. 교사와 학생 양쪽의 도덕적 발달은 교육과정의 다른 속성만큼 관심을 받지 못했다. 의료교육을, 인간적이고 지지적인 교육 과정을 통해 역량 있고 다양한 의사 인력을 배출한다는 궁극적 목표보다 교육 과정의 효과성과 효율성에 초점을 둔 기술적 사업으로 규정하면, 아마도 ‘…도덕적 기준과 같은 다른 기준은 대체로 부차적인 중요성만 갖거나 전혀 고려되지 않는다’.83 (p156) 등급별 성적평가로 특징지어지는 학업 환경은 다양하고 전인적으로 준비된 의사 인력의 양성보다 성적평가 패러다임의 작동 방식을 강조하고 중시한다. 또한 이러한 학업 환경은 의과대학생의 도덕적 발달을 멈추게 하거나, 더 나쁘게는 퇴행시킬 수 있다.84,85 낮은 석차의 수치심을 피하고, 인정을 얻고, 임상실습 전 및 임상실습 교수진에 대한 충성심을 보여주도록 등급별 성적평가가 설정한 학업 유인은 전인습적·인습적 도덕 단계(preconventional and conventional moral stages)의 특징을 보인다.84 이러한 도덕 단계는 보통 아동기와 청소년기에 연관된다.84 부적절한 학업 유인은 의과대학생이 후인습적 도덕 단계(post-conventional moral stage)로 나아가는 것을 막을 수 있다. 이 단계에서는 전문직이나 사회의 규범과 독립적으로 ‘…인간의 존엄성과 인권의 원칙이 인격에 완전히 통합되고 개인 행동의 토대를 형성한다’.84 (p504) 의과대학 교수진과 의학교육기관은 학생의 도덕적 발달을 높이기 위해 노력하고, 이를 위협하는 요소를 적극적으로 제거해야 한다.85

등급별 성적평가를 넘어서 (Beyond tiered grading) 

등급별 성적평가를 없애면 의과대학생 평가를 개선할 수 있는가? 우리는 그것이 가능할 뿐 아니라 반드시 필요하다고 믿는다. 분명히 해두자면, 학생에게 높은 기준을 요구하지 말자는 뜻도, 높은 기준이 충족되는지 확인하기 위한 시험을 더 이상 치르지 말자는 뜻도 아니다. 실제로 시험 강화 학습(test-enhanced learning)은, 우리의 견해로는 의과대학생에 대한 엄격한 시험을 학습 도구로 계속 시행해야 한다는 강력한 논거다.86 다만 이상적인 의과대학생 평가의 형태와 방법은 학생을 서열화·등급화·분류하는 데 쓰여서는 안 되며,87 다양하고 전인적으로 수련받았으며 효과적이고 회복탄력적(resilient)이며 유연한(agile) 의사 인력을 배출하려는 교육기관의 책무 속에서 학생을 평가하는 데 쓰여야 한다. 사용하는 평가 도구는 성공적인 의학교육에서 바라는 이러한 속성을 평가하는 데 초점을 맞추어야 한다.


평가 도구는 또한 평가한다고 주장하는 대상을 평가하는 데 충분한 타당도(validity)를 보여야 한다. 타당도는 평가 도구 자체의 속성이 아니라 그 도구가 산출한 결과에 대한 해석과 추론(interpretations and inferences)의 속성임을 기억하는 것이 중요하다.88 어떤 형태의 등급별 성적평가든, 다양하고 전인적으로 수련받았으며 효과적이고 회복탄력적이고 유연한 의사 인력을 공급하는 데 미치는 전반적 결과를 고려하지 않은 채 학생을 학문적 인정이나 전공의 선발을 위한 범주로 나누는 데 사용한다면, 그 성적평가의 해석과 추론, 그리고 타당도를 재평가해야 한다. 결과는 중요하며, ‘평가의 의도된 또는 의도되지 않은 결과를 평가하면 이전에는 눈에 띄지 않았던 타당도 결여의 원천을 밝혀낼 수 있다’.88(p166.e10) 예를 들어 번아웃과 경쟁의 감소, 집단 응집력의 향상을 의학교육의 중요한 성과로 여긴다면, 이 영역에서 등급별 성적평가가 낳는 부정적 결과는 평가 도구로서의 등급별 성적평가의 타당도를 위협한다. 또는 등급별 성적평가를 분석한 결과 어떤 소수집단의 점수나 평정이 일관되게 낮다면, 이는 모든 전문과목에서 다양한 의사 인력을 배출하는 데 있어 등급별 성적평가의 타당도를 위협한다.88 이러한 이유로 능동적인 비판적 교육학(critical pedagogy)은 매우 중요하다. 그것은 ‘…상황에 대한 인식을 높일 수 있으며, 이는 불평등을 줄이기 위한 변화를 만드는 전 단계’이기 때문이다.89(p351)


또한 임상환경에서 학습과 역량을 평가할 때 타당도는 환자군의 일상적 변동, 평가할 수 있는 교수자의 판단력 차이 등 여러 요인에 취약하다. 그러나 의료행위에 필요한 학습과 역량에 대한 가장 중요한 평가는 아마도 바로 임상환경에서 이루어져야 한다. 여기서는 학습, 수행, 수행 평가의 역동이 진료와 학습이 일어나는 복잡한 임상환경 속에서 모두 융합된다.90 따라서 직무 기반 평가(work-based assessments, WBA)는 의과대학생이 장차 활동하게 될 다양하고 복잡하며 끊임없이 변하는 보건의료 환경과 진료 현장에서의 의료행위 평가에 더 충실하게 부합한다. 사용하는 평가 도구의 해석과 추론에는 평가가 이루어지는 보건의료 환경과 현장이 반영되어야 한다. 이러한 환경과 현장은 사회적·지리적·시간적으로 각기 고유하며, 학생이 장차 실제로 진료할 환경이나 상황을 반영하지 않을 수도 있다. 따라서 ‘…평가 관행의 양적 평가와 관련된 전통적인 신뢰도·타당도 개념은 맥락에 놓인 수행(situated performance)에 대한 해석을 평가하는 데 유용성이 제한적이다’.90 (p1171) 평생학습 기술, 동기, 미래의 진료에 대한 적응력의 평가에서도 그 맥락에 맞는 타당도를 확보해야 한다. 중요한 것은 ‘…평가의 목적이 학습 성과를 ‘객관적으로’ ‘정확하게’ 수량화하는 것이 아니라, 수련생과 의사가 무엇을, 어떻게, 왜 배우는지를 이해하는 것임을 뜻한다’는 점이다.90 (p1169)


이상적인 평가는 또한 모호하지 않고, 도덕에 기반하며, 공정해야 한다. 임상실습에서 등급별 성적평가를 중단하고 합격/불합격 체계로 전환하면 공정성에 대한 인식이 개선된다.71 교육 평가에서 공정성에 대한 전통적인 접근은 신뢰도와 타당도에 초점을 맞추어 왔지만, 심리측정학(psychometrics)에 대한 객관적이고 제한적인 초점은 ‘…복잡한 직무 현장의 역량, 수행, 평가에 관한 핵심 문제를 무시할 수 있다’.91 (p714)


새롭게 축적되는 문헌은 특히 의학교육의 임상실습 학년에서 서술형 평가(narrative) 같은 주관적 평가를 적절하게 사용하고 해석하는 데 정보를 제공할 수 있다.91 객관성 중심 평가와 비교할 때 서술형 내용이 풍부한 평가(narrative-rich assessment)는 학습자에게 더 실행 가능한 피드백을 제공하고, 학습자에게 임상 진료를 위임할지에 관해 지도 임상 교수진이 내리는 결정에도 가치를 더할 수 있다.92 그러나 합격/불합격의 서술형 평가 과정도 완벽하지 않으며, 편향이나 과소대표 소수집단 학생에게 불리한 평가에서 자유롭지 않다는 점을 말해야 한다. 따라서 모든 평가의 결과를 신중하고 지속적으로 검토할 때 의도하지 않은 결과까지 고려해야 한다. 타당도 평가는 계속되는 과정이어야 한다.88


필수 학습 경로와 개별화된 학습 경로 모두에서 역량을 입증하면 ‘학점(credits)’을 부여하는 평가 체계가, 장차 임상의가 돌볼 인구집단이 기대하는 기준을 유지하면서도 의과대학생 집단의 개별화와 다양성을 더 잘 촉진할 수 있을지 모른다. 이러한 학점 기반 체계가 합격/불합격 평가로 구성된다면 의과대학생의 스트레스를 줄이고,93 안녕감을 높이며,94 평생학습에 더 잘 부합하는 숙달 지향 학습(mastery-oriented learning)을 촉진할 수 있다.71 평가의 초점이 다른 수행 평가의 세부사항(예: 미국 의사면허시험 1단계[United States Medical Licensing Exam Step 1]의 숫자 성적평가95)에서 의학 학습자의 개인적·전문직적 발달로 옮겨가면, 그러한 전환이 촉진되거나 새로운 관점에서 검토될 수 있다.


심리측정학적 객관성과 외부 동기에 지향된 전통적인 등급별 성적평가 체계에서, 학습을 위한 평가(assessment for learning), 학습에 대한 평가(assessment of learning), 학습으로서의 평가(assessment as learning)를 강조하는 합격/불합격 체계로 전환하는 것은 어느 교육기관에서나 어려울 것으로 예상된다.96 그러나 의학교육자가 평가를 개혁하는 데 도움이 될 요인들이 확인되었고, 유용할 수 있다.97 특히 합격/불합격 평가 패러다임에서는 교수 평가자가 충분히 견고해야 할 역량 기준에 못 미치는 학생을 비판적으로 평가하고 필요할 때 보충교육(remediation)을 시행할 용기가 필요하다.4,42 임상실습에서 불합격 성적을 부여하는 일은 역사적으로 드물었으므로 이를 위해서는 의도적인 노력이 필요하다.98 의학교육자는 학생이 의료행위를 하도록 최선을 다해 준비시켜야 하며, 동시에 역량 기준을 충족할 수 없는 학생에게는 불합격 판정을 내릴 준비도 해야 한다.

결론 (Conclusion) 

의료행위에 필요한 의과대학생의 역량을 평가하는 이상적인 방식은 의학을 성공적이고 안전하고 효과적으로 실천하는 데 필요한 모든 기술의 발달을 비판적으로 평가하면서, 동시에 미래 의사 인력의 개별적 관심, 기여, 다양성을 촉진해야 한다. 학생 개인이나 집단에 해를 끼쳐서는 안 된다. 최근 자료가 축적되면서 등급별 성적평가가 더 높은 스트레스, 우울, 불안, 불공정하다는 인식, 학생 간 응집력 저하, 전문직 정체성 형성 저해, 인종적 격차와 관련된다는 근거가 늘어나는 만큼, 의학교육자와 그들을 지원하는 학교는 교육과정에서 등급별 성적평가가 차지하는 위치를 재고해야 한다. 의학교육자는 교육의 모범적인 실천(best practices)과 새롭게 등장하는 교육학적 전문지식에 익숙해야 한다.99 다른 모든 교육자와 마찬가지로 그들은 ‘제도화된 교육이 조장할 수 있는 부정의에 민감해야 한다. 이는 단순한 숙련도가 아니라 인격의 문제다’.100(p31) 여기에는 영웅적인 교육과정 변화(heroic curricular change)를 수용하고 실현하려는 의학 분야 학문적 지도자의 용기도 필요하다.101 대안적 비등급별 평가를 조사하고, 나아가 그 방식으로 전환하는 것은 반드시 필요하다. 최소한 등급별 성적평가 체계를 유지하는 학교는, 이 방식과 관련된 해로운 영향을 고려할 때 그 사용을 정당화하도록 요구받아야 한다. 이러한 부정적 영향을 해결하지 않은 채 두는 것은 그 영향을 용인해도 된다는 인상을 주며, 의학교육에서 등급별 성적평가가 문제를 안고 지속되는 현상을 암묵적으로 지지한다.


J Contin Educ Health Prof. 2026;46(3):153-159.doi: 10.1097/CEH.0000000000000656. Epub 2026 Jun 26.

Artificial Intelligence, Cognitive Abundance, and the Multi-Layered Competence of Health Professionals 

🧠 AI가 만든 "인지적 풍요"의 시대, 의사의 역량은 어떻게 달라질까? Pusic & ten Cate의 다층 역량 모델로 읽기

📄 Pusic MV, ten Cate O. Artificial Intelligence, Cognitive Abundance, and the Multi-Layered Competence of Health Professionals. Journal of Continuing Education in the Health Professions. 2026;46(3):153–159. doi:10.1097/CEH.0000000000000656 (CC BY-NC-ND 오픈 액세스)


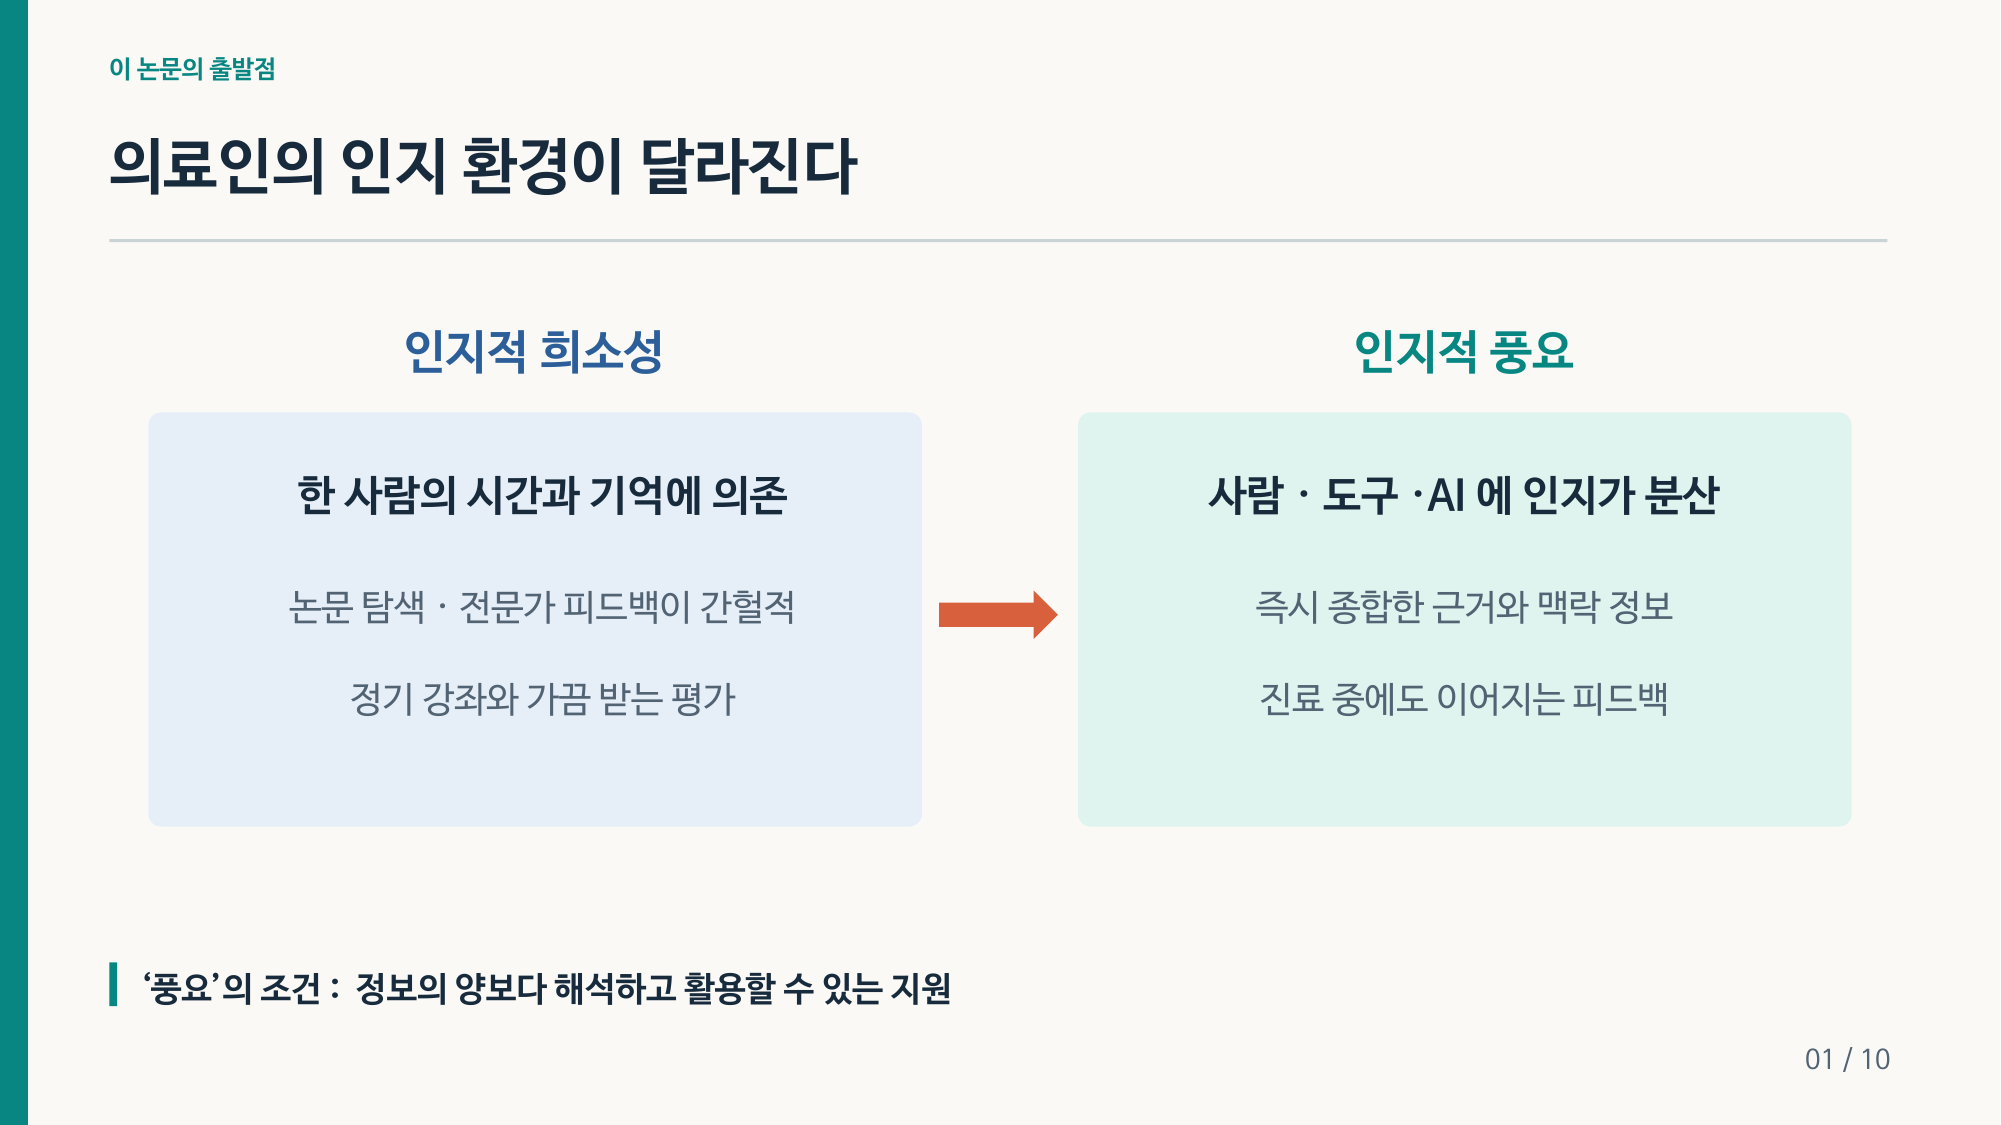
안녕하세요! 앞에서 AAMC 기초역량과 Macy 재단 AI 권고안을 소개했는데, 오늘은 그 흐름을 이어서 조금 더 개념적인 논문을 하나 읽어 볼게요. 하버드의대의 Martin Pusic과 EPA 개념을 만든 위트레흐트의 Olle ten Cate가 함께 쓴 글이에요.


이 논문은 새로운 데이터를 제시하는 연구 논문이 아니라, 평생교육(CPD, Continuing Professional Development) 관점에서 AI가 의사의 역량 자체를 어떻게 바꾸는지 따져 보는 개념 논문이에요.


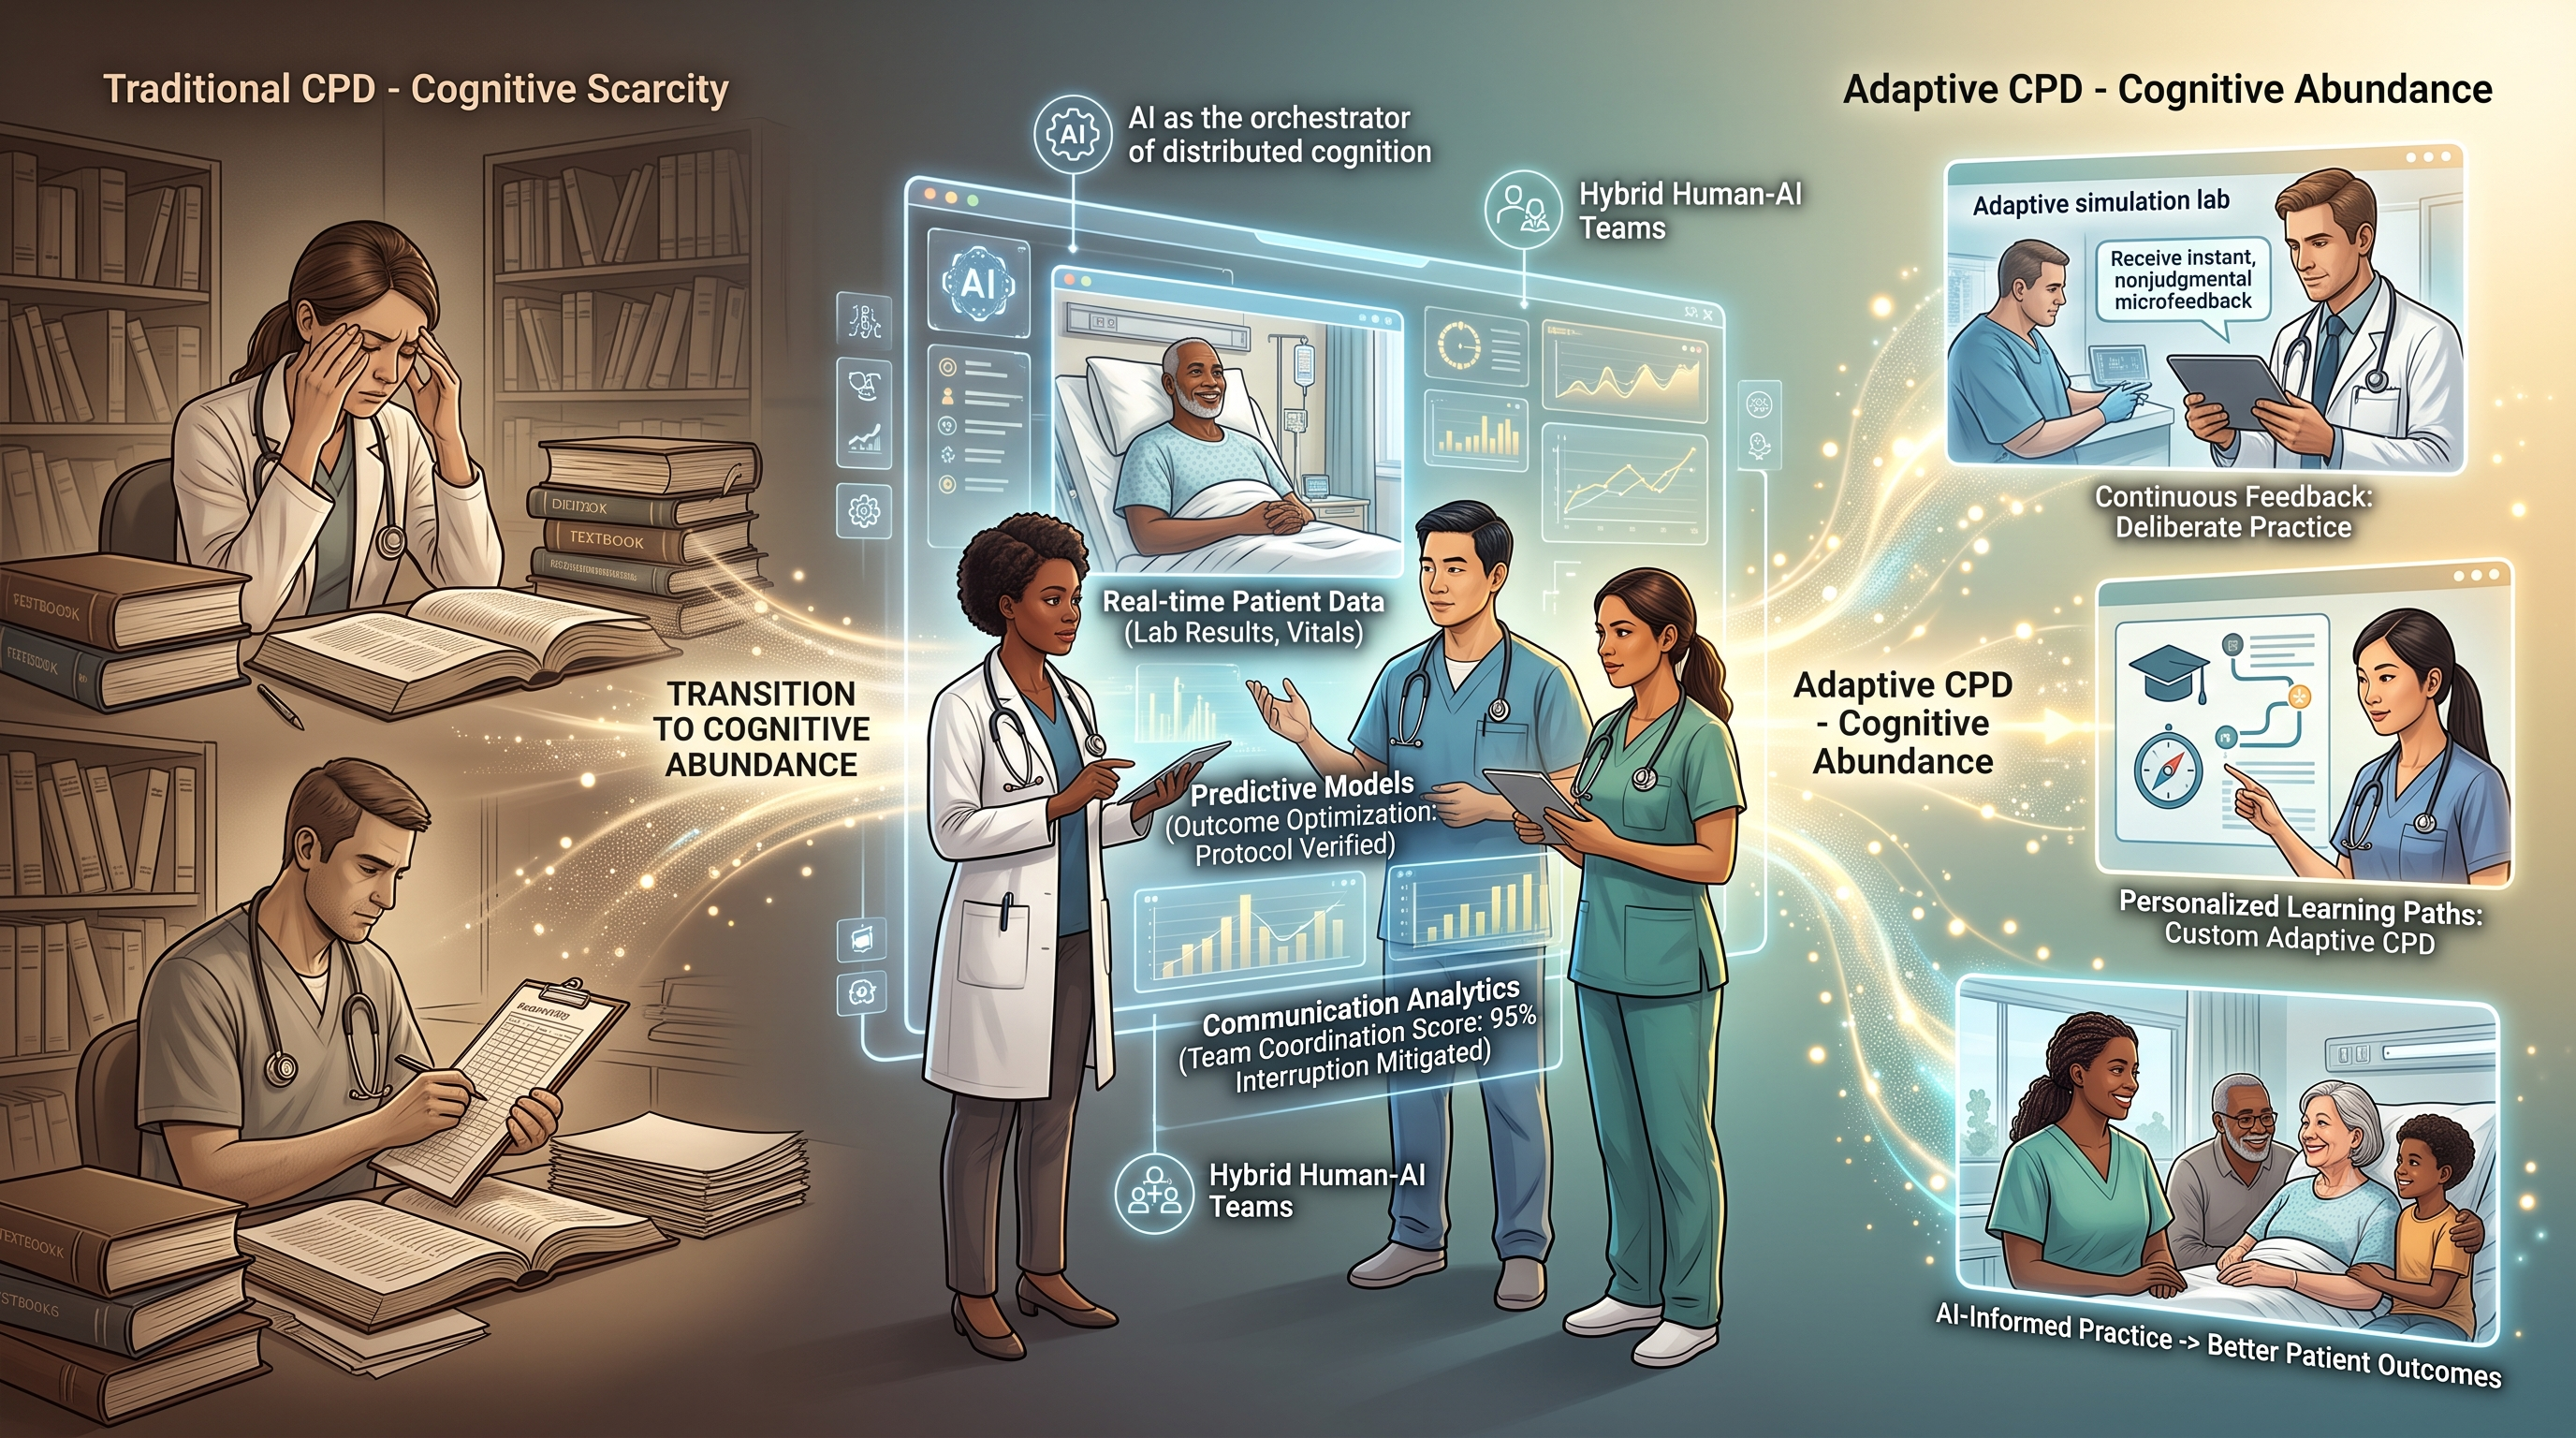
한 줄로 줄이면 이래요. "의사가 늘 시간과 정보에 쫓기던 '인지적 희소성'의 시대가 끝나고, AI 덕분에 '인지적 풍요'의 시대가 오고 있다. 그러면 역량의 세 층위가 모두 달라진다."


📌 1. 인지적 희소성에서 인지적 풍요로

⏳ 인지적 희소성 (cognitive scarcity)

이 용어는 행동경제학자 Mullainathan과 심리학자 Shafir가 2013년 『결핍의 경제학(Scarcity)』에서 처음 썼어요. 원래는 돈, 시간, 수면 같은 자원이 부족할 때 사람의 마음이 그 부족함에 사로잡히는 상태를 말해요.


저자들은 의사들이 겪는 희소성이 좀 특별하다고 봐요. 최신 연구를 따라가고, 진료를 깊이 성찰하고, 최선의 진료를 할 시간과 역량이 늘 부족하다는 거죠. 그래서 기존 CPD는 이 병목에 맞춰 설계됐어요. 정리된 업데이트, 모듈식 CME, 가끔 하는 시뮬레이션 같은 것들이요.

인지가 가용성 면에서 제한적이었기 때문에, 학습은 특정 시간과 장소로 제한될 필요가 있었다. AI의 부상은 이 지형을 근본적으로 바꾸어, CPD의 조건을 인지적 희소성을 헤쳐 나가는 것에서 풍요를 운용하는 것으로 전환시킨다.
"Learning needed to be constrained to specific times and places because cognition was limited in availability. The rise of AI changes this landscape fundamentally, shifting the conditions of CPD from those of navigating cognitive scarcity to instead marshalling abundance."

🌊 인지적 풍요 (cognitive abundance)

저자들은 이 개념이 아직 학계에서 정립된 구성개념은 아니라고 솔직하게 밝혀요. 분산인지(distributed cognition), 디지털 증강, AI 연구가 만나는 지점에서 나온 개념이라는 거예요.


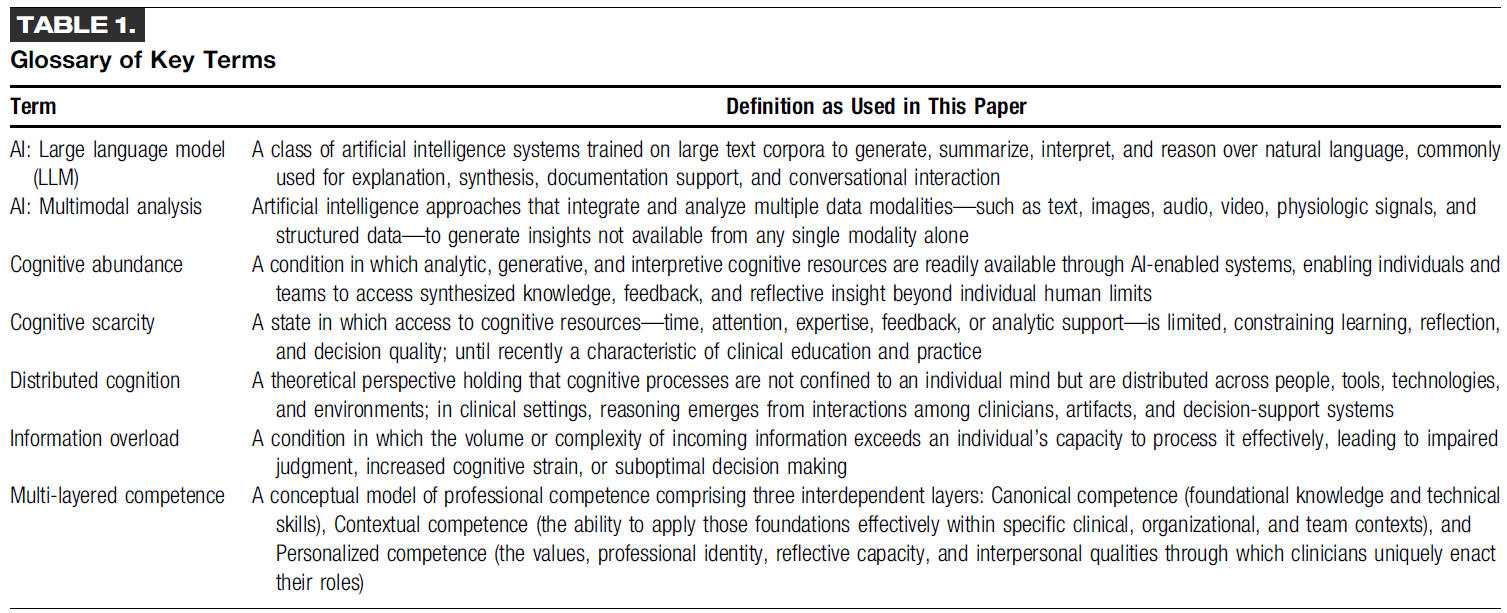
논문의 용어집(Table 1) 정의는 이래요.

인지적 풍요란 AI 기반 시스템을 통해 분석적, 생성적, 해석적 인지 자원을 쉽게 이용할 수 있어서, 개인과 팀이 개인의 인간적 한계를 넘어 종합된 지식, 피드백, 성찰적 통찰에 접근할 수 있는 상태다.
"A condition in which analytic, generative, and interpretive cognitive resources are readily available through AI-enabled systems, enabling individuals and teams to access synthesized knowledge, feedback, and reflective insight beyond individual human limits"


여기서 오해하기 쉬운 점이 있어요. 정보 과부하(information overload) 와는 다르다는 거예요. 정보 과부하는 걸러지지 않은 정보가 너무 많아서 판단력이 흐려지는 상태죠. 인지적 풍요는 오히려 해석 가능하고 실행 가능한 인지적 지원이 있어서 부담을 줄여 주는 상태를 말해요.


그리고 저자들은 이 점도 분명히 해요.

중요한 것은, 인지적 풍요가 인지적 노력이나 판단이 없어도 된다는 뜻이 아니라는 점이다. 오히려 이는 인지가 생산되고, 공유되고, 관리되는 방식의 근본적 변화를 뜻하며, 단순한 효율성 향상을 넘어 전문가의 역량, 책임, 학습에 함의를 갖는다.
"Importantly, cognitive abundance does not imply the absence of cognitive effort or judgment; rather, it denotes a fundamental change in how cognition is produced, shared, and governed, with implications for professional competence, responsibility, and learning that extend beyond mere efficiency gains."


🧩 2. 분석 틀: ten Cate의 다층 역량 모델

저자들이 이 논문에서 던지는 핵심 질문은 이거예요.

의사가 더 이상 생의학 정보의 유일한 처리자가 아니고, 유일한 보유자는 더더욱 아니게 될 때, 역량은 어떻게 이해되고 길러져야 하는가?
"how should competence be understood and cultivated when clinicians are no longer the sole processors, let alone possessors, of biomedical information?"


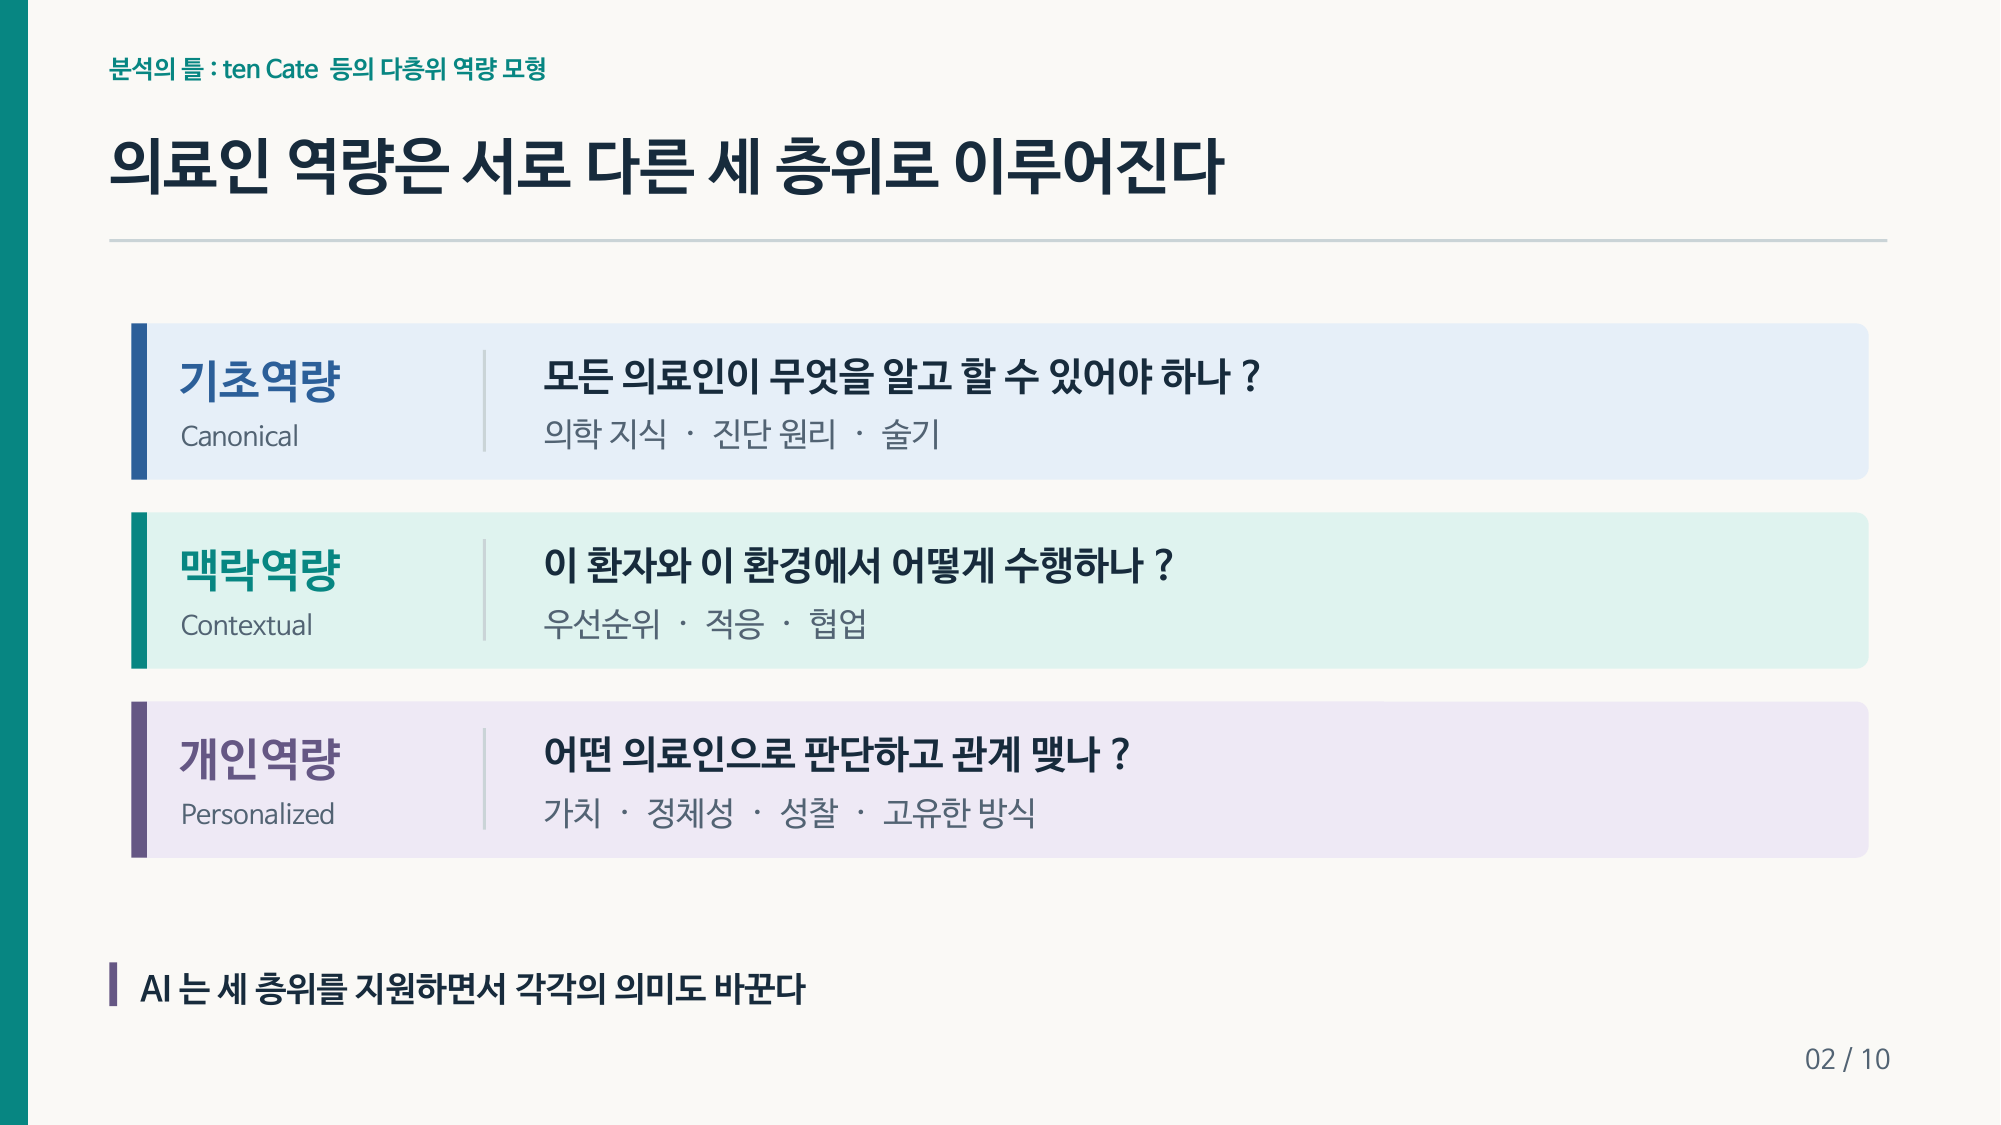
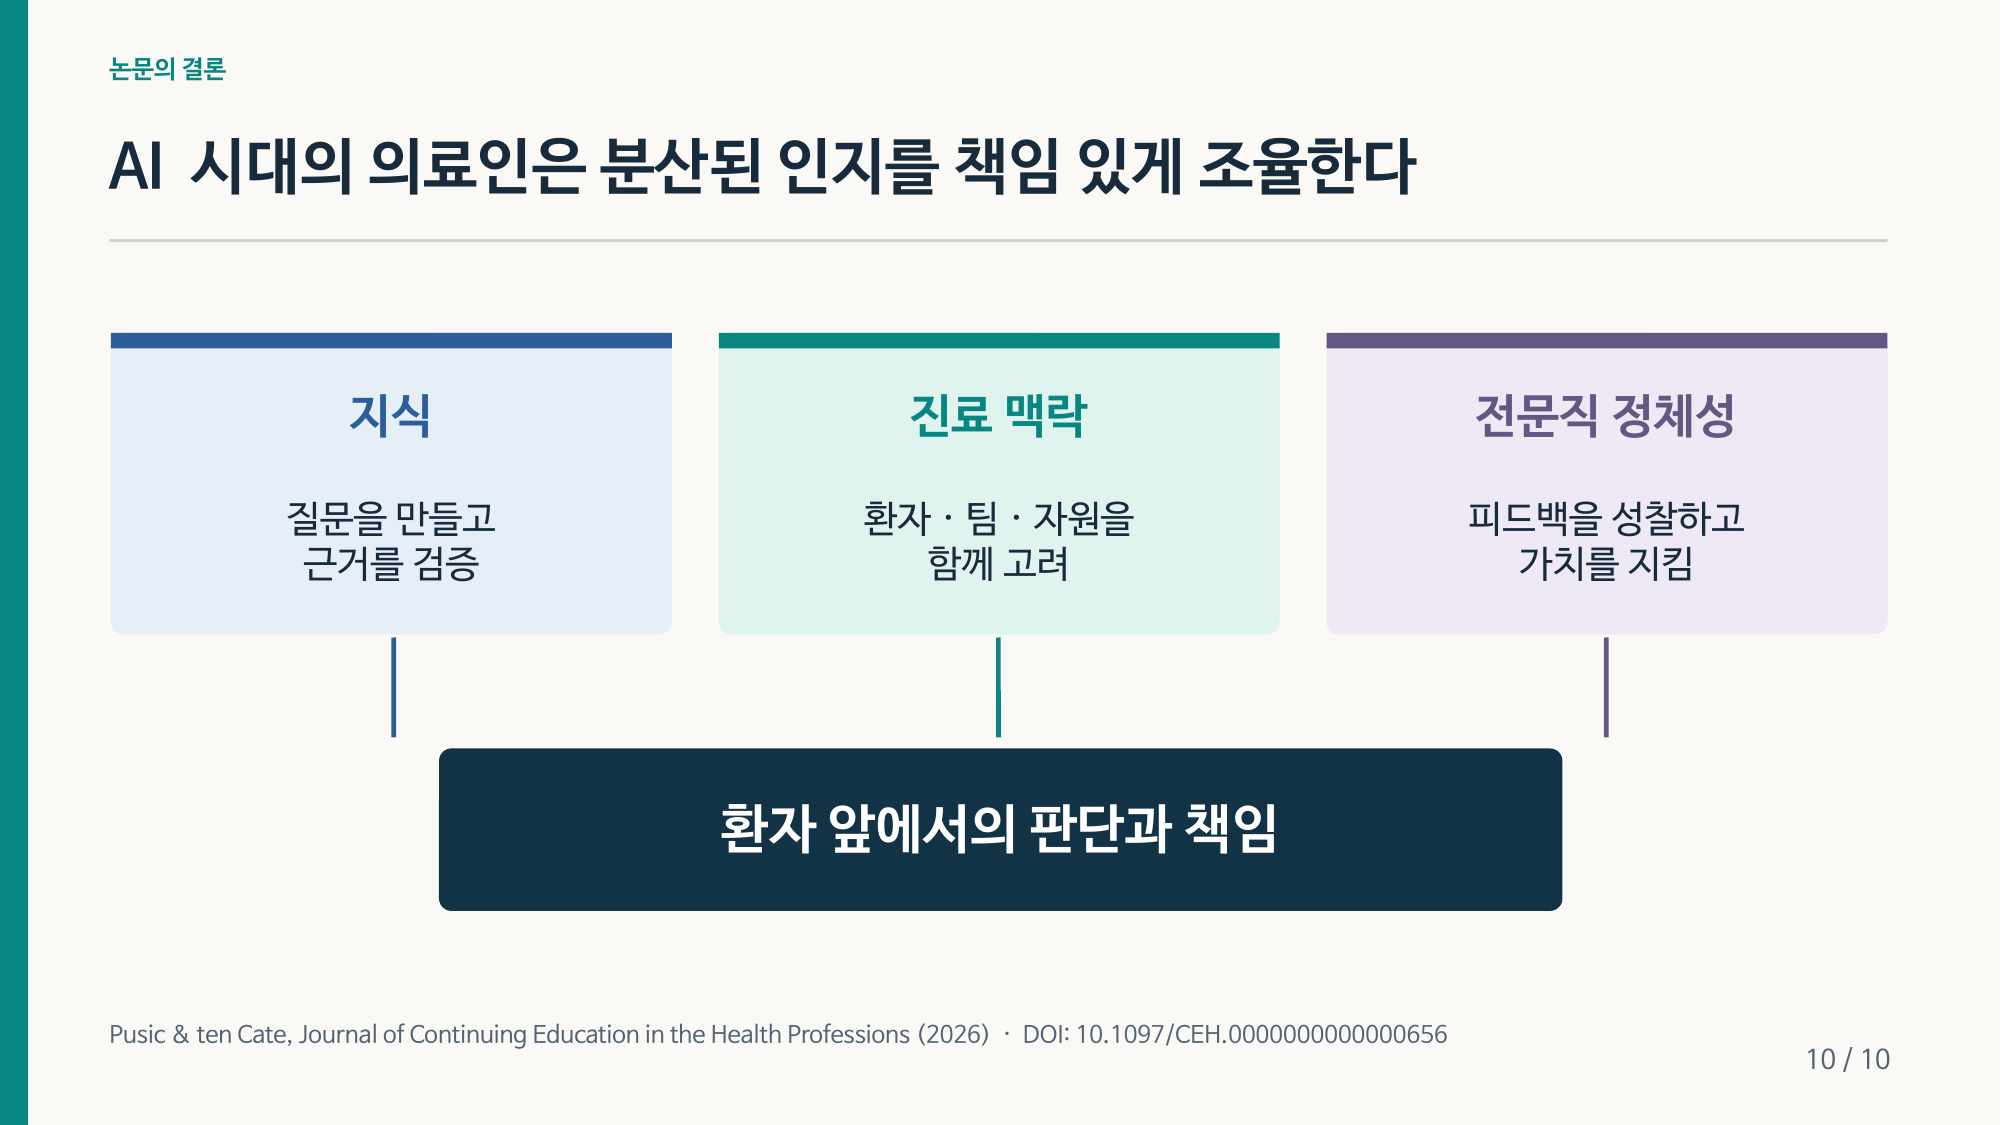
이 질문에 답하려고 ten Cate 등이 2024년 Medical Education에 발표한 다층 역량 모델(multilayered model of competence) 을 사용해요. 세 층위로 이뤄져 있어요.

층위 내용
🏛️ 정전적 역량 (canonical competence) 확립된 기초 생의학 지식과 기술. "모두가 알아야 하는 것(that all should know)"
🏥 맥락적 역량 (contextual competence) 복잡한 임상 시스템과 다양한 맥락 안에서 그 기초를 효과적으로 적용하는 능력
🙋 개인화된 역량 (personalized competence) 개인의 가치, 개인 정체성과 통합된 전문직 정체성, 자기 발달을 결정하는 성찰 능력, 고유한 개인 스타일

※ canonical competence는 아직 합의된 번역어가 없는 것 같아서, 이 글에서는 "정전적 역량"으로 옮겼어요.


저자들의 기본 주장은 이래요. AI는 세 층위를 모두 강화하지만, 동시에 배우고, 추론하고, 전문가로 성장한다는 것의 의미 자체를 바꾼다. 그리고 층위마다 AI의 영향을 두 수준으로 나눠 봐요. 하나는 기존 교육을 더 잘하게 만드는 점진적 개선이고, 다른 하나는 인지적 풍요가 가져오는 근본적 전환이에요. 이 구분을 기억하면서 층위별로 볼게요.


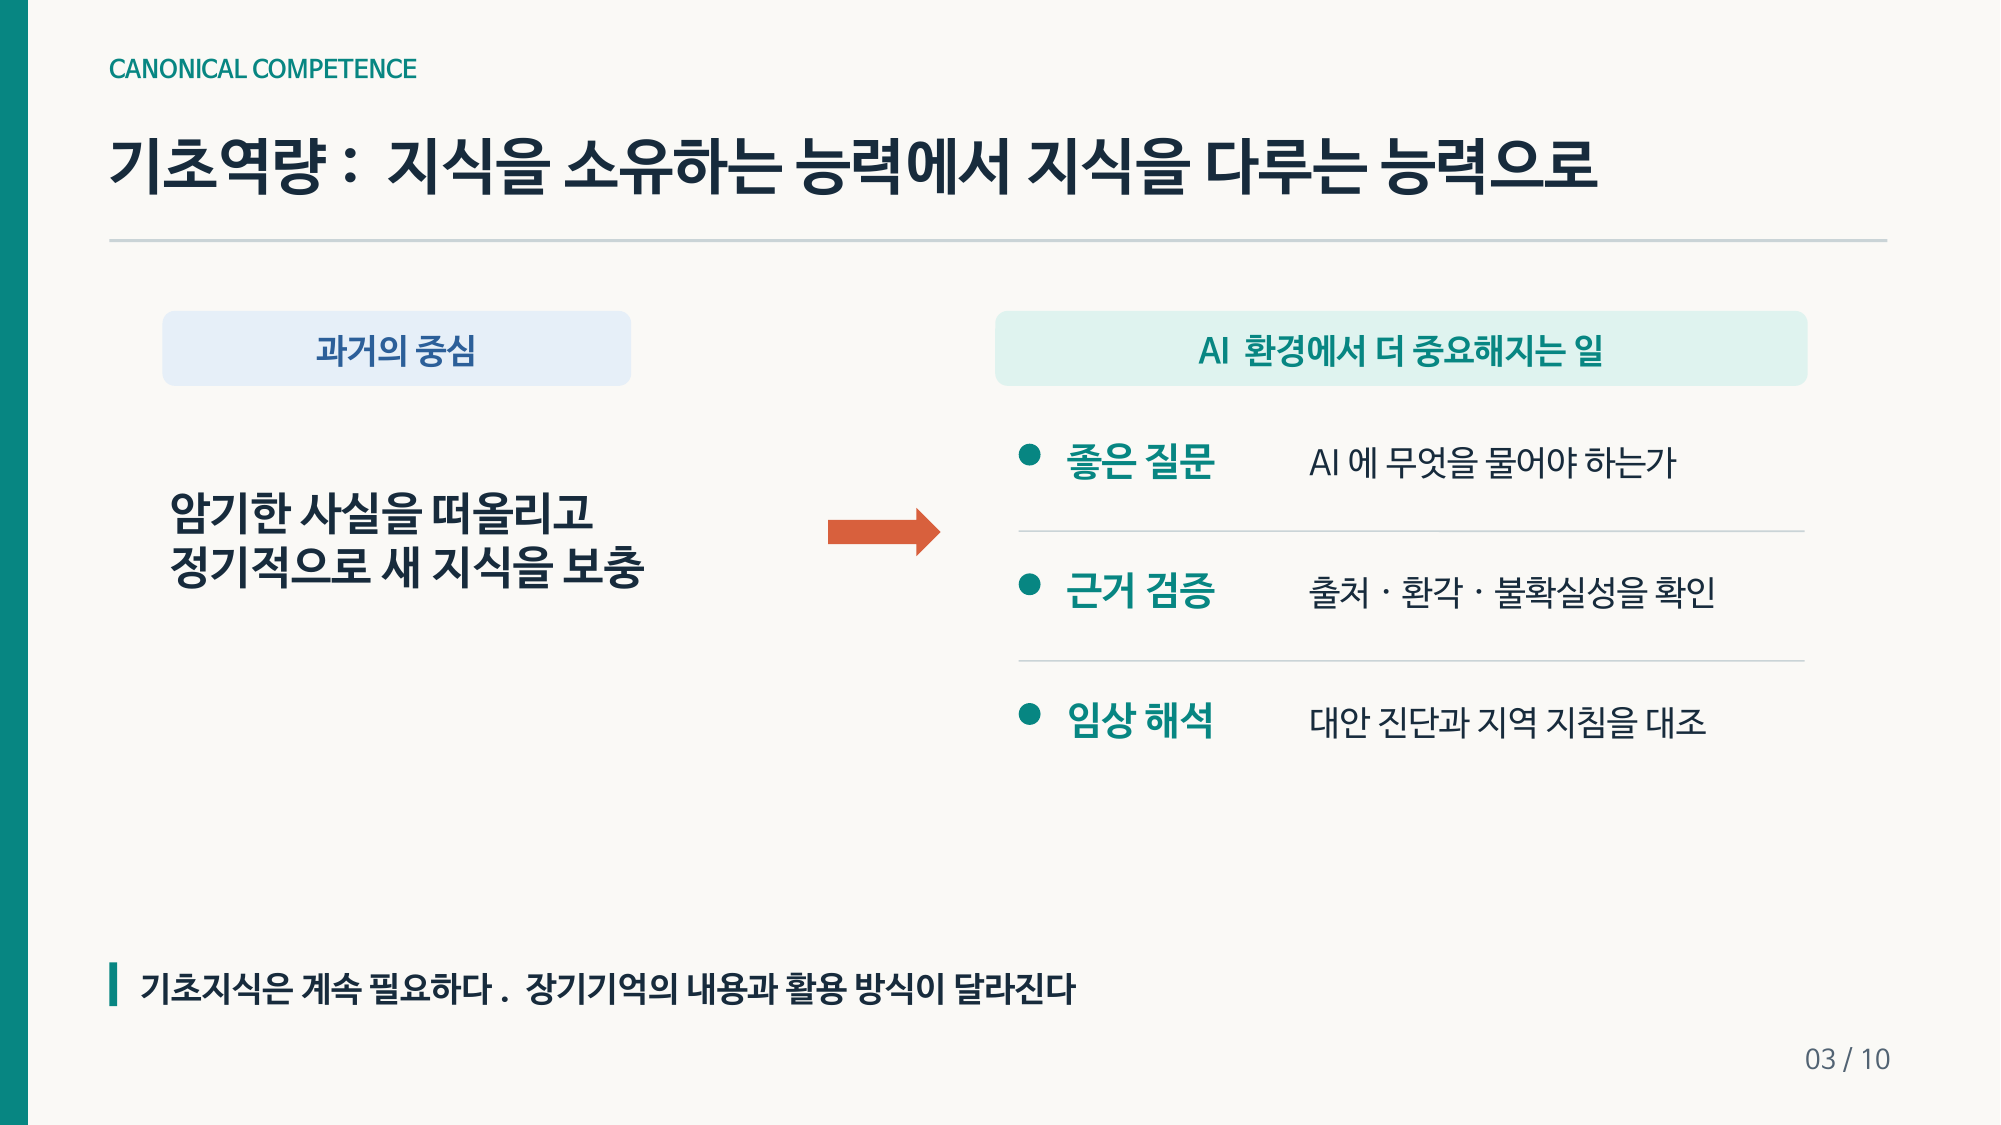
🏛️ 3. 정전적 역량: "무엇을 아는가"에서 "지식 시스템과 어떻게 일하는가"로 

점진적 개선

AI는 기초지식과 기술을 배우는 과정을 여러모로 돕고 있어요.

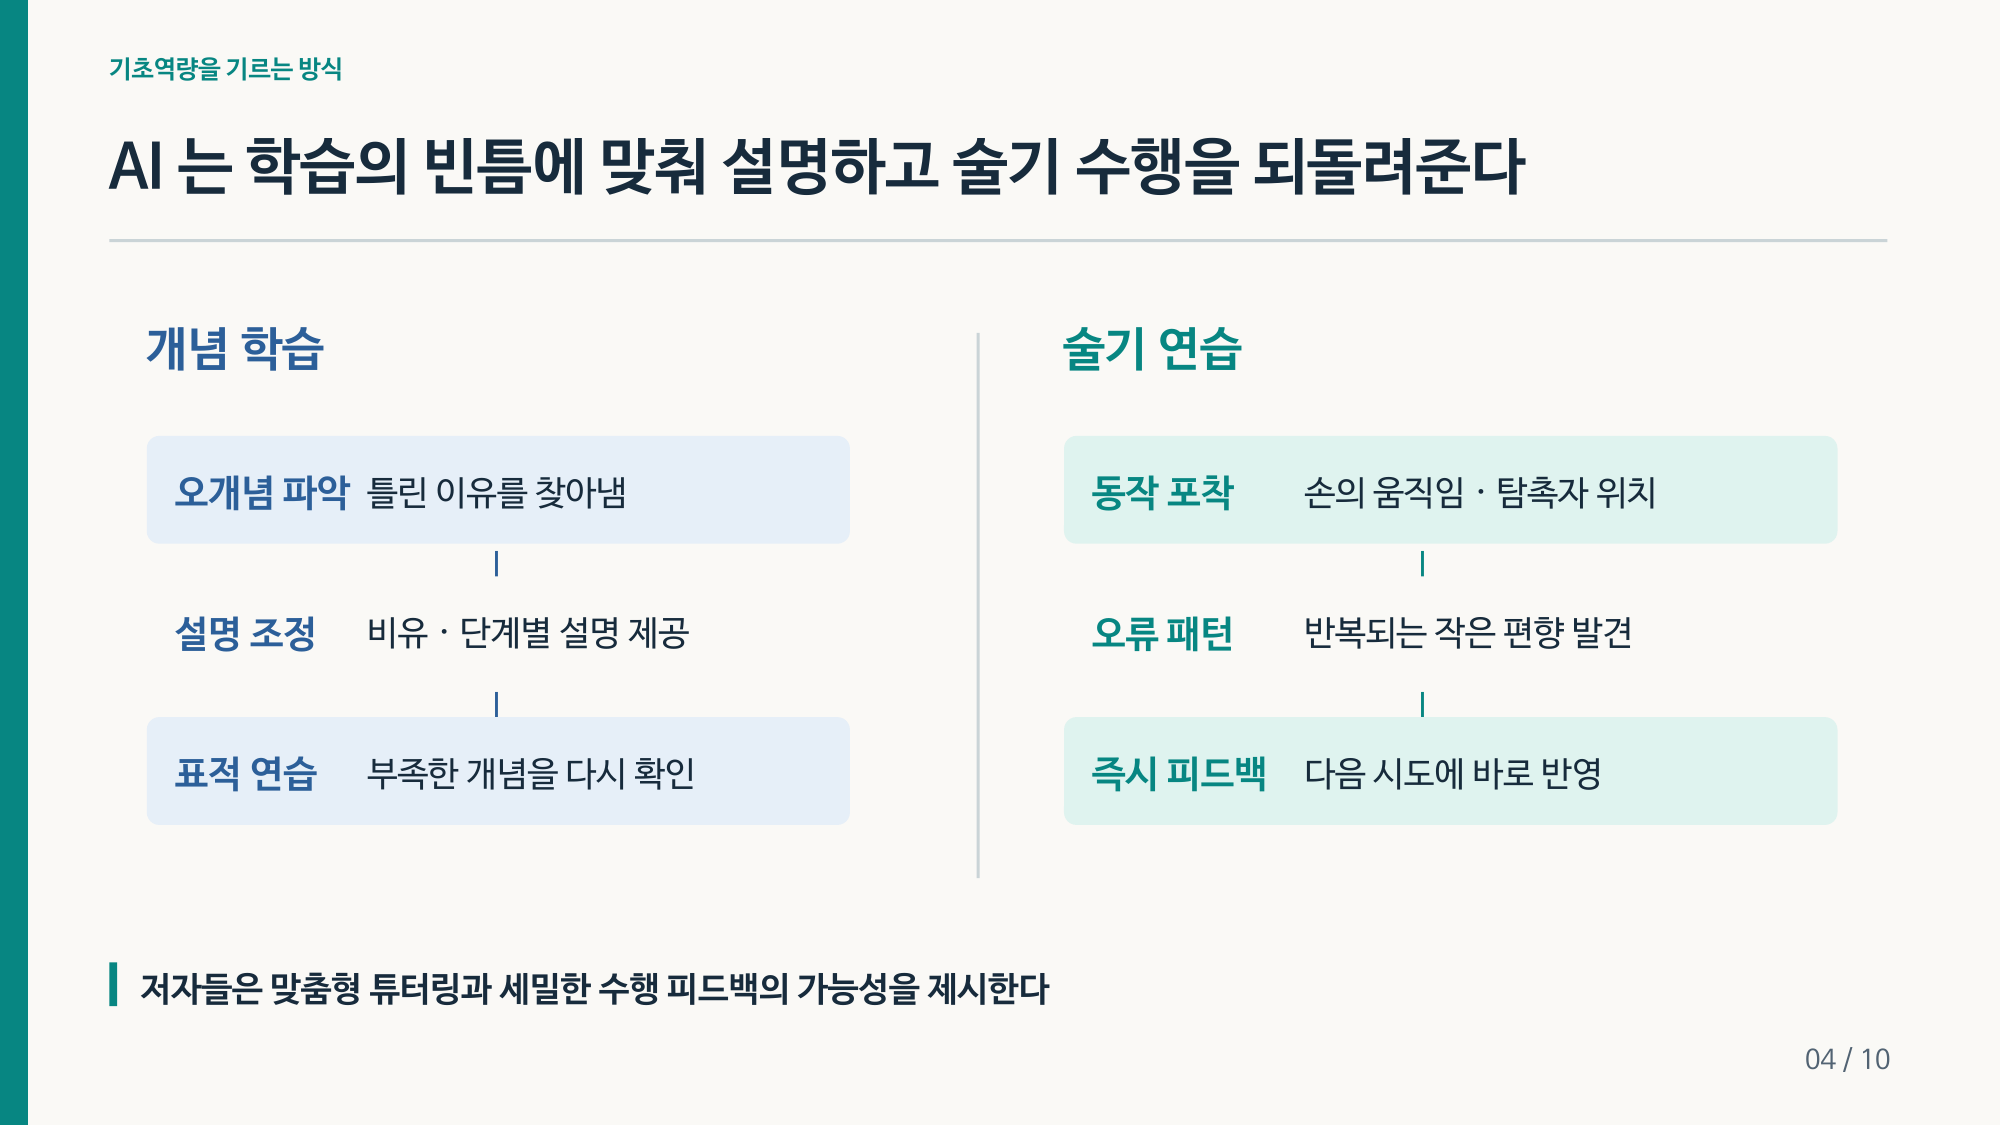
  • 학습자의 오개념을 찾아내고 수행 패턴에 맞춰 내용을 조정하는 개인화 튜터링
  • 같은 개념을 비유, 단계별 추론, 관련 질환과의 대비 등 여러 방식으로 설명해 주는 LLM
  • 새 문항을 대량으로 만들어 지식 영역을 더 넓게 표집하는 적응형 평가(adaptive testing)
  • 시뮬레이션에서 손 움직임, 프로브 위치, 자세를 실시간으로 분석하는 컴퓨터 비전. 예를 들어 삽관할 때 회전이 부족하다거나 초음파 압력이 일정하지 않다는 식의 미세한 경향까지 잡아내요.

그런데 저자들은 이건 "점진적 진화(incremental evolution)" 일 뿐이라고 해요.

근본적 전환

진짜 변화는 따로 있어요. AI가 근거를 즉시 찾아서 종합하고 설명해 준다면, 숙달은 더 이상 정보를 가지고 있는 것으로 정의되지 않아요. 의사의 인식론적 역할(epistemic role) 이 탐색, 검증, 해석으로 옮겨 간다는 거예요.

따라서 인지적 풍요는 정전적 역량을 "의사가 무엇을 알아야 하는가"에서 "의사가 지식 시스템과 어떻게 일하는가"까지 포함하도록 확장한다.
"Cognitive abundance therefore expands canonical competence from 'what clinicians must know' to include 'how clinicians work with knowledge systems.'"


구체적으로는 AI에게 어떤 질문을 던질지, 인용의 질을 어떻게 평가할지, 대안 진단을 어떻게 캐물을지, 모델의 답을 지역 프로토콜과 어떻게 맞출지 아는 능력이에요. 저자들은 이 변화를 근거중심의학(EBM)이 처음 등장했을 때의 변화에 견주면서도, 속도와 규모는 훨씬 크다고 봐요.


또 하나 중요한 점이 있어요. AI가 새로운 임상시험, 진료지침, 메타분석을 자동으로 반영하면 정전적 역량의 정의 자체가 고정된 것에서 계속 갱신되는 것으로 바뀐다는 거예요.

이런 환경에서 역량은 인식론적 겸손, 즉 지식이 역동적이며 신중한 해석이 필요한 복잡한 시스템을 통해 매개된다는 인식을 수반한다.
"In this environment, competence entails epistemic humility, awareness that knowledge is dynamic, and mediated through complex systems requiring careful interpretation."

인식론적 겸손(epistemic humility), 이 논문의 핵심 키워드 중 하나예요.


🏥 4. 맥락적 역량: 암묵적인 것이 보이기 시작한다

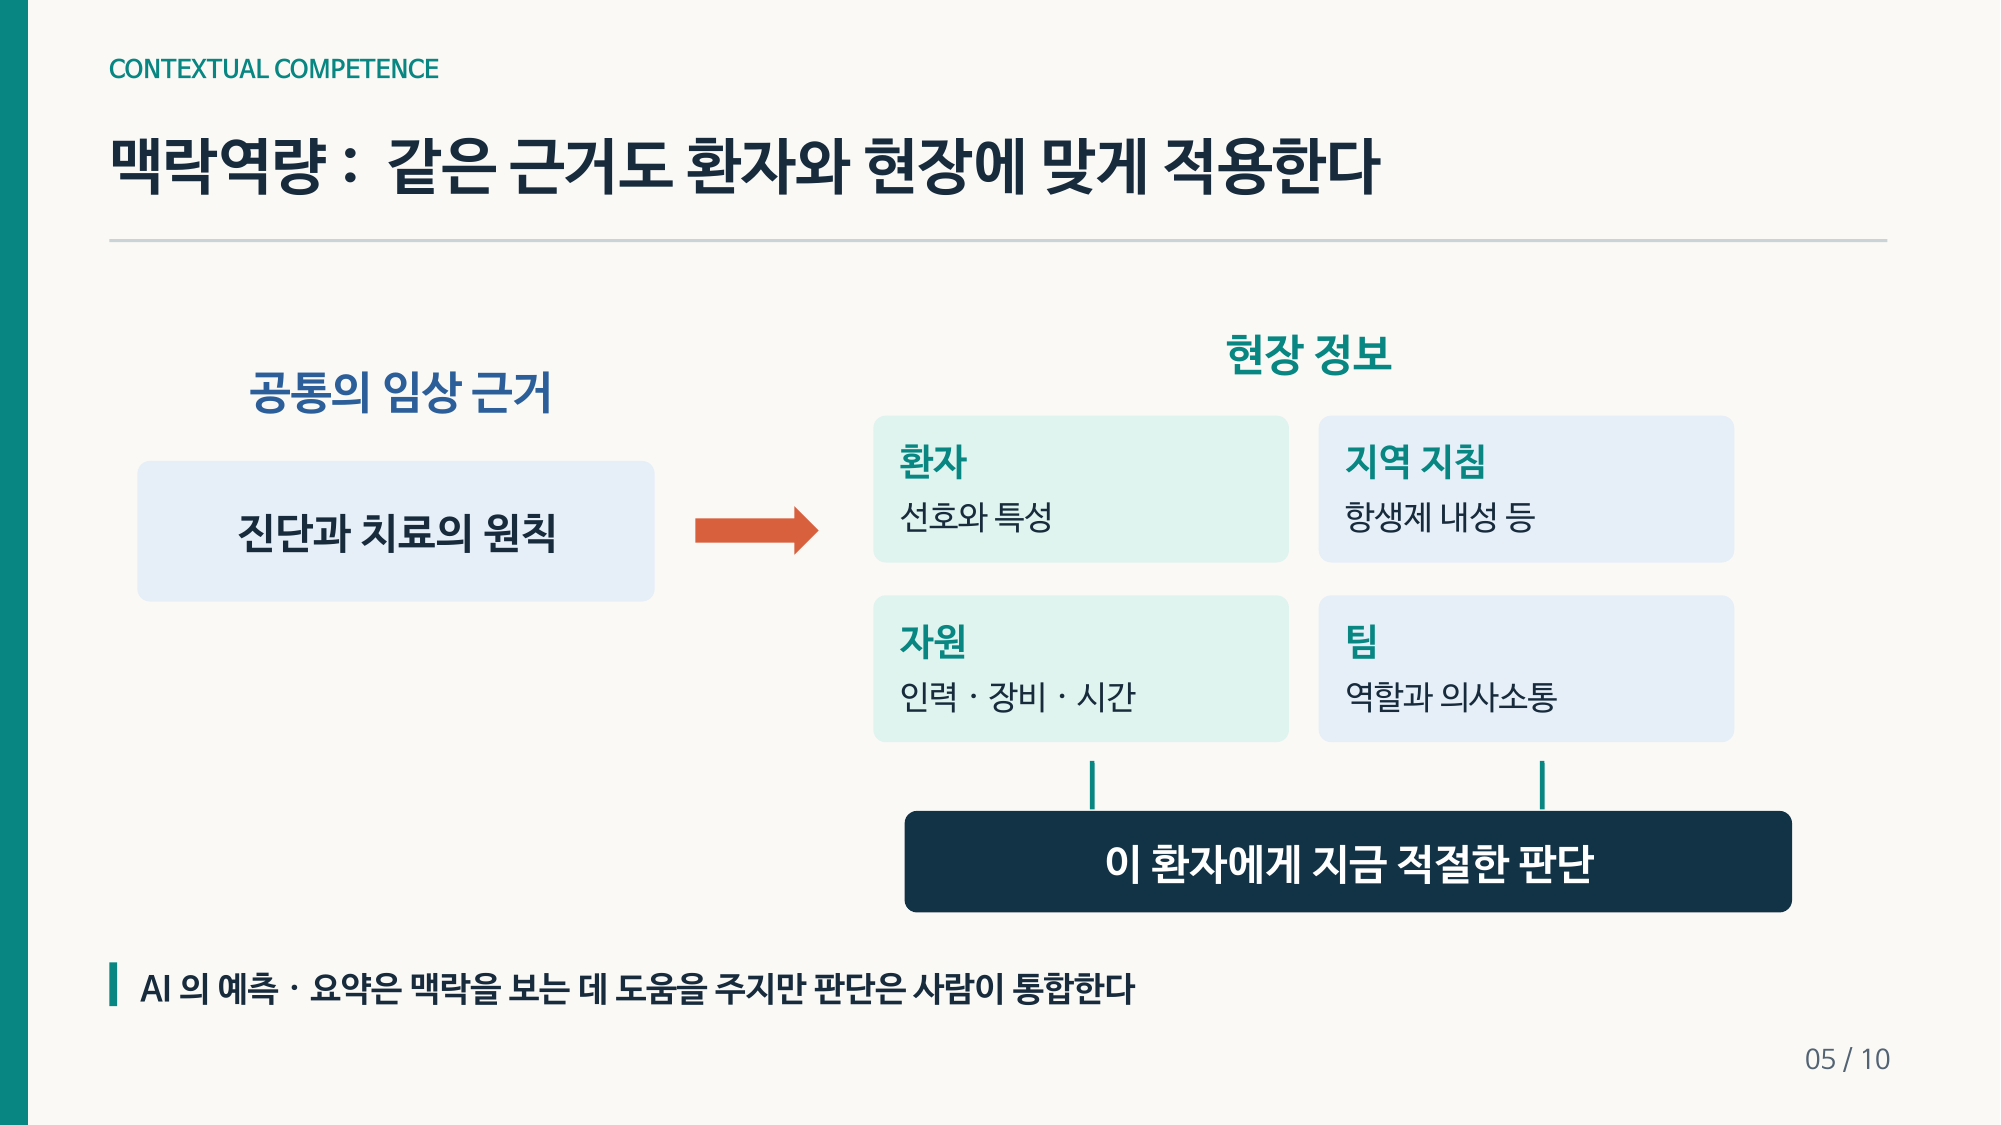
맥락적 역량은 상황 인식, 우선순위 판단, 적응력, 의사소통, 팀워크처럼 실제 임상 현장의 복잡성 안에서 지식과 기술을 쓰는 능력이에요. 전통적으로는 회진 중에 불문율을 익히고, 응급상황에서 어떤 신호가 중요한지 체득하는 식의 경험 학습과 암묵적 문화화(tacit enculturation) 로 길러졌죠. 강력한 방식이지만 느리고, 고르지 않고, 우연한 노출에 크게 의존한다는 한계가 있었어요.

점진적 개선

  • 지역 프로토콜, 항생제 내성 현황, 인력 배치, 자원 제약을 반영한 맥락 인식 의사결정 지원
  • 활력징후나 검사 결과의 미세한 변화로 상태 악화를 조기 예측하는 분석
  • 전자의무기록에서 특정 행동을 하면 패혈증 번들이나 항응고 지침을 띄워 주는 업무 흐름 통합형 마이크로러닝
  • 해당 기관의 흔한 동반질환, 합병증, 대응 시간, 자원 제약을 반영한 지역 맞춤형 시뮬레이션

근본적 전환

인지적 풍요 속에서는 맥락적 역량이 더 이상 "우연히 본 것"이나 "몇 안 되는 지도교수의 피드백" 에 묶이지 않아요. 기록 분석으로 추론 패턴을 보고, 의사소통 분석으로 말 끊기나 망설임, 전문용어 사용을 확인하고, 팀 매핑으로 누가 논의에 참여하고 누가 체계적으로 배제되는지까지 볼 수 있다는 거예요.


특히 인간-AI 혼합 팀(hybrid human–AI team) 이라는 새로운 역학이 생겨요.

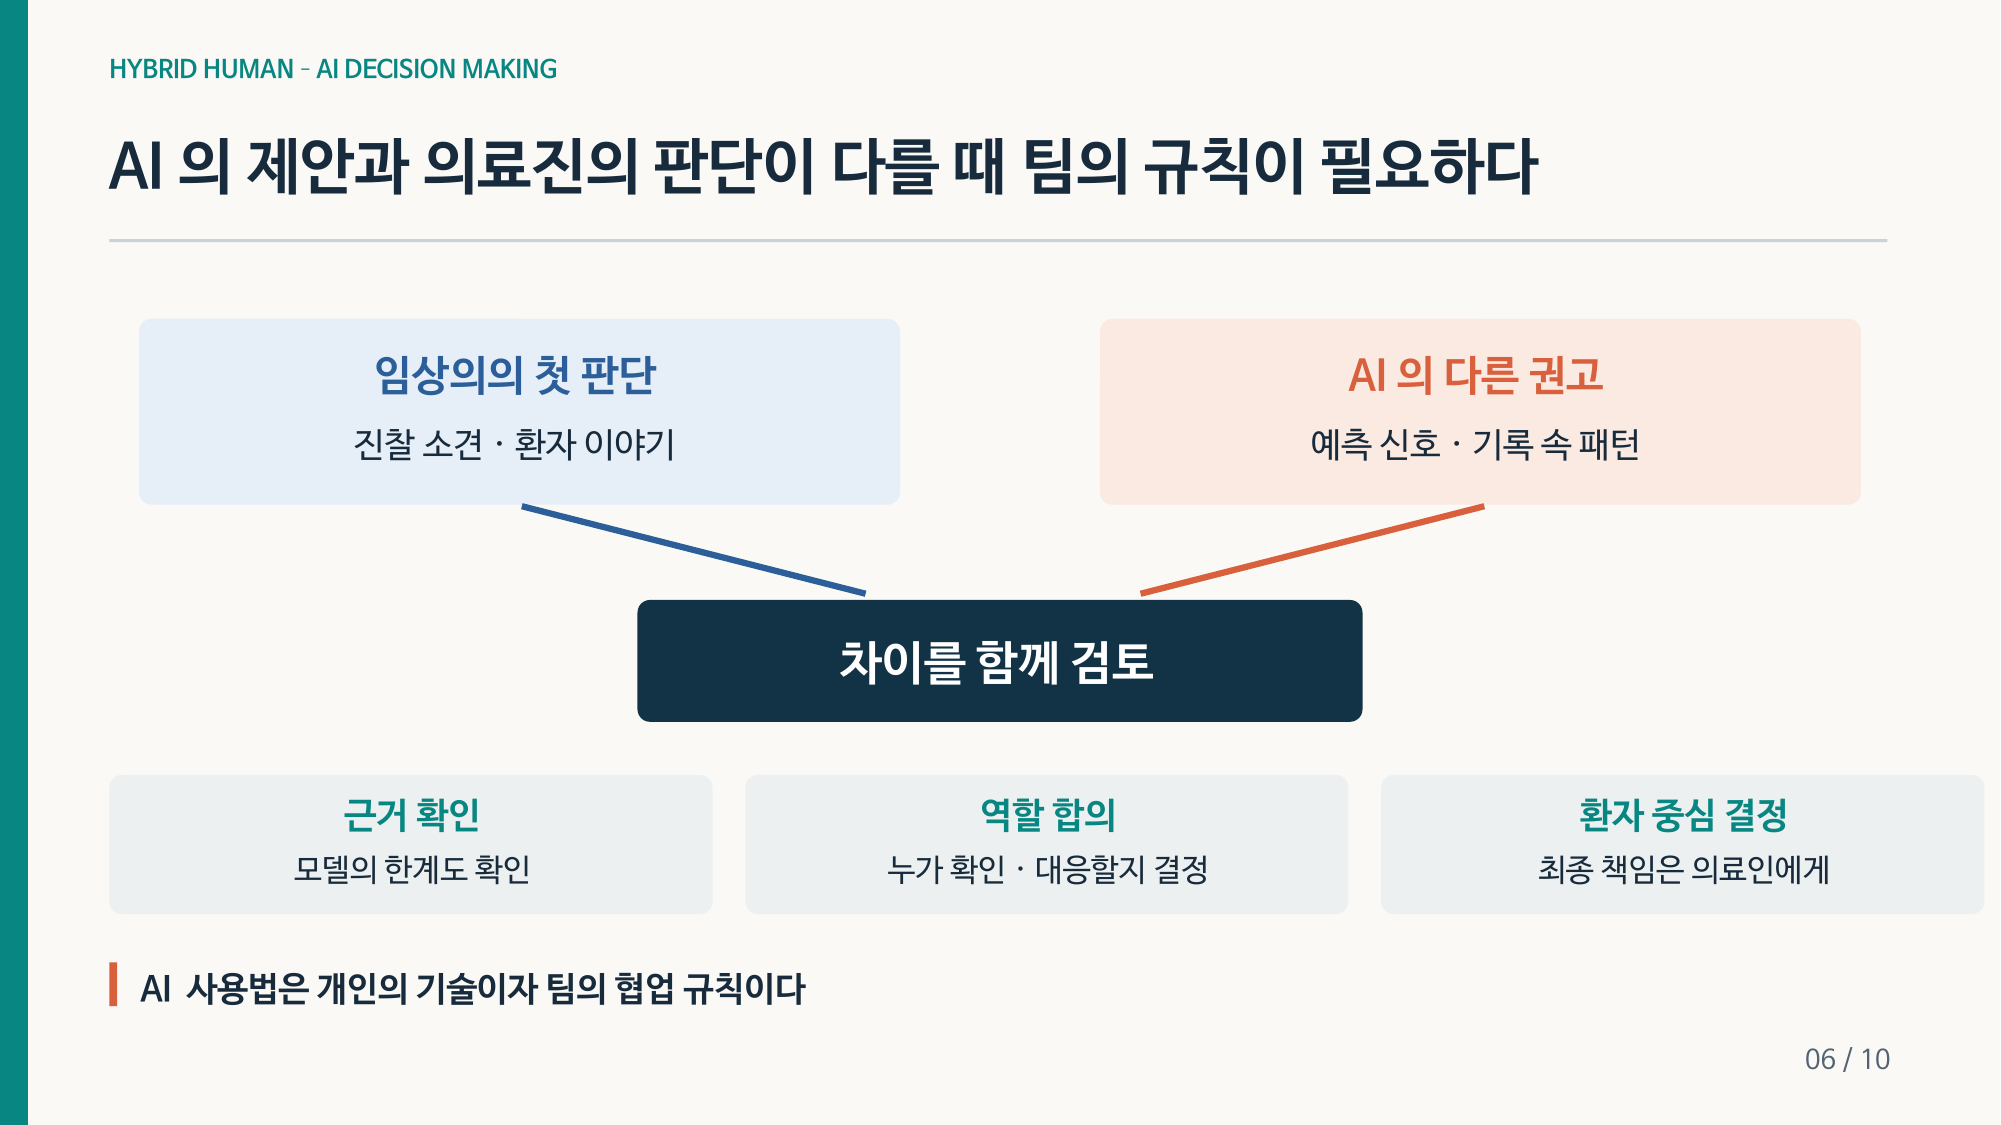
이는 새로운 형태의 조정을 요구한다. 누가 어떤 경보를 모니터링할지 정하고, 임상가의 판단과 모델 출력이 불일치할 때 어떻게 해결할지 명확히 하며, 팀 안에서 주의가 형평하게 배분되도록 하는 것이다. 좋은 팀원이 된다는 것은 이제 AI가 매개하거나 영향을 미치는 조정에 능숙하다는 것을 포함한다.
"This requires new forms of coordination: deciding who monitors which alerts, clarifying how disagreements between clinician judgment and model output are resolved, and ensuring equitable distribution of attention within the team. Being a good team member now includes fluency in AI-mediated/influenced coordination."


저자들은 이 층위의 변화를 이렇게 정리해요.

이러한 가시성은 맥락적 역량을 암묵적이고 경험적인 것에서 명시적이고 데이터 성찰적인 것으로 바꾼다. 우리는 이전에 볼 수 없었던 것을 보게 되고, 그것이 개선의 대상이 될 수 있게 된다.
"This visibility transforms contextual competence from tacit and experiential to explicit and data-reflexive. We see what we previously could not, allowing it to become a target for improvement."


🙋 5. 개인화된 역량: 좋은 의사에서 훌륭한 의사로

제가 가장 흥미롭게 읽은 부분이에요. 개인화된 역량은 가치, 대인관계 스타일, 성찰 능력, 웰빙, 정서적 안정, 전문직 정체성(professional identity) 을 포함해요. 세 층위 중에서 측정하고, 가르치고, 체계적으로 기르기가 가장 어려운 영역이죠. 그리고 무엇보다 이 층위는 전문가마다 정당하게 다를 수 있다는 특징이 있어요.

가장 중요한 것은, 이 역량이 전문가들 사이의 정당한 차이와 어떤 표준화된 평가로도 포착되지 않는 고유성을 함축한다는 점이다.
"Most importantly, it implies legitimate differences between professionals and a uniqueness that evades any standard assessment."

그리고 저자들은 이런 질문을 던져요.

AI는 어떻게 좋은 의사가 훌륭한 의사가 되도록 도울 수 있을까?
"How can AI support a good doctor to become a great doctor?"

AI가 할 수 있는 일

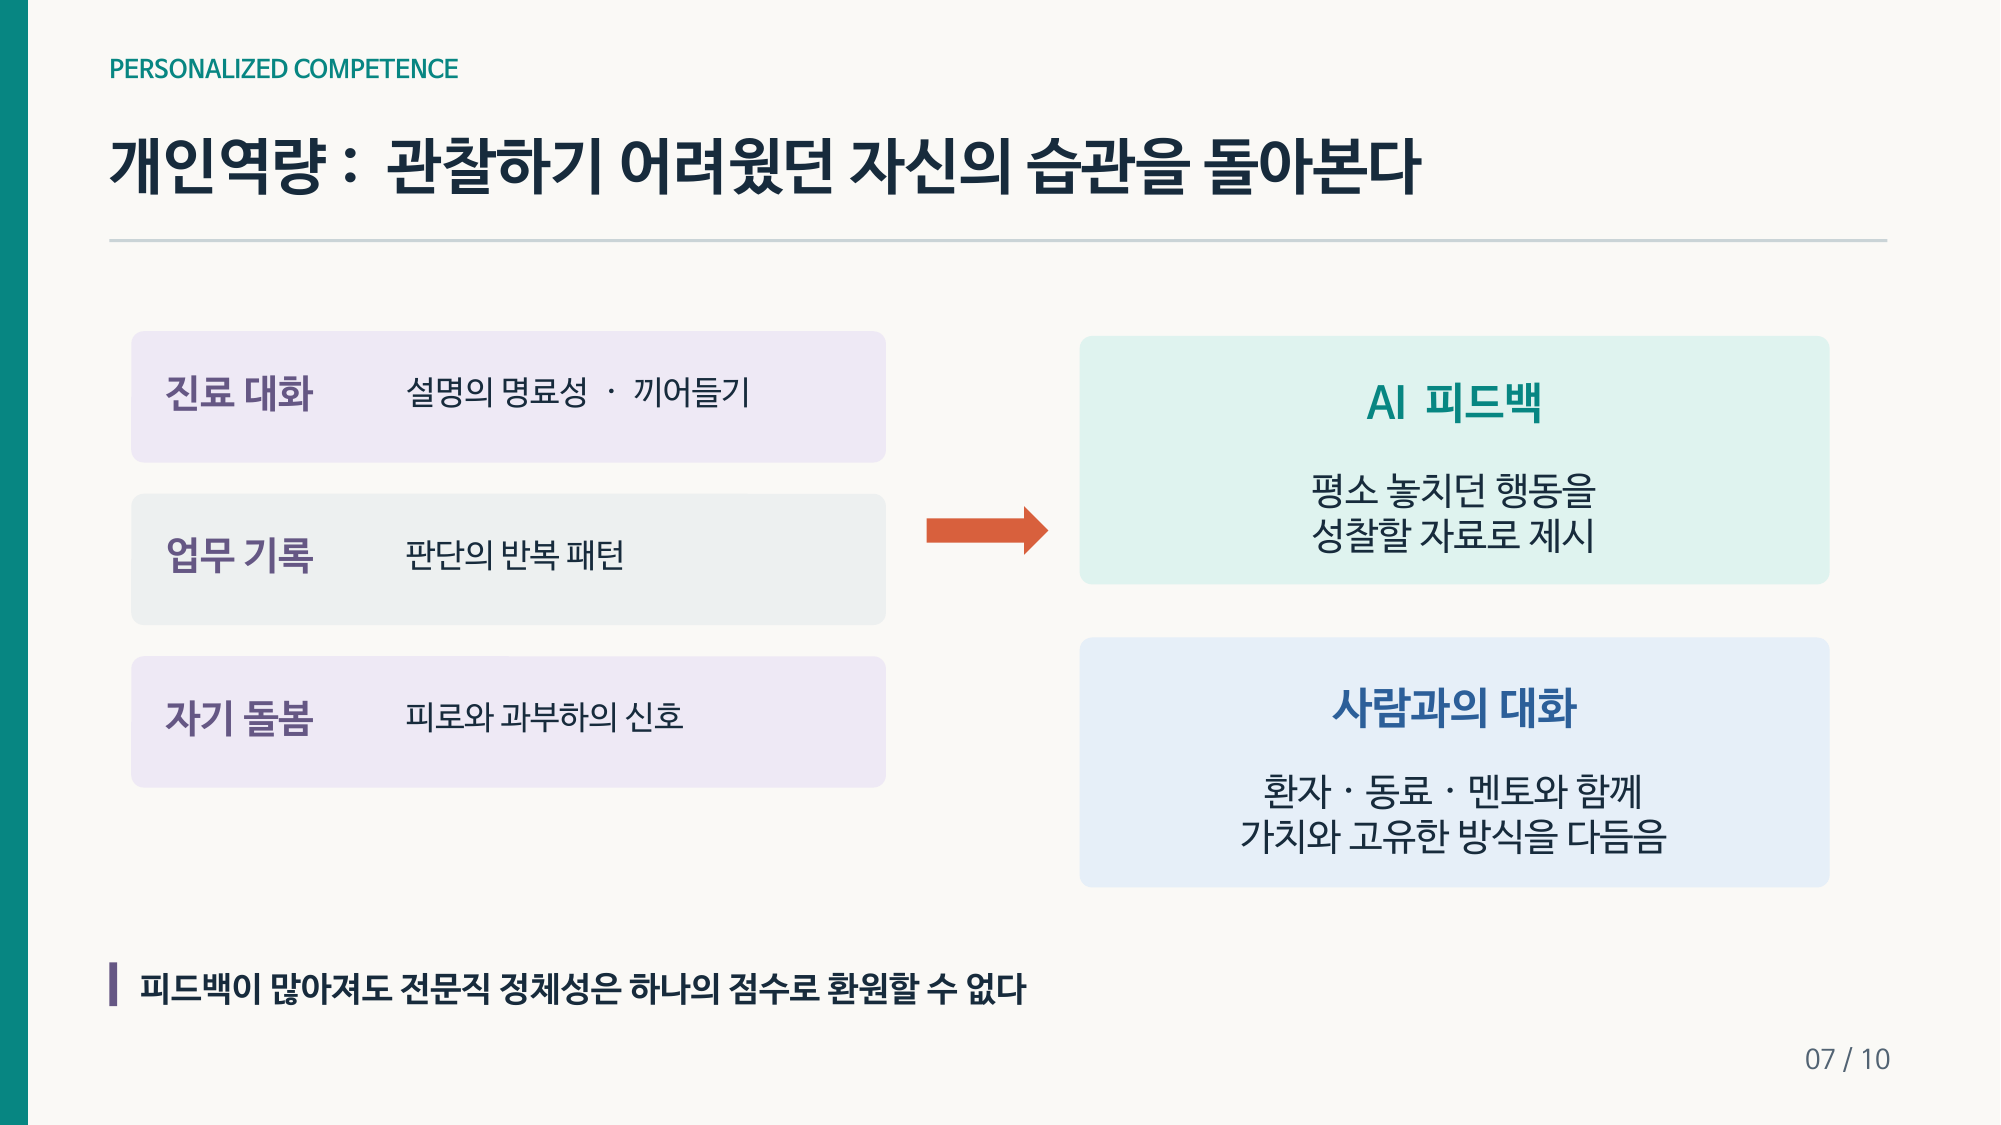
  • 💬 의사소통 분석: 진료 대화의 어조, 명확성, 말 끊기, 공감적 언어를 분석해요. 저자들은 이렇게 하면 대인관계 스타일이 "암묵적 특성에서 코칭 가능한 미시행동들(coachable microbehaviors)" 로 바뀐다고 봐요.
  • 📓 성찰 지원: AI 저널링, 서사의학 보조도구, 성찰 동반자(reflective companions) 가 숙련된 멘토처럼 "어떤 가정이 당신의 반응에 영향을 주었나요?" 같은 질문을 던져 줄 수 있어요. 시간 제약도 없고요.
  • 🔋 웰빙 분석: 기록 시간대, 받은편지함 부담, 미확인 결과 누적 같은 지표로 번아웃의 초기 신호를 알려 줄 수 있어요.

이런 데이터가 계속 쌓이면 정체성 형성이 가속될 수 있다고 저자들은 봐요. 어려운 대화에서 망설이는 경향이나 팀 회의에서 무심코 대화를 독점하는 습관처럼, 예전 같으면 몇 년 동안 모르고 지나갔을 모습을 발견할 수 있으니까요.

그래도 인간 멘토는 대체할 수 없다

저자들은 이 점에서는 분명한 입장이에요.

AI는 인간 멘토를 대체할 수 없다. 그들의 삶에서 우러난 지혜와 도덕적 안내는 여전히 대체 불가능하다. 하지만 AI는 24시간 피드백을 제공하고, 종단적 수행 데이터를 종합하며, 인간 관찰자가 놓칠 수 있는 강점과 기회를 찾도록 도움으로써 멘토링을 증강할 수 있다.
"AI cannot replace human mentors, whose lived wisdom and moral guidance remain irreplaceable. But AI can augment mentorship by offering 24/7 feedback, synthesizing longitudinal performance data, and helping clinicians identify strengths and opportunities that human observers might overlook."

⚠️ 윤리적 복잡성

물론 개인 데이터가 이렇게 세밀해지면 위험도 커져요. 지나친 자기비판, 알고리즘의 인정에 대한 과의존, 프라이버시 침해 같은 것들이요. 그래서 저자들은 메타기술(meta-skills) 이 필요하다고 해요. 자기 데이터와의 관계를 관리하고, 피드백을 분별력 있게 해석하고, 알고리즘의 통찰 속에서도 자율성과 인간다움을 지키는 능력이에요.


그리고 가장 근본적인 질문을 남겨요.

AI가 생성한 피드백은 인간 피드백에서 개인적 관계가 일으키는 왜곡을 없앨 수 있고 비공개로 유지될 수도 있지만,
중요한 윤리적 질문 하나는 이것이다. 이 믿을 수 없을 만큼 개인화된 데이터에 누가 접근하는가? 

"Although feedback produced by AI can remove distortions caused by personal relationships in human feedback, and can remain private, one important ethical question is: who has access to the incredibly personalized data?"


📊 6. 한눈에 보기: CPD 시스템은 어떻게 달라지나?

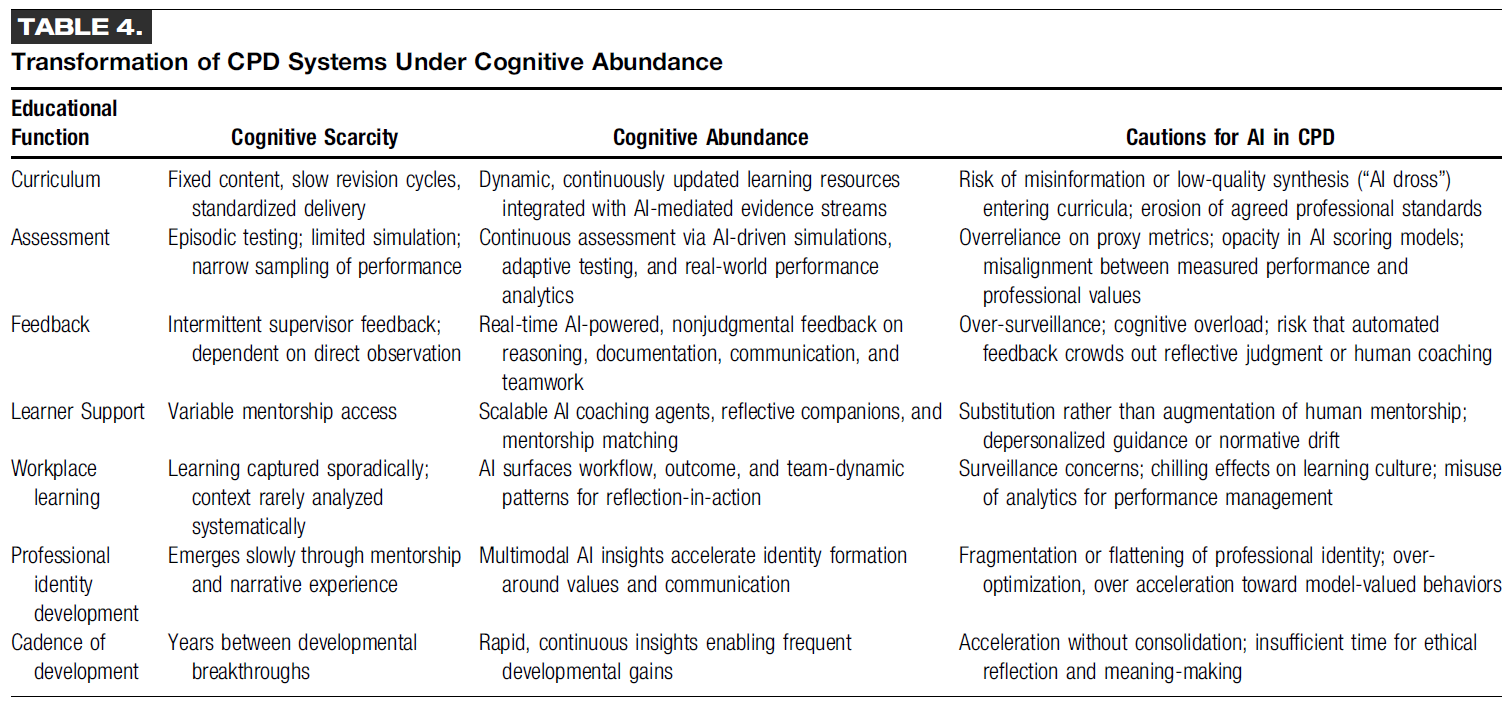
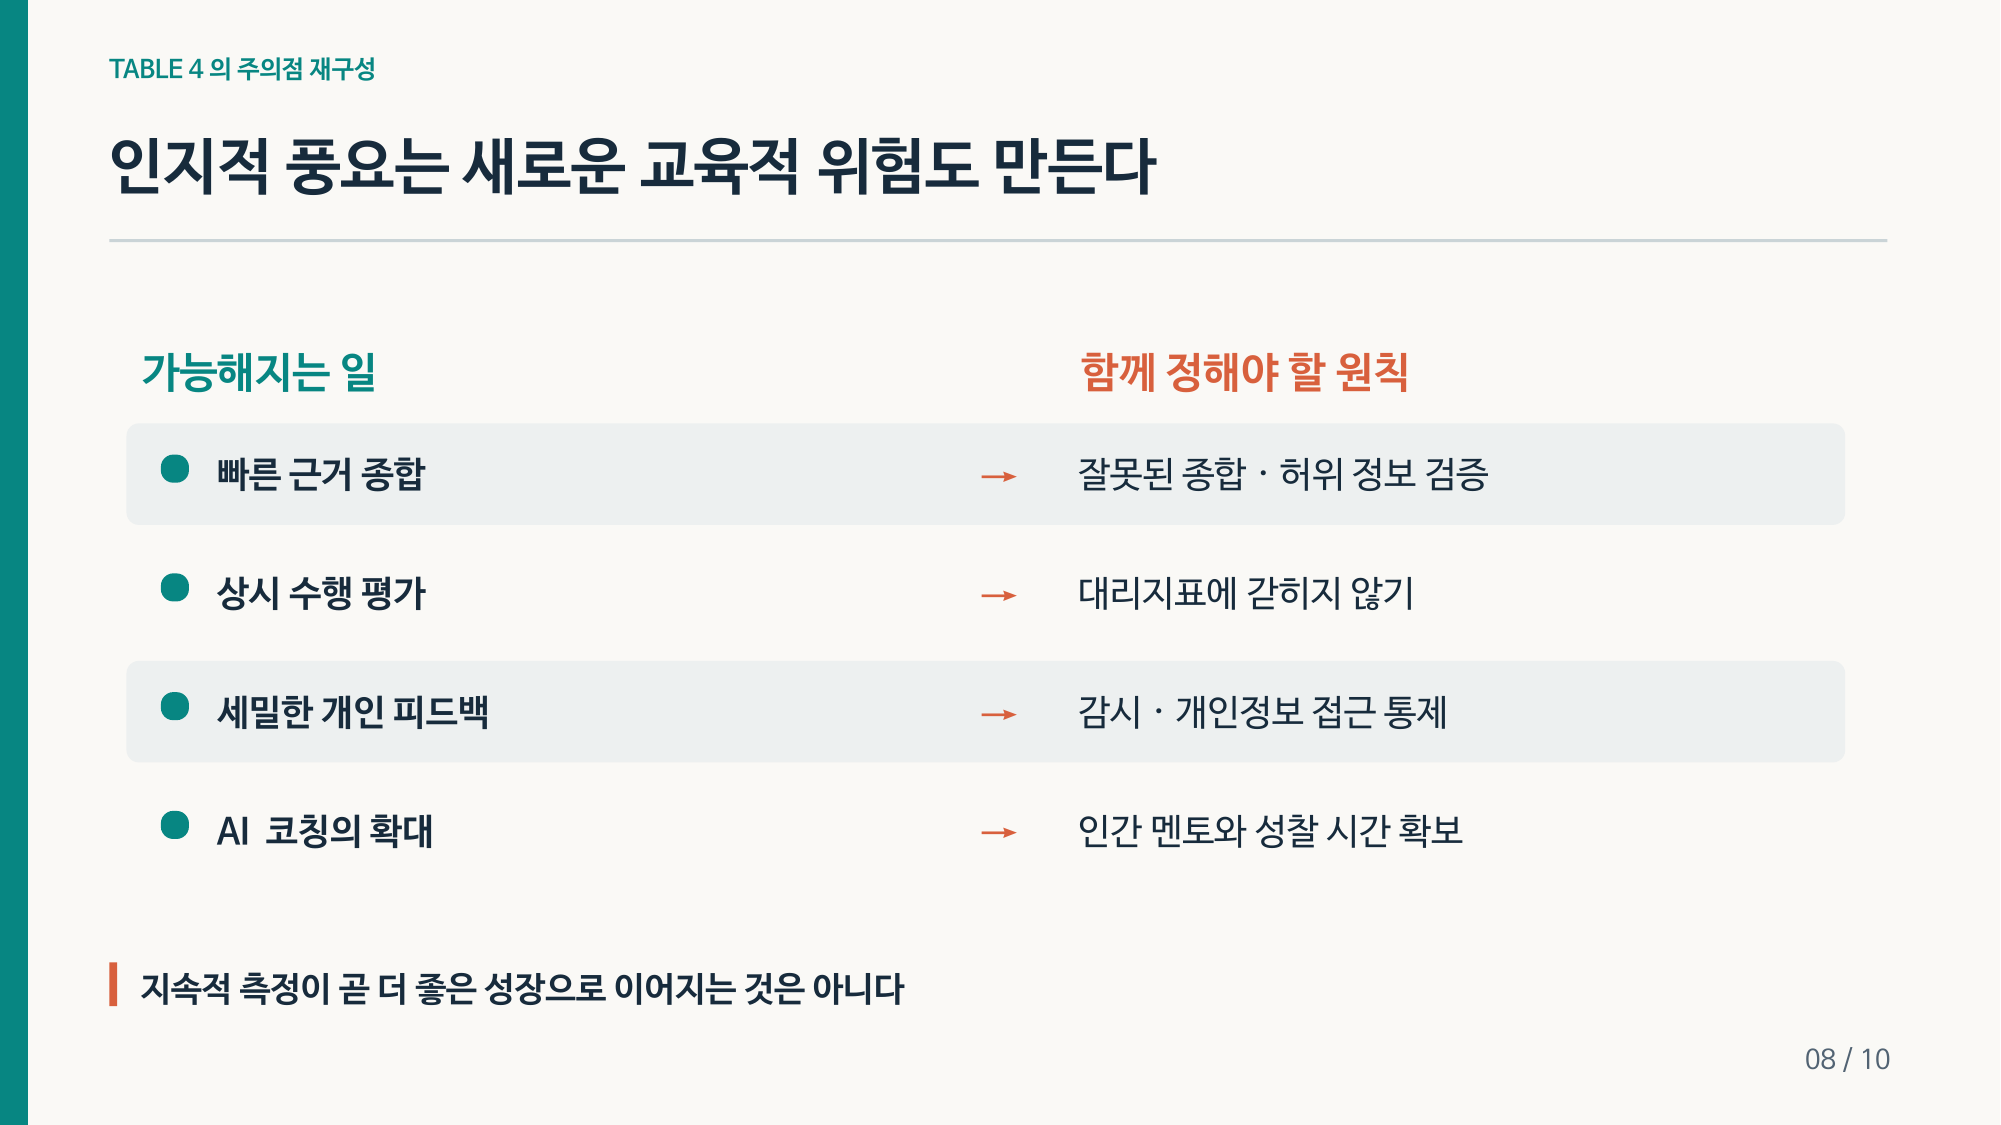
논문의 Table 4가 이 논의를 잘 정리하고 있어서 옮겨 볼게요. 저는 특히 오른쪽 "주의할 점" 칸이 이 표에서 가장 가치 있다고 생각해요.

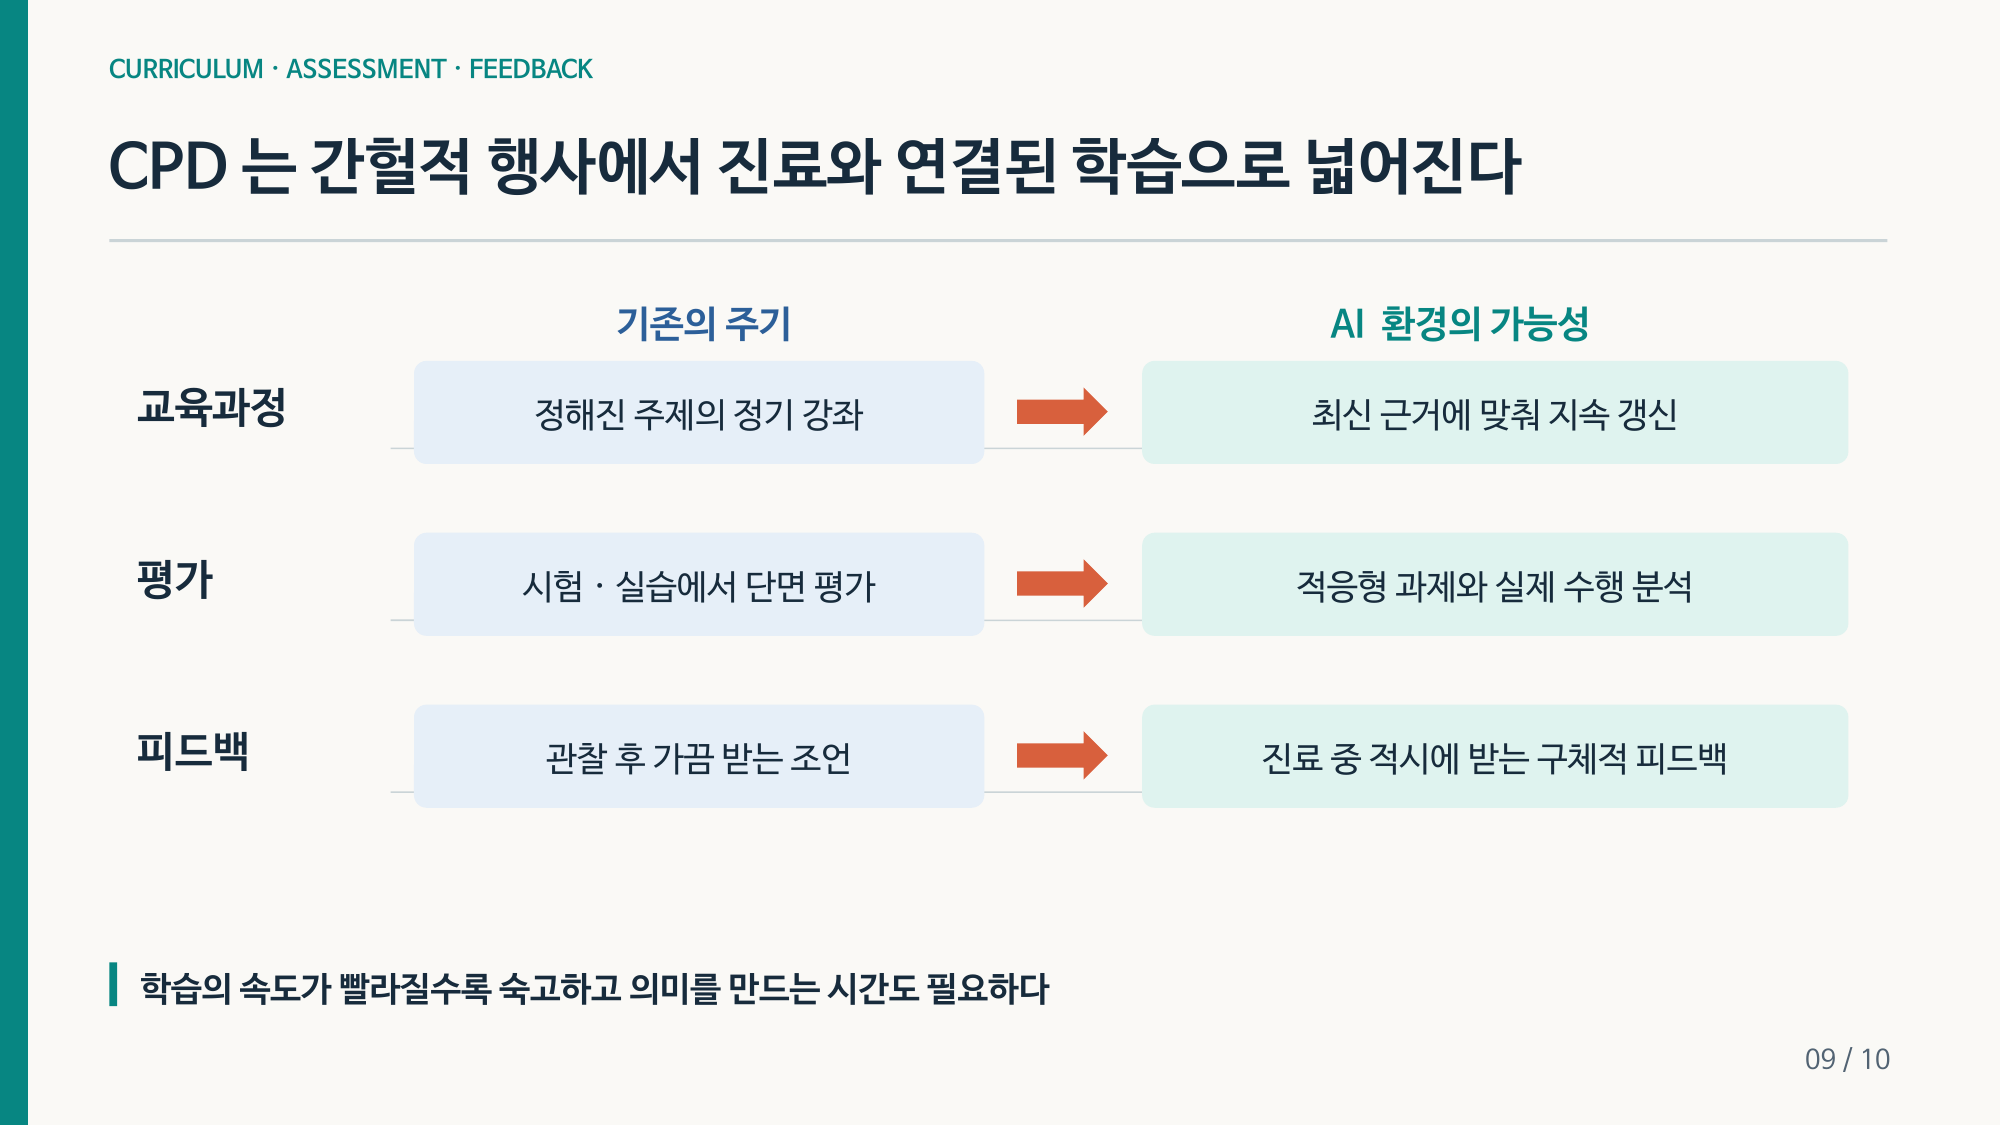
교육 기능 인지적 희소성 인지적 풍요 ⚠️ 주의할 점
교육과정 고정된 내용, 느린 개정 AI 근거 흐름과 연동되어 계속 갱신되는 자료 저품질 종합("AI 찌꺼기(AI dross)")의 유입, 합의된 전문 기준의 약화
평가 간헐적 시험, 좁은 수행 표집 AI 시뮬레이션, 적응형 평가, 실제 수행 분석을 통한 지속 평가 대리 지표 과의존, AI 채점의 불투명성, 측정된 수행과 전문직 가치의 불일치
피드백 간헐적 지도교수 피드백 추론, 기록, 소통, 팀워크에 대한 실시간 비판단적 피드백 과잉 감시, 인지 과부하, 자동 피드백이 성찰적 판단과 인간 코칭을 밀어낼 위험
학습자 지원 멘토 접근성의 편차 확장 가능한 AI 코칭, 성찰 동반자, 멘토 매칭 인간 멘토링의 증강이 아닌 대체, 몰개인화된 안내
작업장 학습 학습이 산발적으로만 포착됨 업무 흐름, 성과, 팀 역학 패턴을 행위 중 성찰에 활용 감시 우려, 학습문화 위축, 분석 결과의 인사평가 오용
전문직 정체성 멘토링과 서사적 경험으로 천천히 형성 가치와 소통에 대한 멀티모달 통찰로 정체성 형성 가속 정체성의 파편화 또는 평준화, 모델이 선호하는 행동으로의 과최적화
발달 주기 발달상 도약 사이에 수년 빈번한 발달적 성장 공고화 없는 가속, 윤리적 성찰과 의미 형성을 위한 시간 부족

🎯 7. CPD에 주는 다섯 가지 함의

저자들은 CPD가 더 이상 주기적 업데이트, 고정된 교육과정, 간헐적 평가를 중심으로 짜여서는 안 된다고 하면서 다섯 가지 방향을 제시해요.


  • ① AI 리터러시(AI literacy)를 기초 전문 기술로 📚
    • LLM, 예측 알고리즘, 멀티모달 시스템이 어떻게 작동하는지, 그리고 한계, 불확실성, 실패 양상(failure modes) 까지 이해해야 해요. 모델을 효과적으로 캐묻고, 근거를 검증하고, 환각을 알아보는 능력이 여기에 들어가요.
  • ② 혼합 의사결정(hybrid decision making) 준비 🤝
    • 결정은 이제 의사 혼자의 인지가 아니라 인간의 판단, 환자 가치, 조직 제약, 모델의 통찰이 상호작용해서 나와요. 그래서 불일치 협상(disagreement negotiation), 즉 AI가 내 판단과 다를 때 어떻게 대응할지, 그리고 상위 보고 경로 같은 메타역량이 필요하다고 해요.
  • ③ AI 사용에 대한 다직종 정합성(interprofessional coherence) 🩺
    • 위험 점수나 예측 같은 AI 신호는 팀 전체가 공유하는 정보예요. 그래서 간호사, 의사, 약사 등이 AI 도구에 대해 공유된 정신모형(shared mental models) 을 갖춰야 AI가 팀을 쪼개지 않고 오히려 강화할 수 있어요.
  • ④ 개인 분석 데이터에 대한 성찰적·윤리적 태도 🪞
    • CPD는 의사가 이런 정보를 건설적으로 해석하고, 알고리즘의 판단에 과하게 의존하지 않고, 자율성과 도덕적 행위주체성(moral agency) 을 지키도록 도와야 해요. 이를 위해 구조화된 성찰, 동료 토론, 교수 멘토링은 여전히 중요하다고 해요.


인지적 풍요는 피드백의 풍요도 뜻한다.
"Cognitive abundance also means feedback abundance."


  • ⑤ CPD 시스템 자체의 재설계 🔧


AI는 이러한 전환을 가능하게 한다. CPD는 그것을 일관되고, 안전하며, 교육적으로 타당하게 만들어야 한다.
"AI makes these transformations possible; CPD must make them coherent, safe, and educationally sound."


  • 그리고 심사위원의 지적을 받아들여 이런 단서도 달았어요.


AI가 임상 판단에 점점 더 참여할수록, CPD는 임상가의 도덕적 행위주체성을 강화하는 데 훨씬 더 중요한 역할을 한다.
"Indeed, as AI increasingly participates in clinical judgments, CPD has an even more important role in reinforcing the moral agency of clinicians."


✅ 8. 결론: AI에 가려지지 않고, AI로 강해지는 의사

저자들은 초록에서 꽤 대담한 예측을 해요.

의사의 장기기억 내용은 일상 진료를 이끄는 데 필요한 생의학적 사실이 주를 이루던 것에서, 임상적 의사결정을 위한 정보를 찾고, 선택하고, 그 타당성을 평가하는 데 필요한 새로운 절차적 탐구 기술로 옮겨 갈 것이다.
"The contents of long-term memory of clinicians will shift from a predominance of biomedical facts needed to steer daily clinical work, to new procedural inquiry skills needed to find, select, and evaluate the validity of information for clinical decision making."


그리고 AI 시대 역량을 이렇게 정의해요.

궁극적으로, AI 시대의 역량은 단지 의사가 무엇을 아는지, 또는 개별 과제를 어떻게 수행하는지의 문제가 아니다. 그것은 분산된 인지 시스템 안에서 현명하게 일하는 능력이다. 풍부한 정보와 인간의 통찰을 균형 있게 다루고, 알고리즘의 예측을 맥락의 미묘함과 통합하며, 멀티모달 데이터의 지원을 받아 지속적으로 성찰하는 능력이다.
"Ultimately, competence in the era of AI is not merely a function of what clinicians know or how they perform discrete tasks. It is the capacity to work wisely within distributed cognitive systems, balancing abundant information with human insight, integrating algorithmic predictions with contextual nuance, and engaging in continuous reflection supported by multimodal data."


마지막 문장도 옮겨 둘게요.

전문가 역량의 미래는 이 종합에 있다. AI에 가려지지 않고 AI로 강해지는 의사, 알고리즘에 의존하지 않고 알고리즘과의 사려 깊은 협력을 통해 힘을 얻는 의사다.
"The future of professional competence lies in this synthesis: a clinician who is not overshadowed by AI, but strengthened by it; not dependent on algorithms, but empowered through thoughtful partnership with them."


저자들은 이런 과정이 의사를 매슬로우의 표현처럼 "미지의 것에 비교적 겁먹지 않는(relatively unfrightened by the unknown)" 성숙한 임상가로 키울 수 있다고 기대해요.


💡 9. 읽으며 든 생각과 비판적으로 읽을 지점

마지막으로 제 생각을 덧붙일게요. 어디까지나 제 해석이에요.


  • ① 개념 논문이라는 점을 감안하기 🧐
    • 이 논문은 경험적 연구가 아니라 방향을 제시하는 글이에요. 저자들 스스로 "인지적 풍요"가 아직 정립된 구성개념이 아니라고 밝히고 있고요. 본문에서 소개한 AI의 가능성 중 상당수, 예컨대 성찰 동반자, 웰빙 분석, 팀 매핑은 아직 효과가 충분히 검증되지 않은 전망에 가까워요. 참고로 저자들은 ChatGPT를 표 초안, 문장 다듬기, 구조 정리에 썼다고 투명하게 밝혔어요.
  • ② 장기기억이 정말 덜 중요해질까? 🤔
    • 저는 이 부분이 가장 논쟁적이라고 봐요. 전문성 연구와 인지부하 이론은 대체로 장기기억 속 조직된 지식이 있어야 새로운 정보를 판단하고 활용할 수 있다고 보거든요. AI 답의 타당성을 평가하려면 결국 탄탄한 기초지식이 필요하다는 반론이 가능하죠. 앞서 소개한 Macy 재단 권고안도 기초과학 지식과 임상추론의 유지를 따로 강조했어요. 저자들도 인식론적 겸손과 검증 능력을 강조하니 완전히 반대 입장은 아니지만, "무엇을 머리에 남겨야 하는가"는 앞으로 경험 연구가 꼭 필요한 질문 같아요.
  • ③ 개인화된 역량과 감시의 긴장 👁️
    • 개인화된 역량은 원래 "전문가마다 정당하게 다를 수 있는" 영역인데, 이걸 데이터로 계속 들여다보면 모델이 선호하는 행동으로 평준화될 위험이 있어요. 저자들도 Table 4에서 이 점을 짚었죠. 전문직 정체성 형성(PIF)을 연구하는 입장에서 보면, AI 피드백이 정체성 형성을 돕는 도구로 남으려면 데이터 접근 권한과 사용 목적에 대한 명확한 원칙이 먼저 있어야 한다고 생각해요.
  • ④ 앞의 두 글과 이어서 보기 🔗
    • AAMC 기초역량은 "무엇을 갖춰야 하나"를 목록으로 제시했고, Macy 권고안은 "기관과 제도가 무엇을 해야 하나"를 다뤘어요. 이 논문은 한 걸음 물러서서 "역량이라는 개념 자체가 어떻게 바뀌나" 를 묻고 있어요. 세 글을 함께 읽으면 역량 목록, 제도 설계, 개념적 토대를 한꺼번에 볼 수 있어서 교육과정 개편이나 평생교육 설계를 고민하는 분들께 도움이 될 것 같아요.


📝 정리하며

  • Pusic과 ten Cate는 AI가 CPD의 전제를 인지적 희소성에서 인지적 풍요로 바꾸고 있다고 주장해요.
  • ten Cate의 다층 역량 모델(정전적, 맥락적, 개인화된 역량)로 분석하면, AI는 세 층위를 모두 강화하면서 동시에 그 의미를 바꿔요.
    • 정전적 역량: "무엇을 아는가"에서 "지식 시스템과 어떻게 일하는가"로. 핵심은 인식론적 겸손과 검증 능력이에요.
    • 맥락적 역량: 암묵적이고 경험적인 것에서 명시적이고 데이터 성찰적인 것으로. 인간-AI 혼합 팀에서 일하는 능력이 필요해요.
    • 개인화된 역량: 코칭 가능한 미시행동과 AI 성찰 지원으로 성장이 빨라질 수 있지만, 감시, 평준화, 데이터 접근 문제가 따라와요.
  • CPD는 AI 리터러시, 혼합 의사결정, 다직종 정합성, 개인 데이터에 대한 성찰적 태도, 시스템 재설계를 준비해야 해요.

함께 읽으면 좋은 글로는 이 논문의 분석 틀인 ten Cate 등(2024), "Medical competence as a multilayered construct"(Med Educ 58:93–104) 를 추천해요. 📎


보건의료인의 전문직업적 발달은 오랫동안 인지적 희소성의 제약을 받아 왔다. 이 용어는 행동경제학자 멀레이너선(Mullainathan)과 심리학자 샤피르(Shafir)가 2013년에 처음 제시한 것으로, 삶을 개선하는 데 필요한 자원이 부족하다는 걱정에 사로잡힌 사고방식을 나타낸다.1 이러한 제약은 돈, 시간, 음식, 수면, 사회적 지지 등 여러 모습으로 나타날 수 있지만, 많은 임상의는 연구의 최신 동향을 따라가고 진료를 깊이 성찰하며 최적의 진료를 제공하는 데 필요한 개인적 시간과 능력이 제한되는, 특정한 형태의 인지적 희소성을 경험해 왔다. 계속전문직업개발(CPD)의 구조는 이러한 병목을 수용하고 해결하도록 설계되었다. 여기에는 선별·정리된 최신 정보, 모듈형 평생의학교육(continuing medical education, CME) 활동, 간헐적 시뮬레이션이 포함된다. 활용 가능한 인지 자원이 제한되어 있었으므로 학습은 특정 시간과 장소로 한정될 수밖에 없었다. AI의 부상은 이러한 지형을 근본적으로 변화시켜 CPD의 조건을 인지적 희소성을 헤쳐 나가는 데서 인지적 풍요를 조직하고 활용하는 것으로 바꾼다.


인지적 풍요는 아직 동료심사 문헌에서 공식적으로 정립된 구성개념(construct)은 아니지만, 분산 인지, 디지털 증강(digital augmentation), 인공지능에 관한 연구의 교차점에서 자연스럽게 등장한다(표 1). 디지털 기술을 통해 활용되지 않던 인간의 인지 능력이 해방된다는 인지적 잉여(cognitive surplus) 개념2과 보건의료 및 교육에서 AI 매개 의사결정 지원(AI-mediated decision support)에 관한 연구3,4를 토대로, 인지적 풍요는 인지 자원에 대한 접근이 더 이상 인간의 한계에 의해 엄격하게 제약되지 않는 상태를 이해하는 틀로 볼 수 있다.


  • 인지적 풍요가 특징인 업무 환경에서 임상의는 방대한 문헌을 즉시 종합하고, 수행 데이터에 잠재된 패턴을 드러내며, 지속적인 성찰을 지원하는 AI 시스템을 일상적으로 활용할 수 있다. 이에 따라 인지는 개인이 희소성의 제약 속에서 수행하는 활동에서, 진료와 개인적 발달 모두에 활용되는 시스템 수준의 분산된 능력으로 이동한다.5
  • 이러한 틀은 걸러지지 않은 입력이 과도하여 인간의 주의와 의사결정에 부담을 주는 정보 과부하(information overload)와 구별된다. 오히려 인지적 풍요는 해석할 수 있고 행동으로 옮길 수 있는 인지적 지원을 이용할 수 있어 인지 부담을 가중하기보다 줄일 수 있는 상태를 가리킨다.6
  • 인지적 풍요가 인지적 노력이나 판단의 부재를 뜻하는 것은 아니다. 이는 인지가 생산·공유·관리되는 방식의 근본적인 변화를 뜻하며, 단순한 효율 향상을 넘어 전문직 역량, 책임, 학습에 영향을 미친다.


AI가 가져온 변화는 CPD에 핵심 질문을 제기한다. 임상의가 더 이상 생의학적 정보의 유일한 처리자는 물론 유일한 보유자도 아닐 때, 역량을 어떻게 이해하고 함양해야 하는가? 저자들은 텐 카터 등이 2024년에 제안한 다층적 역량 모델(multilayered competency model)을 사용하여 가능한 함의를 논의한다.7 이 모델은 세 층으로 이루어진다.


  • 정전적 역량(canonical competence)은 확립된 기초 생의학 지식과 기술적 술기, 곧 ‘모두가 알아야 하는 것’을 포괄한다.
  • 맥락적 역량(contextual competence)은 임상 시스템의 복잡성과 다양한 맥락 속에서 수행하는 능력을 나타낸다.
  • 개인화된 역량(personalized competence)에는 개인의 가치, 개인적 정체성과 융합된 전문직 정체성, 개인적 발달 방향을 결정하는 성찰 능력, 개인 특유의 스타일이 포함된다.


AI는 각 층을 강화하면서도 학습하고 추론하며 전문직으로 성장한다는 것의 의미를 다시 빚는다.


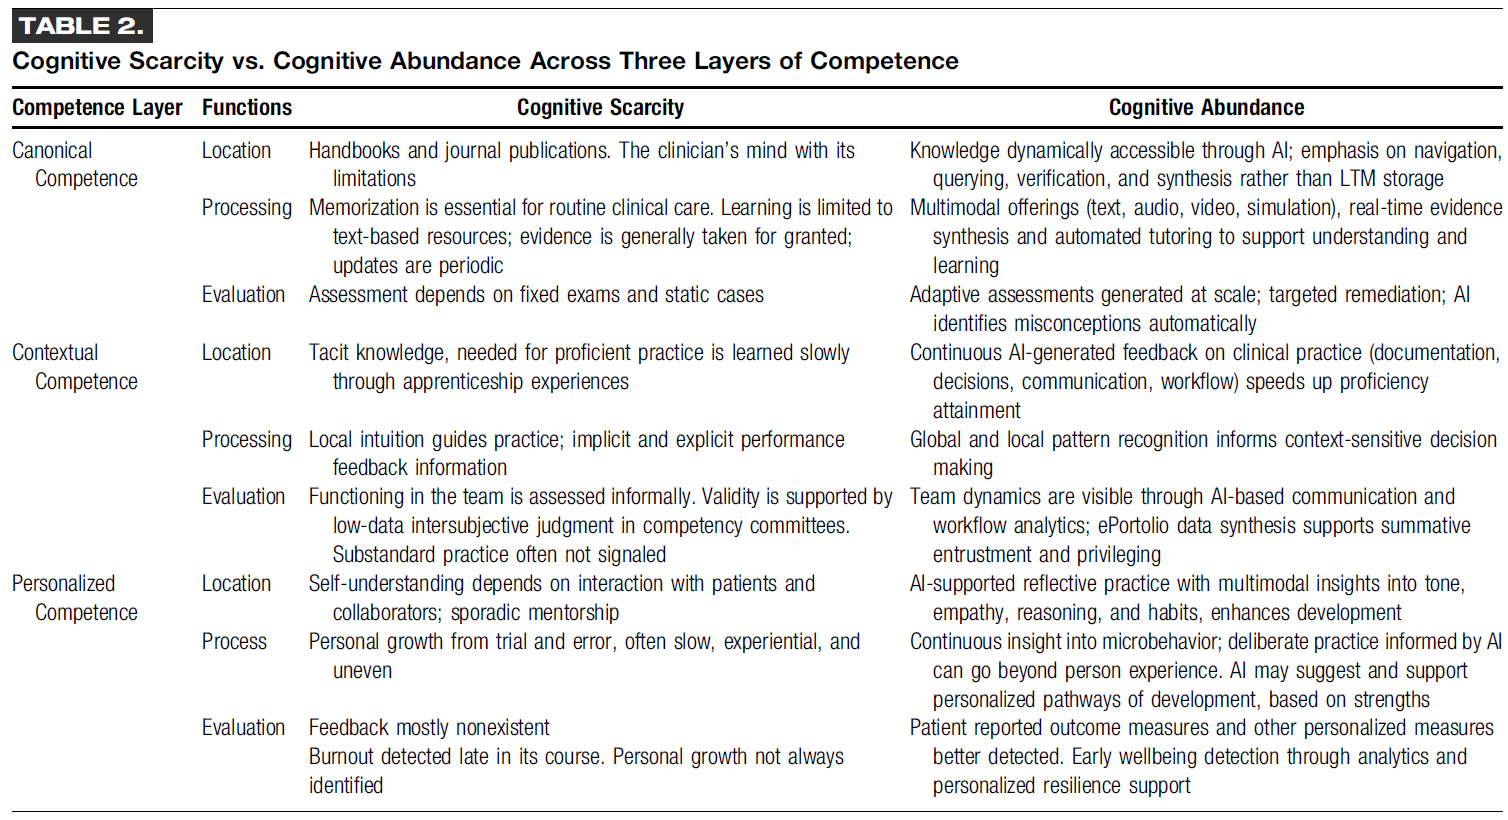
이제 막 시작된 전문직 역량의 학습·유지·확장에 관한 AI 혁명은 1990년대에 시작되어 관련 정보와 교육에 대한 보편적 접근, 학습분석 정보의 수집 등을 통해 CPD를 개선했던 인터넷 혁명 위에 구축된다.8,9 온라인 지식 종합은 관련 정보에 더 효율적으로 접근하게 했지만, AI는 정보 검색의 효율성을 높이는 데 그치지 않고 임상추론 지원을 포함한 인지적 처리 기능까지 더한다.8 표 2는 이러한 사고방식의 변화가 임상 역량의 다차원적 층위에 어떤 영향을 미치는지 개괄한다.


표 1. 주요 용어 해설 (Glossary of Key Terms) 

용어 이 논문에서의 정의
AI: 대규모 언어 모델(large language model, LLM) 대규모 텍스트 말뭉치(corpus)로 학습하여 자연어를 생성·요약·해석하고 자연어에 관해 추론하는 인공지능 시스템의 한 부류. 설명, 종합, 문서 작성 지원, 대화형 상호작용에 흔히 사용된다.
AI: 다중양식 분석(multimodal analysis) 텍스트, 이미지, 오디오, 비디오, 생리학적 신호, 구조화된 데이터 등 여러 데이터 양식을 통합·분석하여 어느 한 양식만으로는 얻을 수 없는 통찰을 만들어내는 인공지능 접근법.
인지적 풍요(cognitive abundance) AI 기반 시스템을 통해 분석·생성·해석을 위한 인지 자원을 손쉽게 이용할 수 있어 개인과 팀이 인간 개인의 한계를 넘어 종합된 지식, 피드백, 성찰적 통찰에 접근할 수 있는 상태.
인지적 희소성(cognitive scarcity) 시간, 주의, 전문성, 피드백, 분석 지원과 같은 인지 자원에 대한 접근이 제한되어 학습·성찰·의사결정의 질이 제약되는 상태. 최근까지 임상 교육과 진료의 특징이었다.
분산 인지(distributed cognition) 인지 과정이 개인의 마음에 국한되지 않고 사람, 도구, 기술, 환경에 분산되어 있다는 이론적 관점. 임상 환경에서는 임상의, 인공물(artifacts), 의사결정 지원 시스템의 상호작용에서 추론이 나타난다.
정보 과부하(information overload) 들어오는 정보의 양이나 복잡성이 개인의 효과적인 처리 능력을 넘어서 판단 저하, 인지적 부담 증가, 최적에 못 미치는 의사결정을 초래하는 상태.
다층적 역량(multi-layered competence) 서로 의존하는 세 층으로 구성된 전문직 역량의 개념 모델. 정전적 역량(기초 지식과 기술적 술기), 맥락적 역량(특정 임상·조직·팀 맥락에서 그 토대를 효과적으로 적용하는 능력), 개인화된 역량(임상의가 자신의 역할을 고유하게 수행할 때 나타나는 가치, 전문직 정체성, 성찰 능력, 대인관계 특성)으로 이루어진다.

인지적 풍요 속의 정전적 역량 (Canonical Competence Under Cognitive Abundance) 

정전적 역량은 안전하고 효과적인 진료를 뒷받침하는 기초 지식과 기술적 술기를 뜻한다. 텐 카터 등의 다층적 모델에서 이 층은 맥락과 무관한 생의학, 생리학, 약리학, 진단 도식(diagnostic schema), 전문직업성(professionalism), 기술적 수행을 포괄한다. 역사적으로 정전적 역량은 구조화된 교육과정, 전문의 자격시험(board examinations), 술기 훈련, 개별적인 독서를 통해 주로 형성되었다. 이는 희소성으로 규정된 인지 경제를 반영하는 활동이다. 임상의는 읽을 시간이 있는 만큼만 숙달할 수 있었고, 평가는 계속 커지는 전체 지식 영역에서 점점 더 집중된 일부를 표집했으며, 술기의 발달은 인간 교육자, 증례 경험, 고정된 시뮬레이션에 크게 의존했다. 최근까지 진료 현장에 그러한 지식을 가져오는 주체는 임상의뿐이었다.


인공지능은 정전적 정보의 범위, 접근성, 적응성을 확대함으로써 이 지형을 변화시킨다.10,11 AI 기반 학습 환경은 핵심 기초과학의 개인별 보충 학습을 제공하고, 특정 오개념을 찾아내며, 학습자의 변화하는 수행 양상에 따라 내용을 맞춤형으로 전달할 수 있다. 대규모 언어 모델은 같은 개념을 비유, 단계별 추론, 관련 병리와의 대조 등 여러 방식으로 설명할 수 있다. 이는 인간 교사의 반응성을 닮았지만 언제든 이용할 수 있다. 평가에서는 적응형 검사 시스템(adaptive testing systems)이 새로운 문항을 대규모로 생성하여 지식 영역의 표집 범위를 넓히고 학습 결손을 더 정확하게 진단할 수 있게 한다.


AI는 정전적 역량의 술기 및 기술 측면도 강화한다. 시뮬레이션 실습실의 컴퓨터 비전 시스템(computer vision systems)은 손의 움직임, 탐촉자(probe)의 위치, 인체공학적 정렬(ergonomic alignment)을 실시간으로 평가하여 인간 관찰자가 신뢰성 있게 포착하기 어려운 세밀한 지표를 만든다.12,13 자동화된 오류 패턴 분석은 기관삽관 시 회전 부족이나 초음파 검사 시 일정하지 않은 압력처럼 미묘한 경향을 찾아내어 목표 지향적 연습을 안내할 수 있다. 이러한 시스템은 전문가 수준의 피드백에 대한 접근을 넓힌다.


그러나 이러한 개선은 정전적 역량 발달의 점진적 진화에 불과하다. 더 깊은 변화는 인지적 희소성에서 인지적 풍요로의 이동에서 나온다. AI 시스템이 생의학적 근거를 즉시 검색·종합·설명할 수 있을 때, 숙달은 더 이상 주로 정보를 소유하는 것으로 정의되지 않는다. 대신 임상의의 인식론적 역할(epistemic role)은 탐색, 검증, 해석으로 이동한다.

  • AI 모델에 어떤 질문을 할지,
  • 그 인용의 질을 어떻게 평가할지,
  • 대안적 진단을 어떻게 탐색할지,
  • 모델의 출력을 지역 진료지침과 어떻게 조화시킬지
  • ...를 아는 것이 정전적 진료의 더 중심적인 구성요소가 된다.

따라서 인지적 풍요는 정전적 역량을 ‘임상의가 무엇을 알아야 하는가’에서 ‘임상의가 지식 시스템과 어떻게 협력하는가’까지 확장한다. 임상의는 AI 도구에서 설명 가능한 추론(explainable reasoning)을 이끌어내고, 환각(hallucinations)을 발견하고, 모델과 근거의 불확실성(model/evidence uncertainty)을 이해하며, 종합된 근거를 환자별 요인과 통합하는 데 능숙해져야 한다. 이는 근거중심진료(evidence-based practice)가 처음 등장했을 때와 같은 과거 의학의 변화를 닮았지만, 훨씬 빠르고 큰 규모로 일어난다.


마지막으로, 정전적 역량의 정의는 정적이고 주기적으로만 갱신되는 것에서 동적이고 지속적으로 새로워지는 것으로 바뀐다. AI 시스템이 새로운 임상시험, 진료지침, 메타분석을 자동으로 통합함에 따라 지식의 지형은 실시간으로 변한다. 인지적 풍요 속에서 진료하는 임상의는 이러한 변화를 포착하고 해석하며, 그 함의를 이해하고, 이에 맞게 진료를 조정할 준비가 되어 있어야 한다. 이런 환경에서 역량에는 인식론적 겸손(epistemic humility), 지식이 역동적이라는 인식, 신중한 해석이 필요한 복잡한 시스템을 통해 지식이 매개된다는 인식이 포함된다.


요약하면 AI는 정밀한 개인지도(precision tutoring), 평가 범위의 확대, 술기 피드백의 향상을 통해 정전적 역량의 습득을 강화한다. 동시에 임상의의 인식론적 역할을 종합된 근거의 검증 능력과 AI가 매개한 통찰을 책임 있게 통합하는 능력으로 이동시켜 정전적 역량이라는 개념 자체를 근본적으로 바꾼다.


1. 과거의 기본기: "얼마나 내 머릿속에 많이 담고 있는가?" (인지적 희소성 시대) 과거에는 의사가 기초 지식과 진료 기술(정전적 역량)을 갖추려면, 정해진 교육과정을 거치며 교과서를 읽고 외우고 시험을 봐야 했습니다. 사람이 학습할 수 있는 시간과 정보량에는 한계가 있기 때문에, 의사의 능력을 평가할 때는 방대한 의학 지식 중 '얼마나 많은 정보를 머릿속에 소유하고 있는지'가 중요했습니다.

2. AI가 가져온 1차적 변화: 학습과 훈련의 고도화
AI는 의사들이 이 기본기를 배우는 과정을 훨씬 쉽게 만들어 줍니다.

  • 지식 학습: AI가 24시간 대기하는 개인 과외선생님처럼 학습자의 수준에 맞춰 지식을 설명해 주고, 부족한 부분을 찾아냅니다.
  • 실습 훈련: 시뮬레이션 실습을 할 때, AI 카메라(컴퓨터 비전)가 초음파를 쥔 손의 미세한 움직임이나 각도까지 실시간으로 분석해 사람이 잡아내기 힘든 정교한 피드백을 줍니다.
3. 가장 중요한 변화: "지식을 외우는 것에서, AI와 협력하는 것으로" (인지적 풍요 시대) 논문은 앞서 말한 교육 방식의 발전보다 더 근본적인 변화에 주목합니다. 이제는 AI가 모든 의학 지식을 즉시 검색하고 요약해 주는 '정보가 넘쳐나는 시대(인지적 풍요)'가 되었습니다. 따라서 이제 훌륭한 의사의 기준은 단순히 '지식을 많이 아는 것'이 아닙니다.

지식은 AI가 찾아주니, 의사의 역할은 '그 정보를 어떻게 다루고 검증할 것인가'로 바뀝니다.
  • AI에게 어떤 질문을 던져야 정확한 답이 나오는지 알기
  • AI가 찾아준 논문이나 근거가 믿을 만한지 평가하기
  • AI가 거짓말(환각 현상)을 하지는 않았는지 걸러내기
  • AI의 일반적인 답변을 우리 병원의 상황이나 눈앞의 환자 특성에 맞게 조정하기
4. 결론: 끊임없이 변하는 지식 앞에서의 겸손함 AI는 매일 쏟아지는 전 세계의 새로운 논문과 진료 지침을 실시간으로 업데이트합니다. 의학 지식은 고정되어 있지 않고 매일 변합니다. 따라서 앞으로의 의사는 "내가 아는 지식이 언제든 바뀔 수 있다(인식론적 겸손)"는 유연한 태도를 가져야 합니다.

결과적으로 AI 시대의 진정한 '의료 기본기'란, 지식을 무조건 암기하는 능력이 아니라 AI라는 강력한 도구를 비판적으로 검증하고 환자를 위해 책임감 있게 사용하는 능력으로 진화하고 있다는 것이 이 글의 핵심입니다.


표 2. 역량의 세 층에서 나타나는 인지적 희소성과 인지적 풍요의 비교 (Cognitive Scarcity vs. Cognitive Abundance Across Three Layers of Competence) 

역량의 층 기능 인지적 희소성 인지적 풍요
정전적 역량 위치(Location) 편람과 학술지 출판물. 한계를 지닌 임상의의 마음. AI를 통해 지식에 역동적으로 접근할 수 있다. 장기기억(long-term memory, LTM)에 저장하기보다 탐색, 질의, 검증, 종합을 강조한다.
처리(Processing) 일상 진료에 암기가 필수적이다. 학습은 텍스트 기반 자원에 한정되며, 근거는 대체로 당연한 것으로 받아들여지고, 갱신은 주기적으로 이루어진다. 다중양식 자료(텍스트, 오디오, 비디오, 시뮬레이션), 실시간 근거 종합, 자동화된 개인지도가 이해와 학습을 지원한다.
평가(Evaluation) 평가는 고정된 시험과 정적인 사례에 의존한다. 대규모로 생성되는 적응형 평가, 목표 지향적 보충 교육이 이루어지고, AI가 오개념을 자동으로 식별한다.
맥락적 역량 위치(Location) 숙련된 진료에 필요한 암묵지는 도제식 경험을 통해 천천히 학습된다. 임상 진료(기록, 의사결정, 의사소통, 업무 흐름)에 대한 AI 생성 피드백이 지속적으로 제공되어 숙련도 향상을 앞당긴다.
처리(Processing) 지역적 직관이 진료를 이끌며, 암묵적·명시적 수행 피드백 정보가 제공된다. 전역적·지역적 패턴 인식이 맥락에 민감한 의사결정을 뒷받침한다.
평가(Evaluation) 팀에서의 기능은 비공식적으로 평가된다. 역량위원회(competency committees)에서 데이터가 적은 평가자 간 판단으로 타당성을 뒷받침한다. 기준 미달의 진료는 흔히 신호로 드러나지 않는다. AI 기반 의사소통 및 업무 흐름 분석으로 팀 역동이 가시화된다. 전자 포트폴리오(ePortfolio) 데이터 종합은 총괄적 신뢰 부여(summative entrustment)와 진료 권한 부여(privileging)를 지원한다.
개인화된 역량 위치(Location) 자기 이해는 환자와 협력자와의 상호작용, 간헐적인 멘토링에 의존한다. 어조, 공감, 추론, 습관에 관한 다중양식 통찰을 활용한 AI 지원 성찰 실천이 발달을 촉진한다.
처리(Process) 시행착오를 통한 개인적 성장은 흔히 느리고, 경험에 의존하며, 고르지 않다. 미세행동(microbehavior)에 대한 지속적인 통찰을 얻는다. AI에 근거한 의도적 연습(deliberate practice)은 개인 경험을 넘어설 수 있다. AI는 강점을 바탕으로 개인화된 발달 경로를 제안하고 지원할 수 있다.
평가(Evaluation) 피드백은 거의 없다. 번아웃은 진행 후기에야 발견되고, 개인적 성장이 항상 식별되는 것은 아니다. 환자보고결과지표(patient-reported outcome measures)와 다른 개인화된 지표를 더 잘 포착한다. 분석을 통해 웰빙 문제를 일찍 발견하고 개인화된 회복탄력성 지원을 제공한다.

인지적 풍요 속의 맥락적 역량 (Contextual Competence Under Cognitive Abundance) 

텐 카터 등의 다층적 모델에서 두 번째 층인 맥락적 역량은 임상 환경의 현실적 복잡성 속에서 지식과 기술을 효과적으로 적용하는 임상의의 능력에 관한 것이다.7 여기에는 상황인식(situational awareness), 우선순위 설정, 적응력, 의사소통, 팀워크, 그리고 자원 가용성, 환자 인구집단의 특성, 문화적 규범, 전문직 간 역동 등 특정 환경의 제약 속에서 기능하는 능력이 포함된다. 전통적으로 맥락적 역량은 경험학습(experiential learning)과 암묵적인 문화 습득(tacit enculturation)을 통해 서서히 발달한다. 임상의는 회진에서 문서화되지 않은 규범을 흡수하고, 긴급한 상황에서 어떤 단서가 중요한지 배우며, 관찰과 피드백을 통해 팀의 기대에 적응한다. 이러한 학습은 강력하지만 역사적으로 느리고, 고르지 않으며, 우연한 경험에 크게 좌우되었다.


인공지능은 이전에는 암묵적이었던 업무의 측면을 보이게 함으로써 맥락적 역량을 변화시킨다.


  • 가장 기본적으로, 맥락 인식 의사결정 지원 시스템(context-aware decision support systems)은 지역 진료지침, 항균제 내성 양상, 인력 배치, 자원 제약을 통합한 권고를 제공한다.
  • 예측 분석(predictive analytics)은 활력징후나 검사 결과의 미세한 변화를 통해 인간의 관찰로는 놓칠 수 있는 악화의 초기 징후를 찾아낸다.14
  • 업무 흐름에 통합된 마이크로러닝(microlearning) 도구는 전자의무기록(electronic health record)에서 특정 행동을 계기로 패혈증 묶음 치료(sepsis bundles)나 항응고요법 지침을 상기시키는 등 필요한 내용을 임상의에게 실시간으로 전달할 수 있다.8
  • 이러한 도구는 함께 인지 부담을 줄이고 상황인식을 높여 임상의가 주의를 더 효과적으로 집중할 수 있게 한다.15


AI는 지역 환경에 맞춘 고충실도 시뮬레이션(high-fidelity simulations)을 가능하게 함으로써 맥락적 역량을 더욱 지원한다. 전통적인 시뮬레이션이 일반적인 정전적 사례에 의존했다면, AI 기반 플랫폼은 지역 데이터, 즉 흔한 동반질환, 자주 발생하는 합병증, 전형적인 대응 시간, 자원 제약에 따라 시나리오를 역동적으로 조정할 수 있다. 임상의는 드문 응급상황뿐 아니라 분절된 시스템 전반에서 진료를 조정하거나 어려운 진단적 불확실성을 전달하는 등 일상적 과제의 복잡한 시나리오도 자신의 실제 진료 환경을 닮은 곳에서 연습할 수 있다. 이러한 형태의 연습은 맥락에 민감한 기술의 습득을 앞당긴다.16


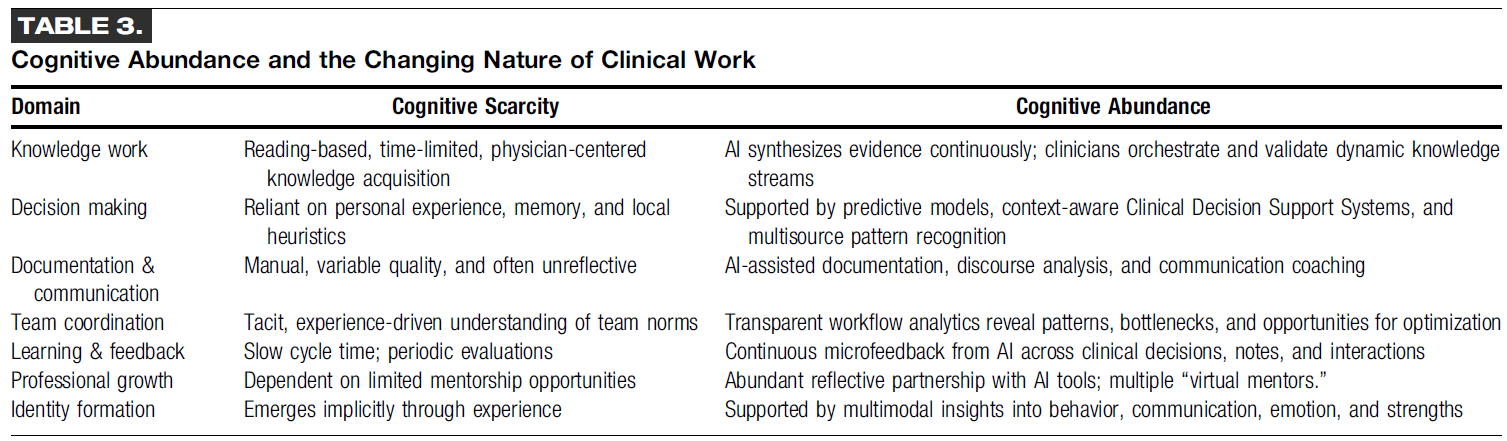
그러나 맥락적 역량의 가장 깊은 변화는 아마도 인지적 희소성에서 인지적 풍요로의 전환에서 나온다. 표 3은 인지적 풍요의 환경에서 임상 업무가 어떻게 달라질 수 있는지 설명한다.


표 3. 인지적 풍요와 변화하는 임상 업무의 성격 (Cognitive Abundance and the Changing Nature of Clinical Work) 

영역 인지적 희소성 인지적 풍요
지식 업무(Knowledge work) 독서에 기반하고, 시간 제약을 받으며, 의사 중심으로 지식을 습득한다. AI가 근거를 지속적으로 종합한다. 임상의는 역동적인 지식 흐름을 조정하고 검증한다.
의사결정(Decision making) 개인의 경험, 기억, 지역적 경험칙(heuristics)에 의존한다. 예측 모델, 맥락 인식 임상의사결정지원시스템(clinical decision support systems), 여러 출처의 패턴 인식이 지원한다.
문서화와 의사소통(Documentation & communication) 수작업으로 이루어지고 질이 일정하지 않으며, 성찰이 부족한 경우가 많다. AI 지원 문서화, 담화 분석(discourse analysis), 의사소통 코칭이 이루어진다.
팀 조정(Team coordination) 팀 규범을 암묵적이고 경험에 의존하여 이해한다. 투명한 업무 흐름 분석으로 패턴, 병목, 최적화의 기회가 드러난다.
학습과 피드백(Learning & feedback) 순환 주기가 길고 평가는 주기적으로 이루어진다. 임상 의사결정, 기록, 상호작용 전반에 대해 AI가 지속적으로 미세 피드백(microfeedback)을 제공한다.
전문직 성장(Professional growth) 제한된 멘토링 기회에 의존한다. AI 도구와의 풍부한 성찰적 협력, 다수의 ‘가상 멘토’가 가능하다.
정체성 형성(Identity formation) 경험을 통해 암묵적으로 나타난다. 행동, 의사소통, 감정, 강점에 대한 다중양식 통찰이 지원한다.


풍요로운 환경에서 맥락적 역량은 더 이상 임상의가 우연히 관찰한 것이나 소수의 지도자로부터 받은 피드백에 의해 제한되지 않는다. 대신 임상의는 현실의 자신의 행동에 대해 지속적이고 데이터에 근거한 통찰을 얻을 수 있다.

  • 진료기록 분석(documentation analytics)은 추론 패턴을 드러내고17, 의사소통 분석은 말 끊기, 주저함, 전문용어 사용을 파악하며, 팀 매핑 알고리즘(team-mapping algorithms)은 토론에 누가 참여하고 누가 체계적으로 배제되는지를 부각한다.
  • 또 하나의 중대한 변화는 인간–AI 혼합 팀(hybrid human–AI team)의 역동이 등장한다는 점이다. AI 시스템이 경고, 권고, 예측을 만들어냄에 따라 임상의는 이를 협업의 업무 흐름에 통합해야 한다. 이를 위해 누가 어떤 경고를 감시할지 결정하고, 임상의의 판단과 모델 출력이 다를 때 해결 방법을 명확히 하며, 팀 안에서 주의가 공평하게 배분되도록 하는 새로운 조정 방식이 필요하다. 이제 좋은 팀원이 되려면 AI가 매개하거나 영향을 미치는 조정에 능숙해야 한다.
  • 마지막으로, AI가 팀 상호작용의 패턴, 업무 흐름의 병목, 시스템의 비효율을 드러내면 맥락적 역량은 더 투명해지고 개선 가능해진다. 진료 지연이 빈번하다는 것을 알아차린 임상의는 AI가 만든 업무 흐름 지도를 활용해 근본 원인을 찾을 수 있고, 의사소통의 단절을 감지하는 모델은 목표 지향적 팀 훈련을 안내할 수 있다. 이러한 가시성은 맥락적 역량을 암묵적·경험적 성격에서 명시적이고 데이터 성찰적(data-reflexive)인 성격으로 바꾼다. 이전에는 볼 수 없던 것을 볼 수 있게 되어 개선 대상으로 삼을 수 있는 것이다.
1. 과거의 실전 능력: 어깨너머로 배우는 '실전 감각과 눈치' 병원 현장은 교과서와 다릅니다. 환자의 특성, 병원의 부족한 자원, 의료진 간의 서열이나 분위기 등 복잡한 상황이 얽혀 있습니다. 과거에는 이런 환경에서 살아남고 적응하는 능력(상황 파악, 우선순위 설정, 의사소통 등)을 선배들을 따라다니며 회진 중에 눈치껏 배우거나, 깨지면서 우연히 경험을 통해 서서히 익혀야만 했습니다.

2. AI가 가져온 변화 ①: 우리 병원에 딱 맞는 '실시간 내비게이션'
AI는 겉으로 드러나지 않던 병원의 숨은 상황과 규칙들을 눈에 보이게 짚어줍니다.

  • 실시간 조언: "이 지역은 특정 항생제 내성이 강하니 다른 약을 쓰세요"처럼 현재 병원 상황에 맞는 지침을 알려줍니다.
  • 조기 경보: 의사의 눈으로는 놓치기 쉬운 환자의 미세한 변화를 미리 감지해 경고해 줍니다.
  • 맞춤형 실습: 교과서적인 뻔한 상황이 아니라, '우리 병원에서 가장 흔하게 발생하는 위급 상황'이나 '우리 병원의 부족한 장비 상황'을 반영한 맞춤형 모의훈련(시뮬레이션)을 만들어내어 실전 적응을 돕습니다.
3. 데이터 기반의 거울: 내 진료와 소통 습관까지 분석하는 AI 정보가 풍요로워진 시대에는 의사의 '소프트 스킬(의사소통, 팀워크 등)'도 더 이상 우연한 선배의 조언에 의존하지 않습니다. AI가 의사의 실제 행동 데이터를 분석해 객관적인 피드백을 줍니다.
  • 환자와 대화할 때 내가 말을 얼마나 끊었는지, 어려운 의학 용어를 너무 많이 쓰지는 않았는지 분석해 줍니다.
  • 의료진 회의에서 특정 팀원(예: 신규 간호사)이 의견을 내지 못하고 소외되고 있지는 않은지 팀워크 패턴까지 짚어냅니다.
4. 새로운 시대의 실전 능력: "AI를 동료로 받아들이고 시스템을 고치는 것" 결과적으로 가장 큰 변화는 '팀워크의 대상'이 사람에서 AI로까지 확장된다는 것입니다. 이제 훌륭한 의사란 단순히 동료들과 잘 지내는 것을 넘어, '인간-AI 혼합 팀'에서 잘 일하는 사람입니다.
  • AI가 쏟아내는 수많은 경고 알림 중 누가 어떤 것을 확인할지 역할을 나누고, 내 판단과 AI의 의견이 다를 때 이를 어떻게 조율할지 결정해야 합니다.
  • 나아가 AI가 분석해 준 병원의 업무 지연 원인이나 소통의 문제를 바탕으로, 병원 시스템 자체를 투명하게 들여다보고 개선할 수 있어야 합니다.
요약하자면, 과거에는 실전 능력이 "선배들의 등 너머로 감(눈치)을 잡는 것"이었다면, AI 시대의 실전 능력은 "데이터와 AI의 피드백을 활용해 나 자신의 소통 방식을 객관적으로 돌아보고, AI라는 새로운 동료와 함께 병원 시스템 전체를 효율적으로 조율해 내는 능력"으로 업그레이드된다는 뜻입니다.


인지적 풍요 속의 개인화된 역량 (Personalized Competence Under Cognitive Abundance) 

텐 카터 등의 다층적 모델에서 세 번째 층인 개인화된 역량은 개별 임상의의 가치, 개인적·대인관계적 업무 방식, 성찰 능력, 웰빙, 정서적 안정성, 전문직 정체성을 가리킨다.3 여기에는 환자, 동료, 자기 자신과 관계를 맺을 때 드러나는 임상의의 개인적 스타일이 포함되며, 공감, 정직성, 회복탄력성, 진료를 이끄는 도덕적 헌신도 포함된다. 정전적 역량이나 맥락적 역량과 달리 개인화된 역량은 전통적으로 측정하거나 가르치거나 체계적으로 함양하기가 가장 어려웠다. 이는 개인적 경험, 멘토링, 문화, 도덕적 또는 정서적 도전에 직면한 순간에 영향을 받으며 천천히 나타난다. 무엇보다도 전문직 종사자들 사이의 정당한 차이와 표준화된 평가로는 포착하기 어려운 고유성을 함축한다. 그러나 변하지 않는 점은 임상의가 정전적·맥락적 기준을 넘어 개인적 신념과 스타일을 발전시킴으로써 전문직 수행을 발달시키고 개선한다는 것이다.


AI는 어떻게 좋은 의사가 훌륭한 의사로 성장하도록 도울 수 있을까?

  • AI는 대인관계 행동과 성찰적 삶의 여러 측면을 보이게 하고, 분석하고, 개선할 수 있게 하여 개인화된 역량에 새로운 발달의 지형을 연다. 의사소통 분석 도구는 임상적 만남에서 어조, 명료성, 말 끊기의 양상, 공감적 언어 사용을 살필 수 있다. 자연어 처리(natural language processing)는 임상의가 불확실성을 효과적으로 전달하는 순간, 또는 설명이 환자를 혼란스럽게 하거나 압도할 위험이 있는 순간을 찾아낼 수 있다. 이러한 통찰은 대인관계 스타일을 암묵적 특성에서 코칭 가능한 미세행동(coachable microbehaviors)의 집합으로 바꾼다.18
  • AI는 개인의 성찰 실천(reflective practice)도 강화한다. 임상의는 정서적으로 복잡한 만남을 풀어 이해하도록 돕는 AI 기반 일지 시스템(journaling systems), 서사의학 보조 도구(narrative medicine assistants), 성찰적 동반자(reflective companions)를 이용할 수 있다. 이러한 에이전트는 숙련된 인간 멘토가 던질 법한 탐색적 질문을 흉내 내며 “어떤 가정이 당신의 반응에 영향을 주었는가?” 또는 “문화적 배경이 이 상호작용을 어떻게 형성했을까?”와 같이 더 깊은 성찰을 촉구할 수 있다. 이 도구들은 시간 제약 없이 지속적으로 작동하므로 인간 코치가 현실적으로 제공할 수 있는 수준을 넘어 성찰 지원에 대한 접근을 넓힌다.
  • 웰빙 분석(wellbeing analytics)은 번아웃, 피로, 인지 과부하와 관련된 패턴을 식별하여 개인화된 역량을 더 지원한다. AI 시스템은 수면의 대리지표(sleep proxies), 기록 작성 시점, 받은 편지함의 업무량, 읽지 않은 검사 결과의 누적량이 변하는지를 추론하여 임상의에게 부담의 초기 징후를 알릴 수 있다. 이를 통해 선제적인 자기돌봄(proactive self-care)이 가능해지고, 개인화된 역량의 중요한 요소인 회복탄력성을 키울 수 있다.

인지적 풍요는 개인화된 역량을 더 깊은 수준에서 변화시킨다.

  • 임상의가 자신의 의사소통, 감정적 어조, 추론 패턴, 웰빙에 대한 다중양식 통찰에 지속적으로 접근할 수 있다면 정체성 형성이 빨라질 수 있다. 임상의는 새로운 관점에서 자신을 바라보며, 어려운 대화에서 주저하거나 팀 회의에서 의도치 않게 발언을 독점하는 등 수년간 알아차리지 못했을 수 있는 경향을 발견할 수 있다. 따라서 AI는 성찰의 자료를 꾸준히 제공함으로써 정체성 발달을 풍부하게 한다. 반면 과도한 감시(over-surveillance)와 해로운 문화 변화 같은 잠재적 위험도 있다.
  • 인간–AI 혼합 멘토링(hybrid human–AI mentorship) 또한 전문직 성장을 재편한다.19 실제 삶에서 얻은 지혜와 도덕적 지침을 제공하는 인간 멘토는 AI로 대체할 수 없다. 그러나 AI는 24시간 피드백을 제공하고, 장기간의 수행 데이터를 종합하며, 인간 관찰자가 놓칠 수 있는 강점과 기회를 임상의가 발견하도록 도와 멘토링을 보강할 수 있다. 이로써 멘토링이 희소하기보다 풍부한 학습 환경이 만들어진다.

하지만 인지적 풍요는 윤리적 복잡성도 가져온다. 개인에 관한 분석이 매우 상세해질수록 임상의는 지나친 자기비판, 알고리즘적 인정에 대한 과도한 의존, 사생활 침해 위험에 빠지지 않으면서 그것을 통합하는 법을 배워야 한다. AI가 매개하는 세계의 개인화된 역량에는 개인 데이터와 맺는 관계를 관리하고, 분별력을 갖고 피드백을 해석하며, 알고리즘의 통찰 속에서도 자율성과 인간성을 유지하는 메타기술(meta-skills)이 필요하다.20


궁극적으로 인지적 풍요 속의 개인화된 역량은 데이터의 지원을 받으며 자기 자신을 계속 이해하고 성장시키는 역동적인 과정이 된다. 임상의는 경험뿐 아니라 자신이 어떻게 생각하고 느끼고 의사소통하며 협력하는지를 비추어 주는 다중양식 피드백 고리(multimodal feedback loops)를 통해 발전한다. AI가 생성한 피드백은 인간 피드백에서 개인적 관계 때문에 생길 수 있는 왜곡을 줄이고 비공개로 유지할 수도 있지만, 매우 중요한 윤리적 질문 하나가 남는다. 이렇게 극도로 개인화된 데이터에는 누가 접근할 수 있는가? 


1. 과거의 개인 역량: 시간과 경험만이 답이었던 '의사로서의 인성' 의사의 공감 능력, 도덕성, 회복탄력성(멘탈 관리), 자신만의 진료 스타일 등은 교과서나 시험으로 배울 수 없는 영역입니다. 과거에는 수많은 환자를 만나고 훌륭한 선배 의사를 롤모델 삼아 오랜 시간 경험을 쌓아야만 서서히 길러지는, 지극히 주관적이고 추상적인 능력이었습니다.

2. AI가 가져온 변화 ①: 추상적인 '공감'을 눈에 보이는 데이터로 코칭
AI는 눈에 보이지 않던 의사의 '태도'를 구체적인 데이터로 분석해 줍니다.

  • 환자와 대화할 때 목소리 톤은 어땠는지, 공감하는 단어를 얼마나 썼는지, 환자가 혼란스러워할 만한 어려운 말을 쓰지 않았는지 AI가 분석합니다.
  • 이를 통해 막연했던 '친절함'이나 '소통 능력'이 구체적으로 교정 가능한 행동(미세 행동)으로 바뀌어, 누구나 자신의 소통 방식을 코칭받을 수 있게 됩니다.
3. AI가 가져온 변화 ②: 24시간 나를 돌아보게 하는 '가상 멘토와 번아웃 알리미' AI는 훌륭한 선배이자 심리 상담가의 역할도 일부 대신합니다.
  • 자기 성찰 돕기: 정서적으로 힘든 환자를 겪은 후, AI가 "방금 그 상황에서 왜 그런 감정을 느꼈나요?", "당신의 어떤 고정관념이 작용했을까요?"라고 질문을 던져 의사 스스로 마음을 돌아보게 도와줍니다.
  • 번아웃(탈진) 예방: 의사의 차트 작성 시간, 쌓여있는 업무량, 수면 패턴 등을 분석해 "지금 인지적 과부하가 왔으니 선제적 휴식이 필요하다"고 미리 경고해 줍니다.
4. 새로운 시대의 개인 역량: 데이터의 거울 앞에서도 주체성을 잃지 않는 단단함 AI의 객관적인 피드백 덕분에 의사는 자신의 단점(예: 어려운 대화를 회피하는 습관 등)을 빠르게 깨닫고 더 나은 의사로 훌륭하게 성장할 수 있습니다. 하지만 여기에는 치명적인 고민거리도 따릅니다.
  • AI의 평가에 너무 집착해 지나치게 자책하거나, 누군가에게 감시당하고 있다는 느낌(과도한 감시)을 받을 수 있습니다.
  • 또한, 나의 지극히 사적인 심리 상태와 업무 태도 데이터에 "과연 누가 접근할 수 있는가?"라는 거대한 윤리적/프라이버시 문제가 남습니다.
결론적으로, AI 시대에 의사 개인에게 요구되는 진정한 자질은 "인간 선배의 삶의 지혜와 AI의 24시간 객관적 피드백을 조화롭게 활용하면서도, 알고리즘의 평가에 휘둘리지 않고 의사로서의 자율성과 따뜻한 인간성을 지켜내는 것"입니다.

계속전문직업개발에 대한 함의 (Implications for Continuing Professional Development) 

역량의 세 층을 모두 가로지르는 인지적 풍요로의 전환은 CPD에 중대한 함의를 갖는다. CPD는 본래 임상의가 정보 접근의 제한, 느린 피드백 주기, 의도적 연습의 드문 기회 같은 심각한 인지적 제약을 겪던 시대를 위해 설계되었다. 이제 CPD는 주기적 최신 정보 제공, 정적인 교육과정, 간헐적 평가를 중심으로 구조화되어서는 안 된다. 그 대신 임상의가 역동적인 지식 생태계를 탐색하고, 다중양식 피드백을 해석하며, 진료의 모든 층에 걸쳐 인간–AI 혼합 역량(hybrid human–AI competence)을 함양하도록 지원해야 한다.

  • 첫째, CPD는 AI 문해력(AI literacy)을 기초적인 전문직 기술로 우선시해야 한다.12,20 임상의는 대규모 언어 모델, 예측 알고리즘, 다중양식 시스템이 어떻게 작동하는지, 그리고 각각의 한계, 불확실성, 실패 양상(failure modes)을 이해해야 한다. 여기에는 모델에 효과적으로 질문하고, AI가 생성한 근거를 검증하고, 환각을 알아차리고, 모델의 설명을 해석하는 능력이 포함된다. AI 문해력은 AI의 권고를 임상추론과 팀의 업무 흐름에 언제, 어떻게 통합할지 이해하는 것도 포함한다.
  • 둘째, CPD 프로그램은 임상의가 혼합 의사결정(hybrid decision making)을 수행하도록 준비시켜야 한다. AI로 증강된 시스템에서 의사결정은 임상의의 인지만으로 이루어지는 것이 아니라 인간의 판단, 환자의 가치, 조직의 제약, 모델이 생성한 통찰이 상호작용한 결과로 나온다. CPD는 의견 불일치의 조정(disagreement negotiation), 즉 AI가 자신의 판단에 반대할 때 임상의가 어떻게 대응하는지, 문제 상향 보고 경로(escalation pathways), 공유 디지털 도구를 활용한 협력적 의미 구성(collaborative sense-making)과 같은 메타역량(meta-competencies)의 발달을 지원해야 한다.
  • 셋째, CPD는 AI 사용을 둘러싼 전문직 간 일관성(interprofessional coherence)을 강화해야 한다. AI 시스템이 위험 점수, 예측, 기록 제안과 같은 공유 신호를 생성하므로 팀은 이러한 입력을 일관되게 통합하는 방법을 배워야 한다. CPD는 간호사, 의사, 약사, 기타 보건의료인 사이에서 AI 도구에 관한 공유된 정신모형(shared mental models)을 촉진하여 AI 지원 업무 흐름이 팀의 기능을 분절시키지 않고 향상시키도록 해야 한다.
  • 넷째, CPD는 개인 분석 자료(personal analytics)를 성찰적이고 윤리적으로 다루도록 지원해야 한다. 임상의는 자신의 의사소통 패턴, 감정적 어조, 추론 구조, 웰빙에 대한 상세한 통찰을 점점 더 자주 접하게 될 것이다. 인지적 풍요는 피드백의 풍요이기도 하다. CPD는 임상의가 이 정보를 건설적으로 해석하고, 알고리즘의 판단에 과도하게 의존하지 않으며, 자율성과 도덕적 행위주체성(moral agency)을 유지하도록 도와야 한다. 구조화된 성찰 실천, 동료 간 토론, 교수진의 멘토링은 계속해서 중요할 것이다.
  • 마지막으로 CPD 시스템 자체도 인지적 풍요의 조건에서 작동하도록 다시 설계되어야 한다. 교육과정은 역동적이어야 하고, 평가는 지속적이어야 하며, 피드백은 실시간으로 제공되고, 학습 경로는 개인화되어야 한다. AI는 이러한 변화를 가능하게 한다. CPD는 그 변화가 일관되고 안전하며 교육적으로 타당하게 이루어지도록 해야 한다.

이 논문의 심사자 중 한 사람이 지적했듯, 임상 행위에 대한 보건의료인의 최종 책임을 유념해야 한다. 실제로 AI가 임상적 판단에 점점 더 많이 관여할수록 임상의의 도덕적 행위주체성을 강화하는 CPD의 역할은 더욱 중요해진다. 표 4는 CPD의 기능이 희소성에 기반한 패러다임에서 인지적 풍요를 특징으로 하는 패러다임으로 어떻게 발전하는지 요약한다.


표 4. 인지적 풍요 속에서 CPD 시스템의 변화 (Transformation of CPD Systems Under Cognitive Abundance) 

교육 기능 인지적 희소성 인지적 풍요 CPD에서 AI 사용 시 유의점
교육과정(Curriculum) 고정된 내용, 느린 개정 주기, 표준화된 전달. AI가 매개한 근거 흐름과 통합되며 지속적으로 갱신되는 역동적인 학습 자료. 잘못된 정보나 저품질 종합물(‘AI 찌꺼기’, AI dross)이 교육과정에 유입될 위험. 합의된 전문직 기준의 약화.
평가(Assessment) 간헐적 시험, 제한된 시뮬레이션, 수행의 좁은 범위만 표집. AI 기반 시뮬레이션, 적응형 검사, 실제 수행 분석을 통한 지속적 평가. 대리지표(proxy metrics)에 대한 과도한 의존, AI 채점 모델의 불투명성, 측정된 수행과 전문직 가치 사이의 불일치.
피드백(Feedback) 지도자의 피드백이 간헐적이며 직접 관찰에 의존. 추론, 기록, 의사소통, 팀워크에 관한 실시간 AI 기반의 비판단적 피드백. 과도한 감시, 인지 과부하, 자동화된 피드백이 성찰적 판단이나 인간의 코칭을 밀어낼 위험.
학습자 지원(Learner Support) 멘토링에 대한 접근의 편차가 큼. 규모를 확장할 수 있는 AI 코칭 에이전트, 성찰적 동반자, 멘토 연결. 인간 멘토링의 보강이 아닌 대체, 비인격적 지침 또는 규범의 표류(normative drift).
직장 기반 학습(Workplace learning) 학습이 간헐적으로 포착되고 맥락은 체계적으로 분석되는 일이 드묾. AI가 업무 흐름, 결과, 팀 역동의 패턴을 드러내 실천 중 성찰(reflection-in-action)을 지원. 감시에 대한 우려, 학습 문화의 위축 효과(chilling effects), 성과 관리에 분석 자료가 오용될 위험.
전문직 정체성 발달(Professional identity development) 멘토링과 서사적 경험을 통해 천천히 나타남. 다중양식 AI 통찰이 가치와 의사소통을 중심으로 하는 정체성 형성을 가속. 전문직 정체성의 분절 또는 평면화, 모델이 높게 평가하는 행동을 향한 과도한 최적화와 지나친 가속.
발달의 주기(Cadence of development) 발달상의 도약 사이에 수년이 걸림. 빠르고 지속적인 통찰로 잦은 발달상의 향상이 가능. 공고화(consolidation) 없는 가속, 윤리적 성찰과 의미 구성에 필요한 시간의 부족.

결론 (Conclusion)

인공지능은 보건의료인이 직업 생애 전반에 걸쳐 학습하고 추론하고 협력하며 발달하는 방식에 중대한 변화를 가져온다. AI는 인지 환경을 희소성에서 풍요로 재구성하여 텐 카터의 다층적 틀에서 역량의 모든 층을 재편한다.

  • 정전적 역량은 생의학 지식을 머릿속에 보유하는 능력보다 AI가 매개한 근거를 탐색하고, 질문하고, 검증하는 능력에 더 가까워진다.
  • 맥락적 역량은 암묵적이고 경험에 기반한 상황인식에서 예측적 통찰, 업무 흐름 분석, 인간–AI 혼합 협력으로 풍부해진 데이터 성찰적 실천(data-reflexive practice)으로 발전한다.
  • 아마도 가장 불편하게 느껴질 변화는 한때 가장 불투명하고 측정하기 어려웠던 개인화된 역량이 의사소통, 추론, 감정, 웰빙에 대한 다중양식 데이터와 피드백을 통해 새롭게 접근 가능해진다는 점이다. 이는 에이브러햄 매슬로(Abraham Maslow)가 말한 것처럼 ‘미지의 것에 비교적 두려움을 느끼지 않는(relatively unfrightened by the unknown)’ 성숙하고 균형 잡힌 적응적인 임상의로 개인이 성장하는 데 도움이 될 수 있다.21

궁극적으로 AI 시대의 역량은 임상의가 무엇을 알고 있거나 개별 과제를 어떻게 수행하는가만의 함수가 아니다. 이는 분산된 인지 시스템(distributed cognitive systems) 안에서 현명하게 일하는 능력이다. 풍부한 정보와 인간의 통찰 사이에 균형을 맞추고, 알고리즘적 예측과 맥락의 미묘한 차이를 통합하며, 다중양식 데이터의 지원을 받아 지속적으로 성찰하는 능력이다.


전문직 역량의 미래는 이러한 종합에 있다. AI에 가려지는 것이 아니라 AI를 통해 더 강해지고, 알고리즘에 의존하기보다 알고리즘과의 사려 깊은 협력을 통해 역량을 발휘하는 임상의이다. 의도적인 설계를 통해 CPD는 임상의가 이러한 미래로 나아가도록 안내하고, 인지적 풍요가 수행 능력뿐 아니라 돌봄의 핵심에 있는 인간성도 높이도록 할 수 있다.

진료 실천을 위한 교훈 (Lessons for Practice) 

  • CPD 프로그램은 정전적 역량(기초 지식과 기술적 술기)의 초점을 생의학적 사실의 기억에서 효과적인 질문의 구성, AI가 생성한 근거의 검토, 임상 의사결정에 사용되는 정보의 타당성 평가로 다시 조정해야 한다.
  • CPD 활동은 임상의가 AI 도구를 인간–AI 혼합 팀워크, 적응형 업무 흐름, 전문직 간 조정에 통합할 수 있도록 준비시켜 맥락적 역량(실제 임상 환경에서의 지식 적용)을 강화해야 한다.
  • CPD는 의사소통, 추론, 웰빙에 관한 AI 기반 피드백을 활용하여 개인의 정체성 분화(personal identity differentiation)를 대체하기보다 보강함으로써 개인화된 역량(전문직 정체성, 가치, 성찰 능력)의 발달을 지원해야 한다.


Acad Med. 2025 Sep 1;100(9S Suppl 1):S4-S14. doi: 10.1097/ACM.0000000000006099. Epub 2025 May 26.

Josiah Macy Jr. Foundation Conference on Artificial Intelligence in Medical Education: Proceedings and Recommendations 


🤖 AI 시대, 의학교육은 무엇을 바꿔야 할까? Josiah Macy Jr. 재단 AI 컨퍼런스 권고안 읽기

📄 Josiah Macy Jr. Foundation. Josiah Macy Jr. Foundation Conference on Artificial Intelligence in Medical Education: Proceedings and Recommendations. Academic Medicine. 2025;100(9S):S4–S14. doi:10.1097/ACM.0000000000006099


안녕하세요! 오늘은 Josiah Macy Jr. 재단이 연 AI 컨퍼런스의 결과 보고서를 소개할게요. Macy 재단은 보건의료인 교육만 전문으로 지원하는 미국 재단이에요. 그동안 다직종 교육(IPE), 역량바탕 시간가변 교육(CBTV), 평가의 공정성 같은 주제로 컨퍼런스를 열고, 그때마다 권고안을 내서 의학교육계의 방향을 제시해 왔어요.


이번 주제는 의학교육에서의 인공지능(AI in Medical Education) 이에요. 2024년 11월 18~21일 미국 애틀랜타에서 AI와 의학교육 전문가 41명이 모였고, UCSF 내과 과장인 Robert Wachter가 기획위원장을 맡았어요. 결과물은 5개 권고(recommendations)와 22개 실행 단계(action steps) 예요.


한 줄로 줄이면 이래요. "AI는 이미 병 밖으로 나온 요정(genie)이다. 이제 의학교육은 이걸 안전하고, 형평하게, 효과적으로 쓰는 방법을 체계적으로 준비해야 한다."


📌 1. 왜 지금 이 컨퍼런스였나?

의료계는 사실 오래전부터 AI를 써 왔어요. 대부분 데이터 패턴으로 결과를 예측하는 예측 AI(predictive AI) 였죠. 그런데 2022년 11월 ChatGPT가 나오면서 판이 바뀌었어요. 사람처럼 콘텐츠를 만들어 내는 생성형 AI(generative AI) 가 전기, 컴퓨터, 인터넷처럼 범용기술(general purpose technology) 로 불리기 시작했거든요.


보고서가 인용한 하버드의대 교육 부학장 Bernard Chang의 말이 분위기를 잘 보여 줘요.

몇 년 안에 생성형 AI는 모든 것에 내장될 것이다.
"Within a few years, generative AI is going to be built into everything."


보고서는 이게 교육에 어떤 의미인지도 짚어요. 미국 의사와 간호사는 일주일에 거의 28시간을 서류 작업에 쓴다고 해요. 반복적인 서류 작업이나 단순 암기를 AI에 넘기면, 교수와 학습자 모두 인간만이 할 수 있는 활동에 시간을 더 쓸 수 있다는 거예요.

이론적으로, 반복적인 서류 작업이나 단순 암기 같은 특정 과제를 덜어내면 교수와 학습자 모두 의학에서 고유하게 인간적인 활동을 수행하고 배우는 데 더 많은 시간과 에너지를 쏟을 수 있다.
"In theory, offloading certain tasks, such as routine paperwork and rote memorization, could allow faculty and learners alike to devote more time and energy to performing—and learning—uniquely human activities in medicine."


여기서 말하는 "인간적인 활동"에는 비판적 사고, 적응적 학습, AI가 내놓은 감별진단이나 치료 옵션을 해석하고 검증하는 일, 신체진찰, 환자·가족과의 소통, 신뢰 관계 형성이 들어가요.


⚖️ 2. 기회와 위험, 둘 다 크다

🌱 기회: CBME와 정밀교육을 드디어 굴러가게 할 수도


  • 제가 가장 흥미롭게 본 부분이에요. 보고서는 AI가 역량바탕의학교육(CBME), 다직종 교육(IPE), 정밀교육(precision education) 을 앞당길 수 있다고 봐요. 이 모델들은 좋은 취지에도 불구하고 데이터와 분석 수단이 부족해서 제대로 구현하기 어려웠거든요.
  • 2021년 미국 국립의학아카데미(NAM) 보고서도 CBME가 "학습자별로 풍부한 프로그램식 평가 데이터(rich programmatic assessment data about each learner)"에 의존하다 보니, 그 데이터를 "관리하고, 시각화하고, 해석하는(managing, visualizing, and interpreting)" 일이 큰 과제라고 지적했어요. AI가 바로 이 부분을 도울 수 있다는 거죠. 실제로 자연어처리(NLP)로 서술형 피드백의 질을 평가하는 연구도 나오고 있고요.
  • 정밀교육의 정의도 옮겨 둘게요.


정밀교육은 "데이터와 기술을 활용해 개인, 프로그램, 조직 수준에서 개인화, 효율성, 주체성을 높임으로써 평생학습을 변화시킨다."
precision education "uses data and technology to transform lifelong learning by improving personalization, efficiency, and agency at the individual, program, and organization levels."


  • 실제 사례로 NYU의 DxMentor가 소개돼요. 병원 전자의무기록(EHR)과 교육자료 목록을 연결해서, 학습자가 최근 입원시킨 환자와 관련된 자료를 AI가 사람 개입 없이 골라 제공하는 적시(just-in-time) 도구예요.


⚠️ 위험: "수동적 실행자"가 될 수도

반대편의 우려도 꽤 무겁게 다뤄요. 저는 이 문장이 핵심이라고 봐요.

요구되는 기초의학지식의 범위와 깊이에 대한 명확하고 근거에 기반한 이해가 없다면, 미래의 의사는 AI로 증강된 환자진료의 능동적 관리자가 아니라 알고리즘 의사결정의 수동적 실행자가 될 수 있다.
"Without a clear and evidence-informed understanding of the scope and depth of foundational medical knowledge required of them, for example, future physicians may become passive implementers of algorithmic decision-making rather than active stewards of AI-augmented patient care."


2023년 NEJM 논평은 AI를 "판도라의 상자(Pandora's box)" 라고까지 불렀어요. 의학이 오랫동안 지켜 온 인지적 도제(cognitive apprenticeship), 노력을 들인 공부(effortful study), 의도적 연습(deliberate practice), 윤리적 규범을 흔들 수 있다는 이유였죠.

교육자들이 걱정하는 점은 이렇게 정리돼요.

  • 📝 학문적 진실성(academic integrity): 부정행위, 표절
  • 🎯 정확성과 신뢰성: 편향 재생산, 환각(hallucination)
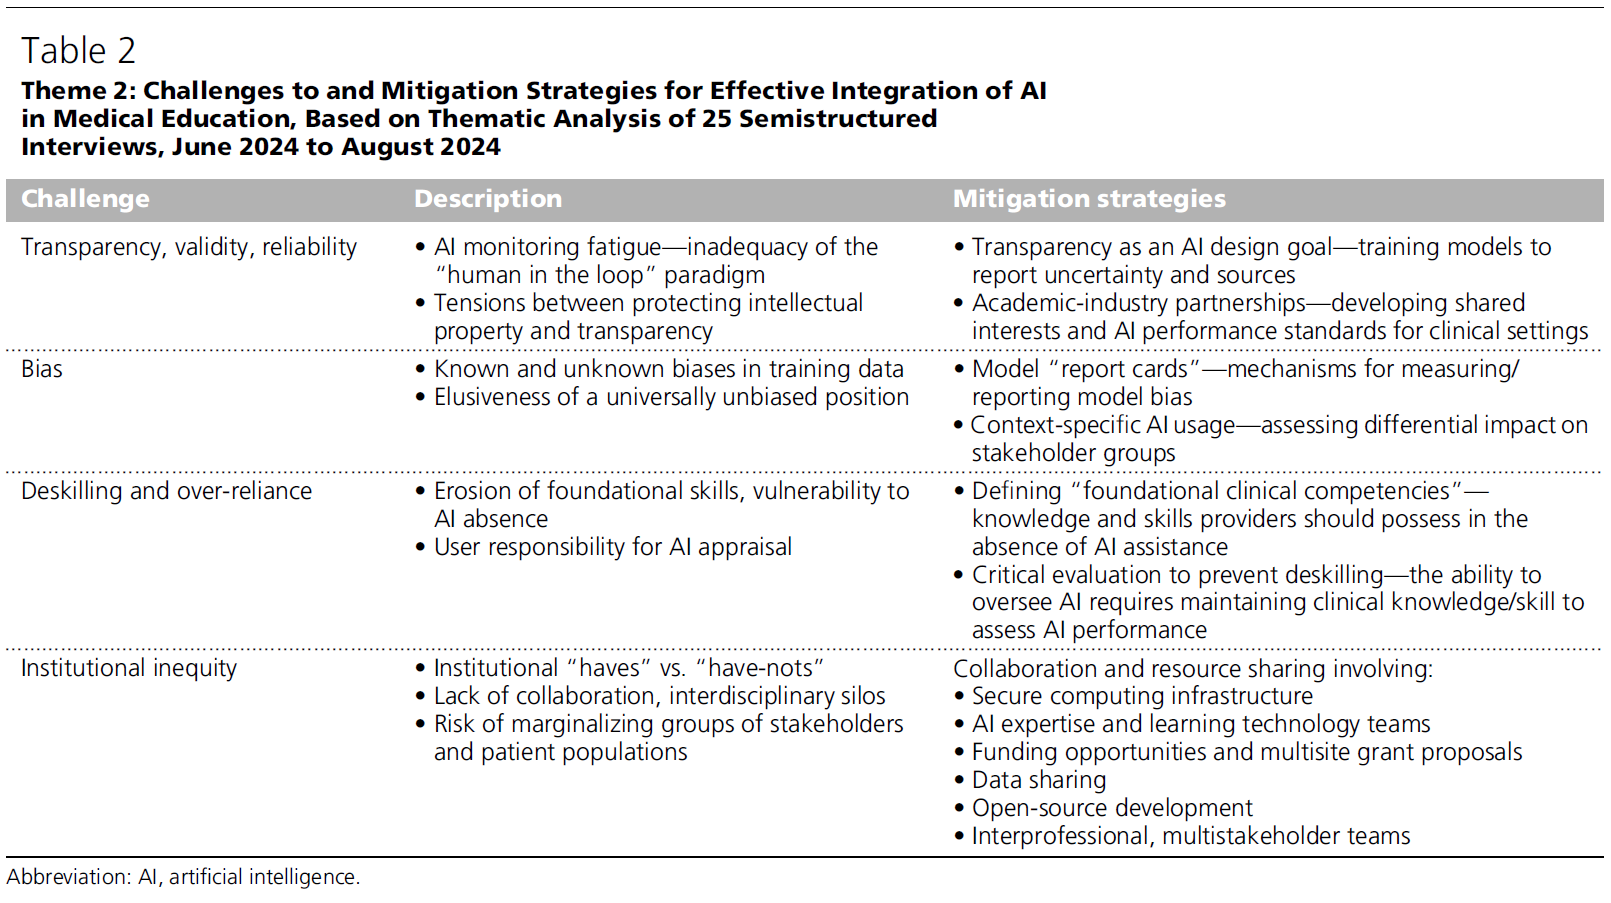
  • 🏫 학습환경 훼손: 학습자의 과의존(overdependency), 자원 불평등 심화
  • 🔒 데이터 프라이버시와 보안: 환자(HIPAA)와 학습자(FERPA) 정보 보호

🗣️ 3. 컨퍼런스에서 나온 목소리들

🏥 병원 CEO의 시각

첫날은 사우스캐롤라이나 의대(MUSC) 병원 CEO인 Patrick Cawley의 대담으로 시작했어요. 그는 AI를 비용 절감과 의료 접근성 개선의 수단으로 보고 있었고, 의사의 업무시간 외 기록 작업을 줄여 번아웃을 완화하는 데 관심이 있다고 했어요. 교육과 관련해서는 이런 말을 남겼어요.

모두가 AI에게 질문하는 법을 배워야 한다. 매번 다른 답을 줄 수 있으니까. 거의 기술(art)에 가깝다.
"Everyone needs to learn how to query AI, because it could give you a different answer every time. There's almost an art to it."

📚 Macy 위탁 연구: AI 활용 현황 보고서

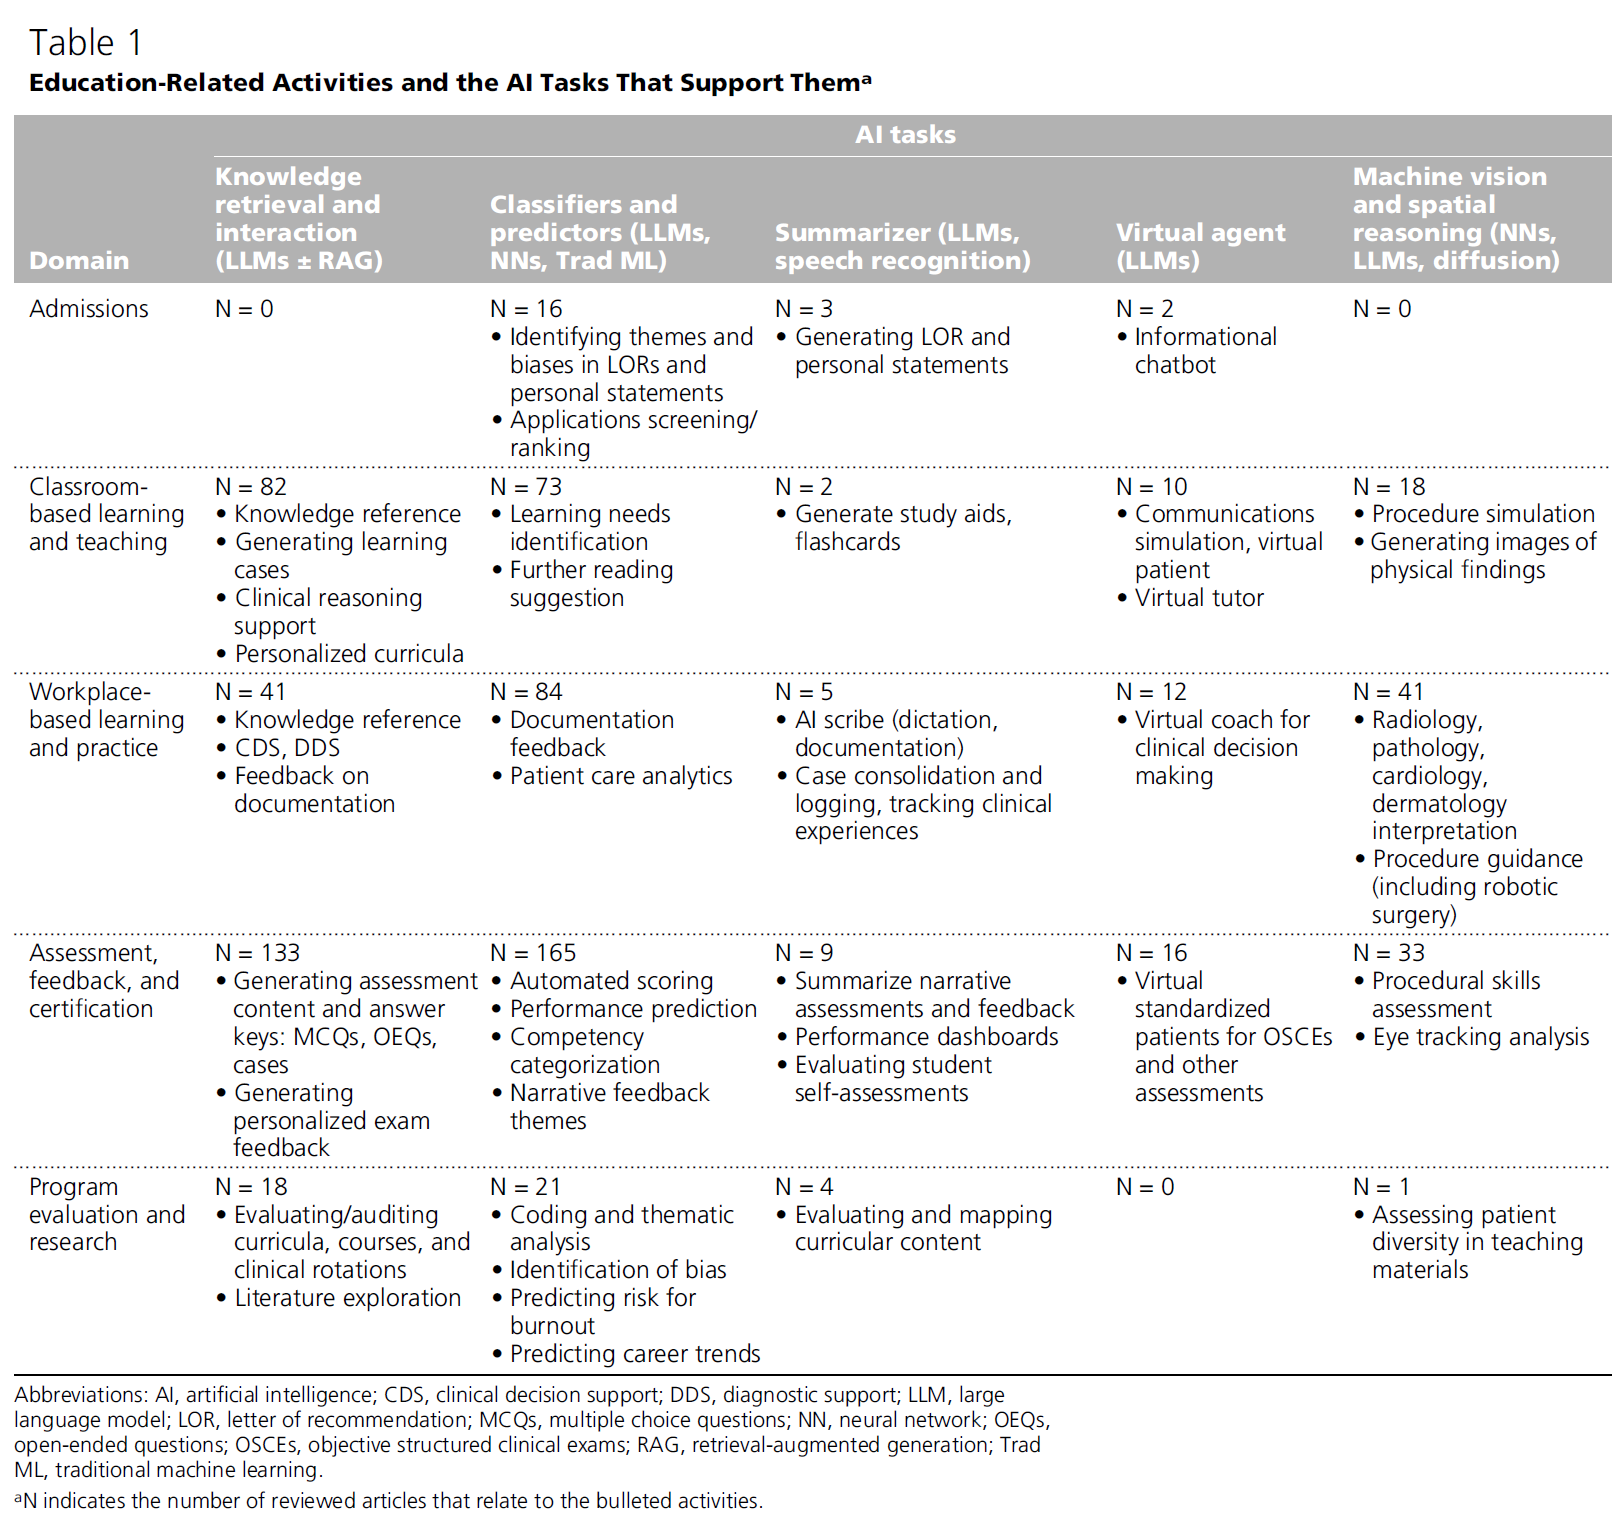
이어서 UCSF의 Christy Boscardin과 UIC의 Brian Gin이 재단 위탁 연구 결과를 발표했어요. 흥미로운 점은 이 연구 자체가 생성형 AI를 활용한 방법으로 2,000편 넘는 논문을 선별하고 정보를 추출했다는 거예요. 여기에 혁신가 인터뷰를 더했고요.

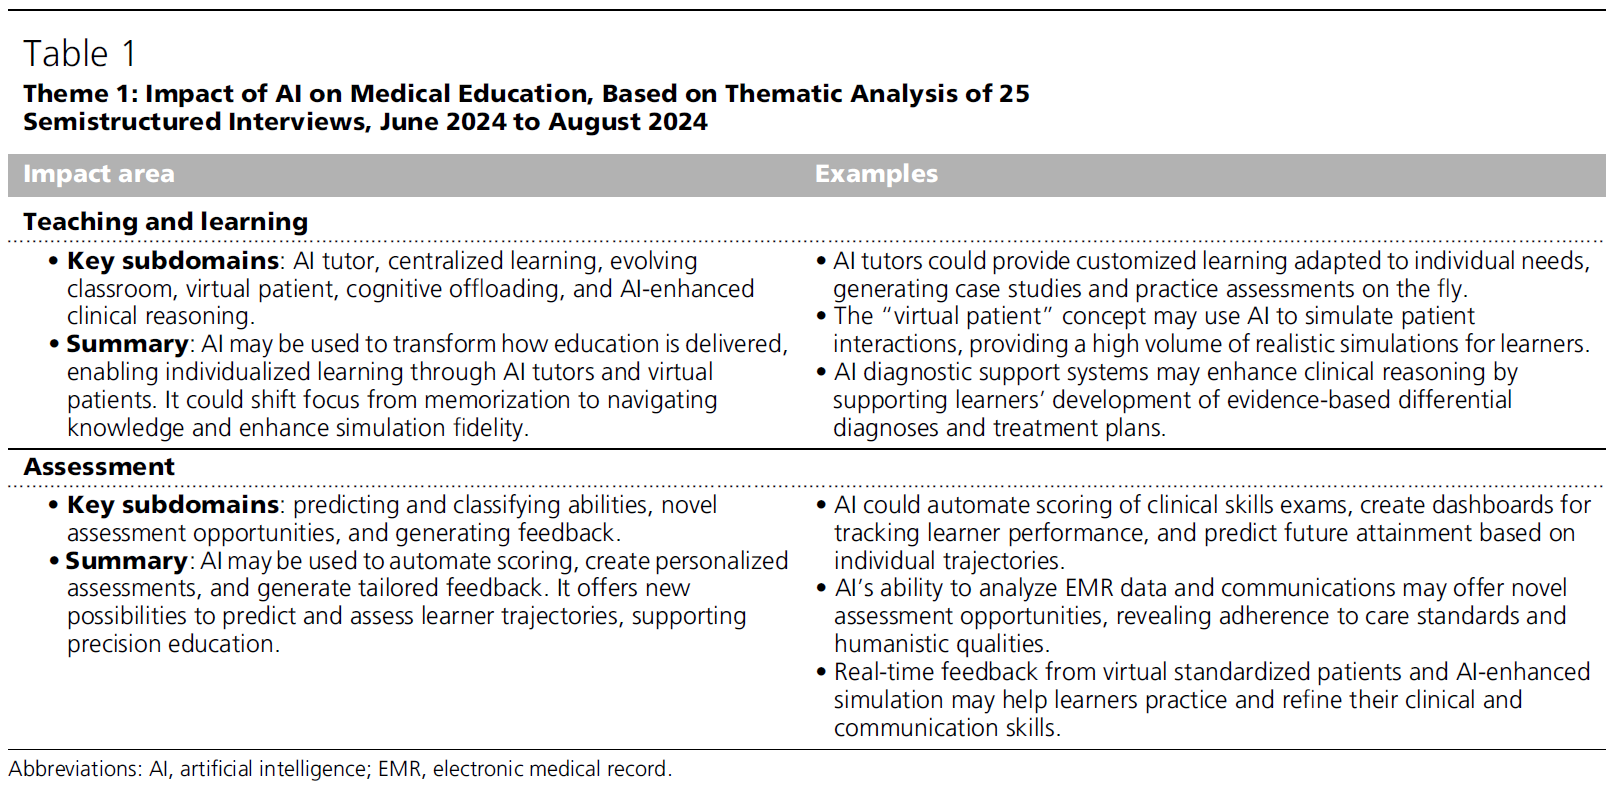
연구진은 AI 활용 사례를 5개 영역으로 정리했어요.

  1. 입학(admissions)
  2. 강의실 기반 교수·학습
  3. 작업장 기반 학습과 실무(workplace-based learning)
  4. 평가, 피드백, 인증
  5. 프로그램 평가와 연구

Boscardin은 CBME와의 관계를 이렇게 설명했어요.

역량바탕의학교육은 20년 동안 있어 왔지만, 특히 피드백, 데이터 관리, 실제적 평가를 둘러싸고 상당한 장벽과 걸림돌을 만났다. 새로운 AI 모델이 이를 해결하는 데 도움을 줄 수 있다.
"Competency-based medical education has been around for 20 years, encountering significant barriers and stumbling blocks, particularly around feedback and data management and authentic assessment, that newer AI models can help resolve."

그리고 우선순위로 의학교육 AI 역량 세트를 "시급히(urgent)" 만들어야 한다고 했어요. AI 때문에 달라지는 의사 역할을 반영해 기존 임상역량도 조정해야 하고, 윤리 기준, AI 산출물 모니터링 체계, 산업계와의 새로운 협력도 필요하다고 봤고요.

🧩 소그룹 논의와 컨퍼런스 목적 선언문

참가자들은 기초 교육과정, 경험 교육과정, 평가, 코칭과 피드백의 4개 그룹으로 나뉘어 논의했어요. 가상의 학습자가 의대부터 외과 전공의까지 AI를 만나는 종단 사례(longitudinal case study) 를 두고 토론했는데, 여기서 나온 과제 중 하나가 눈에 띄어요. AI 혁신과 상관없이 바뀌어서는 안 되는 의학교육의 핵심 요소가 무엇인지 찾자는 거예요.

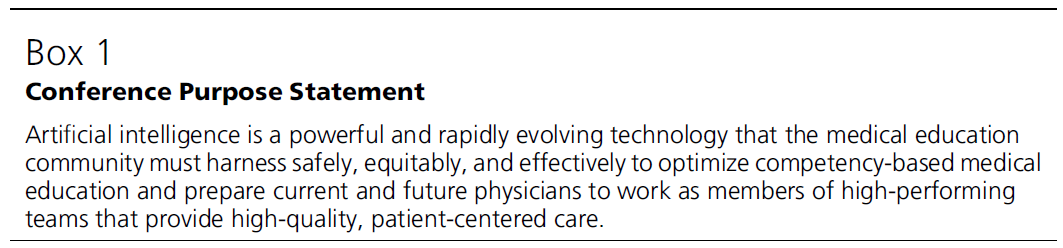
최종 컨퍼런스 목적 선언문(Box 1) 은 이래요.

인공지능은 강력하고 빠르게 진화하는 기술이며, 의학교육계는 역량바탕의학교육을 최적화하고 현재와 미래의 의사가 양질의 환자중심 진료를 제공하는 고성과 팀의 일원으로 일할 수 있도록 준비시키기 위해 이를 안전하고, 형평하게, 효과적으로 활용해야 한다.
"Artificial intelligence is a powerful and rapidly evolving technology that the medical education community must harness safely, equitably, and effectively to optimize competency-based medical education and prepare current and future physicians to work as members of high-performing teams that provide high-quality, patient-centered care."


첫날을 마무리하며 한 참가자가 한 말도 인상적이었어요 💬

AI가 우리에게 '일어나는' 것이 아니라는 점을 기억해야 한다. AI는 우리가 늘 해 온 일, 즉 가능한 최선의 도구, 지식, 기술, 연구로 의사를 교육하는 일을 할 기회를 주고 있다. (...) 그 배당금을 어떻게 쓸지는 우리가 결정한다.
"We should keep in mind that AI is not happening to us [the medical education community]; it is presenting us with opportunities to do what we've always done, which is educate physicians using the best possible tools, knowledge, skills, and research. Incorporating AI [into medical education] is an opportunity that should pay us dividends that we decide how to spend."


🧭 4. 컨퍼런스를 관통한 네 가지 주제

① 교육·정책 프레임워크와 AI 도구 평가 역량

참가자 대부분이 AI 혁신가이자 얼리어답터였는데도 신중함을 강조했고, 무엇보다 거버넌스(governance) 를 우선순위에 두었어요.

모든 사람은 자신이 계속해서 더 많은 훈련이 필요하다는 걸 진심으로 이해할 정도까지 AI 교육을 받아야 한다.
"Everyone should be trained in AI to the point where they really understand that they will continually need more training."


Triola와 Rodman(2025)은 기관 차원의 안전장치(guardrails) 세 가지를 제안했어요.


  • ① 데이터를 보호하고 학업 상황에서 AI를 어디까지 써도 되는지 분명히 하는 정책,
  • ② 안전하고 윤리적인 AI 사용을 정의하고 감독하는 기관 내 거버넌스 기구,
  • ③ 책임 있는 AI 사용을 위한 학습자 역량과 교육과정이에요.


특히 흥미로운 건 Gin 등이 제안한 위임(entrustment) 개념의 적용이에요. 의학교육의 EPA 논리를 AI에게 그대로 적용해 보자는 거죠.

위임 모델은 어떤 과제를 AI가 잘 수행하리라 믿을 수 있고 어떤 과제는 그럴 수 없는지 결정하는 데 도움이 될 수 있다. 개별 수련생이 서로 다른 수준의 감독과 자율성 아래 환자진료 기능을 수행하도록 신뢰받거나 신뢰받지 못하는 것과 마찬가지로 말이다.
"The entrustment model could be used to help us decide which tasks we can rely on AI to perform well and which ones we can't, just as individual trainees are trusted or maybe not trusted to perform patient care functions with different levels of supervision and autonomy."

② 형평성, 편향 완화, 학습자와 환자 중심


  • 형평성 논의는 주로 접근성에 모였어요. 장애가 있거나, 영어가 능숙하지 않거나, 기술에 익숙하지 않거나, 최신 AI 모델의 구독료를 감당할 수 없는 학습자와 교육자는 소외될 수 있어요. 자원이 적은 기관도 마찬가지고요. 그래서 모든 의대생에게 제공해야 할 기본 학습경험(baseline learning experience) 을 정해야 한다고 봤어요.
  • AI가 학습한 데이터 자체가 편향돼 있을 수 있으니, 편향을 알아볼 수 있는 전문가가 검토하고 도입 후에도 지속적으로 모니터링해야 한다는 점도 강조했어요. 학습자의 미래 수행을 예측하는 도구처럼, 학습자나 환자가 동의하지 않은 데이터 2차 활용에 대한 투명성도 중요한 쟁점이었고요.
  • 재미있는 아이디어도 있었어요. 실제 환자들의 기술 활용 수준이 천차만별이니, 학습자도 AI를 전혀 안 쓰는 가상환자부터 AI에 푹 빠진 가상환자까지 다양하게 만나 봐야 한다는 제안이에요. 🧑‍💻👵


③ 새로운 임상가 역할과 관계


  • Ng 등(2023)의 틀에 따르면 미래 임상가는 AI의 소비자(consumers), 번역자(translators), 개발자(developers) 로 나눌 수 있어요.
    • 소비자는 AI 도구를 고르고 효과적으로 쓸 줄 알면 되고,
    • 번역자는 소비자이면서 어느 정도 개발도 할 수 있는 사람,
    • 개발자는 임상 전문성 위에 깊은 AI 역량을 갖춘 사람이에요.
  • 한 참가자는 AI를 인지적 도구로만 보는 시각을 넘어서자고 했어요.


지금까지 의학교육에서는 AI를 인지적 과제로 생각하는 경향이 있었다. 임상추론을 어떻게 발전시킬 수 있을지에 집중했다. 하지만 이건 대인 상호작용과 관계 역학의 문제이기도 하다. 임상가와 환자 사이, 그리고 진료팀 안팎의 관계 말이다. 나는 이것이 환자진료에 더 인본주의적이고 총체적인 팀 접근을 위한 여지를 만들 것이라고 생각한다.
"In medical education so far, we tend to think about AI as a cognitive exercise; we focus on how it can advance clinical reasoning. But it's also about interpersonal interaction and relationship dynamics—between clinicians and patients and within and among care teams. I think it's going to create room for a more humanistic and global team approach to patient care."


  • 이 참가자는 AI를 진료팀의 또 다른 구성원으로 생각하자고 제안했어요.
  • 또 하나 중요한 키워드가 인간 참여 감독(human-in-the-loop oversight) 이에요. AI 산출물은 당분간 불완전할 테니, 임상가가 핵심 기술을 유지하면서 안주(complacency) 와 자동화 편향(automation bias) 을 피하도록 준비시키는 게 필수라는 거예요. 참가자들은 특히 기초생물과학 지식과 그것을 임상추론에 적용하는 능력을 유지하는 게 중요하다고 입을 모았어요.
  • AI가 일부 직종을 대체할 수 있다는 우려도 나왔지만, 논의는 계속 "AI는 임상가를 보완하는 도구"라는 쪽으로 돌아왔어요. Sezgin(2023)의 표현이에요.


인간과 AI의 협업은 "보건의료 제공자의 인지적 강점과 AI의 분석 능력을 결합"하며, "AI 시스템이 인간 전문성에 의해 안내되고, 소통되고, 감독되도록 보장함으로써 의료서비스의 안전과 질을 유지한다."
collaboration between humans and AI "combines the cognitive strengths of health care providers with the analytical capabilities of AI" and "ensures that AI systems are guided, communicated, and supervised by human expertise, thereby maintaining safety and quality in health care services."

④ 협력, 파트너십, 연구 의제


  • 생성형 AI 도입은 시간이 급하고, 돈과 기술 전문성이 많이 들어요. 그래서 독립성이 강한 학술의료기관들도 이제 서로, 그리고 기술 기업과 협력해야 한다는 거예요.
  • 연구에 대해서는 꽤 비판적인 인용이 나와요.


AI 연구는 흔히 부실하게 보고되고, 많은 검증 연구가 결함 있는 방법론을 보이며, 마케팅은 종종 환자에 대한 AI 응용의 입증된 이점을 과장한다.
"AI research is frequently poorly reported, many validation studies exhibit flawed methodology, and marketing often overstates the evidenced benefit for AI applications for patients."


  • 그리고 연구자라면 누구나 공감할 고민도 있었어요 😅


비싼 연구비를 받아 연구를 수행하고 출판할 때쯤이면, 당신이 다룬 기술은 이미 구식이 되어 있다.
"By the time you get your very expensive research funded, conducted, and published, the technology you've focused on is already obsolete."


  • 보고서는 이 부분을 다시 Chang 부학장의 말로 정리해요.


아마 수십 년에 한 번쯤, 우리가 의대생을 가르치는 방식과 그들이 의사가 되었을 때 할 수 있기를 기대하는 것에 진정한 혁명이 일어난다. 지금이 바로 그런 때다.
"Maybe once every few decades a true revolution occurs in the way we teach medical students and what we expect them to be able to do when they become doctors. This is one of those times."


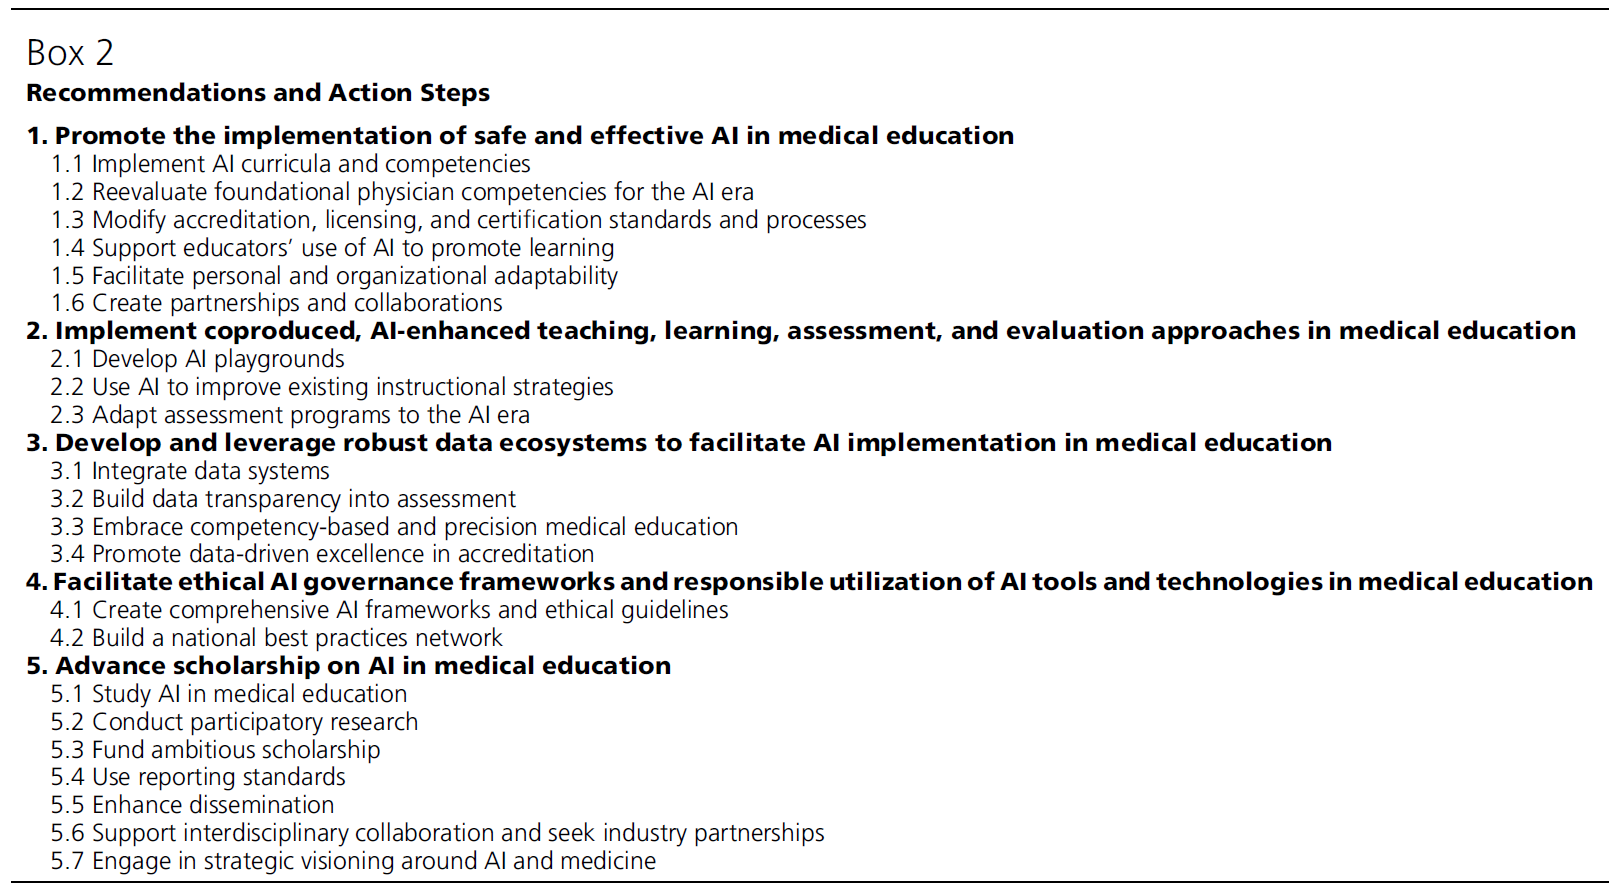
📊 5. 5개 권고와 22개 실행 단계 

이제 본론인 권고안이에요. 먼저 전체 구조를 표로 볼게요.

권고 실행 단계
1. 안전하고 효과적인 AI 도입 촉진 1.1 AI 교육과정과 역량 도입
1.2 AI 시대 의사 기초역량 재평가
1.3 인증·면허·자격 기준 수정
1.4 교육자의 AI 활용 지원
1.5 개인·조직의 적응력 강화
1.6 파트너십 구축
2. 공동생산(co-produced)한 AI 기반 교수·학습·평가 도입 2.1 AI 놀이터(AI playgrounds) 개발
2.2 기존 교수전략 개선에 AI 활용
2.3 AI 시대에 맞게 평가 프로그램 조정
3. 탄탄한 데이터 생태계(data ecosystems) 구축 3.1 데이터 시스템 통합
3.2 평가 데이터의 투명성
3.3 CBME와 정밀교육 수용
3.4 데이터 기반 인증
4. 윤리적 AI 거버넌스와 책임 있는 활용 4.1 포괄적 AI 프레임워크와 윤리 지침
4.2 전국 모범사례 네트워크 구축
5. 의학교육 AI 연구 진흥 5.1 AI 교육 효과 연구
5.2 참여적 연구
5.3 과감한 연구 지원
5.4 보고 기준
5.5 확산 개선
5.6 학제 간·산업계 협력
5.7 AI와 의학의 전략적 비전 수립

전부 설명하긴 길어서, 제가 보기에 특히 의미 있는 대목만 골라 볼게요 ✍️

🔑 권고 1: 무엇을 더하고, 무엇을 뺄 것인가

1.1에서는 AI의 형태, 기능, 능력, 한계, 사회적 함의를 다루고, 도구를 비판적으로 평가하고 환각과 편향 같은 약점을 완화하는 기술까지 가르치라고 해요. 그리고 교육과정의 효과를 학습자와 환자 성과로 평가하라고 하고요.

제가 가장 중요하다고 본 건 1.2예요. AI 시대에 맞게 의사 기초역량을 다시 보자는 건데, "무엇을 뺄지"까지 고민하라고 해요.

의사 업무 중 어떤 요소를 AI에 위임해야 하는지, 그리고 AI가 가능한 환경에서 수련생에게 더 이상 필수적이지 않을 수 있어 기존 교육과정에서 제거해야 할 요소는 무엇인지 신중하게 고려해야 한다.
"They should carefully consider which elements of physician work should be entrusted to AI and which elements of the existing curriculum should be removed because they may no longer be essential for trainees in AI-enabled environments."

그런데 바로 이어서 신중해야 한다는 단서도 달아요.

이러한 고려는 AI 도구의 가용성과 효과가 어느 정도 예측 불가능하고 진료 환경마다 균일하지 않다는 점, 그리고 가까운 미래에는 의사가 진단과 치료 같은 영역에서 고부담 AI 산출물을 감독하는 책임을 지게 될 것이라는 점을 인정해야 한다.
"These considerations should recognize that the availability and effectiveness of AI tools are both somewhat unpredictable and not uniform across care settings, and that—for the foreseeable future—physicians will be charged with overseeing high-stakes AI outputs in areas like diagnosis and therapy."


그 밖에 이런 제안이 있어요.

  • 1.3: 인증, 면허, 자격 기관이 AI 역량을 기준과 면허·자격 평가에 넣는 방안 검토
  • 1.4: 교수개발 지원, 컴퓨팅 인프라 제공, 문서 초안 작성이나 수작업 채점 같은 저가치 반복 업무(low-yield, routine tasks) 를 AI에 넘기기
  • 1.5: 정기적으로 모여 역량과 교육과정을 업데이트하는 AI 교육과정 검토위원회(AI curriculum review board)
  • 1.6: 학부와 졸업후 교육을 아우르는 교육 디지털혁신실(Office of Educational Digital Innovation)

🎮 권고 2: 함께 만들고, 마음껏 실험하라

권고 2의 핵심어는 공동생산(co-production) 이에요. 학습자, 교수, 다직종 팀원, 환자, AI 전문가가 함께 플랫폼을 만들자는 거죠.

2.1 AI 놀이터(AI playgrounds) 는 이름부터 재밌어요. 학습자와 교수가 실제 운영 환경의 제약 없이 AI 도구를 탐색하고 실험할 수 있는 안전한 공간이에요.

2.3 평가 부분은 꽤 과감해요.

AI 도구가 임상 실무에 스며들 것임을 인식하고, 따라서 평가 환경에도 스며들어야 한다.
"Recognize that AI tools will permeate clinical practice and, thus, should also permeate the assessment environment."

AI를 평가에서 "막아야 할 것"으로만 보지 말고, 실제 진료처럼 평가에도 들여오라는 거예요. 또 의사소통, 시스템기반 진료, 전문직업성처럼 전통적으로 측정하기 어려웠던 역량을 AI로 평가하는 방안도 검토하라고 해요.

🗄️ 권고 3: 교육 데이터와 임상 데이터를 잇자

표준화된 스키마와 공유 어휘(standardized schema and a shared vocabulary) 로 교육 데이터와 임상 데이터를 합친 데이터 생태계를 만들자는 권고예요. 양방향 데이터 통합(bidirectional data integration) 을 하면 임상 실무가 교육에 정보를 주고, 반대로 교육이 임상 성과에 어떤 영향을 주는지도 측정할 수 있어요.


제가 눈여겨본 건 3.2 학습자 데이터 주권이에요.

공동생산과 투명한 사용, 그리고 가능한 경우 형성평가 데이터에 대한 소유권을 통해 학습자에게 권한을 부여하고 그들의 안전과 신뢰를 우선시하라.
"Empower learners and prioritize their safety and trust through co-production and transparent use—and, where feasible, ownership—of their formative assessment data."


  • 3.3에서는 AI 평가가 교수의 관찰을 대체하는 게 아니라 함께 가야 한다고 분명히 해요.
  • 3.4에서는 인증기관에게 인증 심사 과정, 보고서, 결정에 AI를 쓴다면 그 사실을 투명하게 밝히라고 권고해요. 🔍


🛡️ 권고 4: 윤리적 거버넌스

AMA, AAMC, AACOM, ACGME, ABMS 같은 기관들이 협력해서 포괄적 AI 프레임워크와 윤리 지침을 만들고, 전국 모범사례 네트워크(national best practices network) 를 꾸리자는 권고예요. 이 네트워크는 검증된 AI 교육자원을 무료로, 형평하게 쓸 수 있는 중앙 저장소를 운영하고, 교육과정, 교수개발, 윤리, 평가별 워킹그룹을 두는 형태를 제안해요.

🔬 권고 5: 연구, 더 엄격하게 그리고 더 빠르게

  • 5.1: AI 기반 교육 개입을 기존 표준과 비교하는 엄격한 실험·관찰 연구. 편향과 불평등 같은 의도하지 않은 결과도 평가
  • 5.2: 학습자, 교육자, 환자, 행정가가 참여하는 참여적 연구(participatory research)
  • 5.4: AI 관련 교육연구의 보고 기준(reporting standards) 합의
  • 5.5: 더 빠르고 효율적인 연구 확산 방식
  • 5.7: AI 시대 의사의 미래 역할에 대한 전략적 비전 수립

✅ 6. 결론: 측정과 적응력

보고서의 결론은 짧아요.

AI의 빠른 진화를 고려할 때, 엄격한 측정(의도한 결과와 의도하지 않은 결과 모두)과 적응력을 갖춘 접근이 필수적일 것이다. 그래야 이 놀라운 새 도구를 활용하면서도 우리의 변함없는 목표, 즉 최첨단 기술을 활용해 인간의 건강을 증진하는 의사를 양성한다는 목표를 지킬 수 있다.
"Given the rapid evolution of AI, an approach incorporating rigorous measurement (of both intended and unintended consequences) and adaptability will be essential as we harness these remarkable new tools while preserving our enduring goal: training physicians who leverage cutting-edge technology to promote human health."


💡 7. 읽으며 든 생각과 한국 의학교육에 주는 시사점

마지막으로 제 생각을 조금 덧붙일게요. 어디까지나 제 해석이에요.


  • ① 읽기 전에 알아 둘 한계 🧐
    • 보고서 스스로 밝히듯, 참가자 대부분이 AI 혁신가와 얼리어답터였어요. 또 Macy 컨퍼런스 권고는 "합의이지만 모든 항목에 만장일치를 뜻하지는 않는다" 고 명시돼 있어요. 권고의 방향이 전반적으로 적극적인 건 이런 구성과도 관련이 있을 거예요. 흥미롭게도 이 보고서 자체도 참가자 동의를 받아 녹음한 논의를 AI로 요약한 자료를 활용해 작성했다고 투명하게 밝히고 있어요.
  • ② "무엇을 뺄 것인가"라는 질문 ✂️
    • 권고 1.2는 역량을 더하는 것만큼 빼는 것을 진지하게 고민하라고 해요. 그런데 동시에 기초과학 지식과 임상추론은 반드시 지켜야 한다고 강조하죠. "AI 때문에 무엇이 덜 중요해졌는가"와 "AI 때문에 무엇이 더 중요해졌는가"를 함께 따져 보는 작업이, 교육과정 개편을 준비하는 학교라면 피할 수 없는 과제일 것 같아요.
  • ③ 앞 글(AAMC 기초역량)과 이어서 보기 🔗
    • 지난번에 소개한 미국 UME 기초역량에도 "신기술을 활용해 지식에 접근한다", "신기술 사용의 위험과 이익을 평가한다"는 세부역량이 이미 들어가 있었죠. 이번 Macy 권고는 여기서 한 걸음 더 나가서 별도의 AI 역량 세트, 인증·면허 기준 반영, 평가 환경의 변화까지 요구하고 있어요. 두 문서를 함께 보면 미국 의학교육이 어느 방향으로 움직이는지 꽤 잘 보여요.
  • ④ 데이터 생태계와 거버넌스는 우리에게도 숙제 🗂️
    • CBME와 WBA를 확대하다 보면 결국 평가 데이터를 어떻게 모으고, 통합하고, 해석할 것인가의 문제에 부딪혀요. 이번 권고는 그 해법의 하나로 AI를 제시하면서도, 학습자 데이터의 투명성과 소유권, 편향 모니터링, 인증기관의 AI 사용 공개까지 함께 요구해요. 우리 기관에 AI 사용 정책이나 거버넌스 기구가 있는지, 학습자 데이터를 누가 어떻게 쓰는지부터 점검해 보면 좋겠다는 생각이 들어요.


📝 정리하며

  • Macy 재단이 2024년 11월 AI·의학교육 전문가 41명과 함께 5개 권고, 22개 실행 단계를 내놓았어요.
  • AI는 CBME와 정밀교육의 오랜 걸림돌(데이터, 피드백, 실제적 평가) 을 풀 수 있는 기회지만, 의사를 알고리즘의 수동적 실행자로 만들 위험도 있어요.
  • 핵심 키워드는 거버넌스, 형평성, 공동생산, 인간 참여 감독(human-in-the-loop), 데이터 생태계, 엄격한 연구예요.
  • 기초역량을 다시 보고 무엇을 AI에 맡기고 무엇을 뺄지 고민하되, 기초과학 지식과 임상추론은 지켜야 한다고 강조해요.
  • 결론은 엄격한 측정과 적응력이에요.

같은 부록에 실린 Boscardin·Gin의 Macy 혁신 보고서 Part I, II(Acad Med 2025;100(9S):S15–S29)와 Gin 등의 AI를 위한 위임과 EPA 논문(Acad Med 2025;100(3):264–272)도 함께 읽어 보시면 좋아요. 📎

덧붙여, 이 컨퍼런스를 이끈 Macy 재단 이사장 Holly J. Humphrey 박사는 보고서가 나오기 전인 2025년 4월 17일에 세상을 떠났어요. 미국 최초의 화이트코트 세리머니를 이끌었고, 학생들이 뽑은 최우수 교수상을 25번 받은 분이에요. 삼가 고인의 명복을 빕니다. 🕊️


인공지능(artificial intelligence, AI)은 의료를 포함한 사회의 모든 부문을 변화시킬 기회를 만들고 있다. 투명성(transparency), 책무성(accountability), 윤리(ethics)의 원칙에 뿌리를 두고 AI를 신중하게 도입한다면, 우리는 보건의료체계를 더 효율적이고 효과적이며 형평성 있게 만들 수 있다.1,2 이러한 성과를 달성하고 잠재적인 부정적 결과를 피하려면, 현재와 미래의 AI 기술을 활용하는 능력에 점점 더 의존하게 될 의사와 다른 보건의료 전문직의 교육·훈련도 이에 발맞추어 AI를 활용하는 방향으로 전환해야 한다.


의료계는 수십 년 동안 AI를 사용해 왔으며, 주로 데이터의 추세와 패턴을 분석하여 결과를 예측하는 예측형 AI(predictive AI)를 이용했다(AI 용어집은 http://links.lww.com/ACADMED/B719의 디지털 보충 부록 1 참조). 그러나 최근 방대한 데이터에서 학습한 패턴을 바탕으로 ‘인간과 유사한’ 콘텐츠를 생성하는 생성형 AI(generative AI)가 등장하면서 전 세계적으로 큰 반향을 일으켰고, 의료와 그 밖의 분야에서 AI에 대한 관심이 급격히 높아졌다. 보건의료체계 전반에서 OpenAI의 GPT, Google의 Gemini, Anthropic의 Claude와 같은 생성형 AI 도구가 행정, 임상 진료, 연구에 활용될 가능성이 탐색되고 있다. 환자들도 건강 관리를 돕기 위해 생성형 AI 도구를 사용한다. 보건의료 전문직 교육(health professions education)에서는 학부 및 대학원 단계의 입학 선발, 교수·학습, 학습자 평가(assessment), 프로그램 평가(evaluation), 연구를 향상할 잠재력을 지닌 생성형 AI 응용 프로그램을 탐색하고 도입하고 있다.3 또한 생성형 AI는 전문직 간 교육(interprofessional education), 역량바탕 의학교육(competency-based medical education), 정밀교육(precision education)을 포함한 성과 중심 교육 틀로의 전환을 가속할 것으로 기대된다.2–5 하버드 의과대학 의학교육 학장인 Bernard Chang 박사는 2024년에 “몇 년 안에 생성형 AI가 모든 것에 내장될 것”이라고 말했다.6


미국과 전 세계에서 이처럼 새로운 의료 환경이 펼쳐지는 가운데, 의학교육계는 계속 진화하는 AI가 교수·학습·학습자 평가·프로그램 평가에 책임 있고 윤리적인 방식으로 통합되도록 노력해야 한다. 이러한 필요성이 2024년 11월 조시아 메이시 주니어 재단(Josiah Macy Jr. Foundation)이 개최한 회의의 동기가 되었으며, 이 회의에는 AI와 의학교육 전문가 41명이 모였다. 재단 회장인 Holly J. Humphrey 박사는 “건강을 개선하기 위한 수단으로서 보건의료 전문직 교육의 향상에만 전념하는 유일한 전국적 지원 기관인 조시아 메이시 주니어 재단은 현재와 미래 학습자의 교육·훈련에 AI의 힘을 활용하려는 의학교육자들의 노력을 지원할 책임이 있다”고 설명했다. 이 보고서는 회의 경과를 개괄하고, 교수·학습에 AI를 통합하는 데 초점을 맞춘 일련의 권고안을 의학교육계에 제시한다.

회의의 배경, 개요, 목적 (Conference Background, Overview, and Purpose) 

2022년 11월 OpenAI는 무료 버전의 ChatGPT를 공개했고, 이는 곧 현대사에서 가장 빠르게 도입된 기술이 되었다.7 생성형 AI는 거의 모든 인간 활동에 영향을 미칠 잠재력 때문에 전기, 컴퓨터, 인터넷과 함께 범용 기술(general purpose technology)로 일컬어진다.8 의료 분야에서는 과거 상당한 인적 노력이 필요했던 업무를 수행하도록 생성형 AI로 강화한 도구가 개발되고 있다.9 최근 한 연구에 따르면 미국의 의사와 간호사는 환자기록 유지, 보험 서류 작성, 시술 기록 등을 포함한 서류 업무에 일주일에 거의 28시간을 쓴다.10 이론적으로 일상적인 서류 업무나 기계적인 암기와 같은 특정 과업을 AI에 맡기면 교수자와 학습자 모두 의학 고유의 인간적 활동을 수행하고 배우는 데 더 많은 시간과 에너지를 쏟을 수 있다. 여기에는 비판적 사고와 적응적 학습 능력, 감별진단이나 새로운 치료 선택지에 관한 AI 생성 응답의 해석과 검증, 신체진찰 및 기술의 도움을 받는 환자 진찰, 환자·가족과의 소통, 환자·동료와 신뢰 관계 구축이 포함될 수 있다.

의학교육에서 AI의 기회와 위험 (Opportunities and risks of AI in medical education) 

생성형 AI는 평범한 과업의 수행을 넘어, 대량의 자료(예: 환자 진료기록, 학술논문, 미디어 파일) 요약, 임상 문서 작성, 데이터 분석, 교육과정 개발, 개인화 학습, 임상 상황 시뮬레이션, 수련생 평가, 프로그램 평가, 실시간 튜터링 또는 코칭과 같은 고차원적 활동까지 AI의 능력을 빠르게 확장했다. 이러한 AI 역량은 전문직 간 교육, 역량바탕 의학교육, 정밀교육의 발전을 가속하고 있다. 이 교육 모형들은 환자와 학습자의 성과를 개선하기 위한 것이지만, 데이터와 적절한 분석 방법의 부재 때문에 부분적으로 시행하기 어려웠다.2,4,5 지난 15년 동안 메이시 재단은 연구비 지원, 회의, 권고안 보고서·단행본·학술지 특별부록 발행을 통해 의과대학과 임상 학습환경에서 전문직 간 교육과 역량바탕 교육을 발전시키려는 의학교육자들의 노력을 적극적으로 지원해 왔다.11–13 새롭게 등장한 정밀교육은 미국의사협회(American Medical Association)의 ChangeMedEd 사업에서 우선순위가 높은 중점 분야14이며, 메이시 재단의 의학교육 지원 우선순위와 목표에도 부합한다.


AI를 의학교육에 적용할 때 기대되는 흥미로운 가능성 중 하나는 역량바탕 의학교육의 시행을 돕는 것이다. 역량바탕 의학교육은 의미 있고 형평성 있는 평가를 우선시하며, 학습자가 양질의 환자 진료를 보장하기 위해 설정된 역량을 습득하도록 하는 데 초점을 맞춘다. 역량바탕 접근법은 세계 여러 지역의 임상 수련에서 널리 사용되지만,15 “복잡성, 표준화 부족, 제한된 경험적 근거, 잠재적인 평가 편향” 때문에 충분하고 효과적으로 시행하는 데 어려움이 있었다.16 2021년 미국국립의학한림원(National Academy of Medicine, NAM) 보고서에 따르면 역량바탕 의학교육은 “각 학습자에 관한 풍부한 프로그램 차원 평가 자료”에 의존하기 때문에 “학습에 활용할 수 있도록 그러한 자료를 관리하고 시각화하고 해석”하는 데 어려움이 있으며, AI를 사용하면 이 모두에 잠재적으로 대응할 수 있다.2 서술형 피드백(narrative feedback)의 질을 평가하기 위해 자연어처리(natural language processing)를 사용하는 등, AI를 활용하여 역량바탕 교육의 일부 요소를 개선할 수 있음을 보여 주는 유망한 연구들이 발표되었다(자연어처리 등의 AI 용어집은 http://links.lww.com/ACADMED/B719의 디지털 보충 부록 1 참조).17


보다 최근에는 의학교육자들이 최적화된 개인맞춤형 의학교육 모형으로 정밀교육을 채택하기 시작했다. 정밀교육은 임상의가 개별 환자에게 치료를 맞추는 정밀의학(precision medicine)의 개념과 맥을 같이하며, 형평성과 풍부한 평가를 포함하는 역량바탕 교육의 우선순위도 포괄한다. 정밀교육은 “데이터와 기술을 사용해 개인·프로그램·조직 차원의 개인화, 효율성, 주체성(agency)을 높임으로써 평생학습을 변화시킨다.”18 DxMentor가 실제 사례다. 뉴욕대학교 의학교육자들이 개발·도입한 이 도구는 병원의 전자의무기록(electronic health record) 시스템과 교육자료의 디지털 목록을 연결하여, 학습자와 지도교수에게 최근 입원시킨 환자의 건강 요구와 관련된 자료를 제공한다.19 각 학습자의 요구에 맞게 자료를 제공하는 이 적시 학습(just-in-time) 도구의 콘텐츠는 사람의 개입 없이 AI가 선별한다.


AI가 의학교육을 발전시킬 잠재력에 큰 기대가 쏠리지만, 의학교육자와 연구자들은 회의적인 시각도 보인다. 예를 들어 미래의 의사가 자신에게 필요한 기초 의학 지식의 범위와 깊이를 명확하고 근거에 기반하여 이해하지 못한다면, AI로 보강된 환자 진료를 능동적으로 관리하기보다 알고리즘의 의사결정을 수동적으로 실행하는 사람이 될 수 있다.


  • 2023년 《뉴잉글랜드 의학저널》(New England Journal of Medicine)의 논평은 AI가 인지적 도제학습(cognitive apprenticeship), 노력이 수반되는 공부, 의도적 연습(deliberate practice), 윤리적 준칙이라는 의학의 오랜 전통을 뒤흔들 수 있다는 이유로 의학교육에서의 AI를 “판도라의 상자”라고 불렀다.20
  • 마찬가지로 《가정의학》(Family Medicine)의 한 사설은 의학교육에서 AI 적용을 “고위험 활동”으로 규정하고, 도구를 널리 사용하기 전에 “안전하고 검증되었는지” 확인할 수 있도록 사람의 감독을 촉구했다.21
  • Ng와 동료들에 따르면 현재 의료 인력의 AI 지식과 기술 수준은 “낮으며”, 이 때문에 배포·시행 과정에서 부정확성과 편향, 윤리적 난제, 불명확하거나 집행되지 않는 거버넌스, 해석하거나 설명할 수 없는 모델 작동 방식과 같은 “심각한 문제”가 생길 수 있다.22


의학교육자들은 AI가 교육 현장에 빠르게 진입하는 데 대해 추가적인 우려도 품고 있다. 여기에는


  • 학문적 진실성(academic integrity)에 관한 우려(예: 학습자의 부정행위와 표절 기회),
  • AI 도구의 정확성과 신뢰성에 관한 우려(예: 편향을 영속화하거나 ‘AI 환각(AI hallucinations)’이라고 하는 조작된 결과를 포함해 부정확한 답을 생성할 가능성),
  • 복잡한 학습환경에 대한 위해 우려(예: 학습자가 AI에 지나치게 의존하거나 교수·학습의 자원 불평등을 악화할 가능성)가 포함된다.21,23
  • 데이터의 사생활 보호와 보안도 우려 대상이다. AI가 의료와 의학교육에 더욱 깊숙이 스며들고 의사결정에서 데이터 사용이 기하급수적으로 늘어나면서, 건강보험 이동성 및 책무성에 관한 법률(Health Insurance Portability and Accountability Act, HIPAA)과 가족 교육권 및 사생활 보호법(Family Educational Rights and Privacy Act, FERPA)이 요구하는 환자와 학습자의 개인정보 보호 문제도 확대된다.21


일부 의학교육 지도자와 기관은 AI 정책, 원칙, 역량을 제안했다.24,25 의학교육을 발전시키는 동시에 혼란을 초래할 수도 있는 AI의 막대한 잠재력, 그리고 앞으로 나아가기 위한 권고안을 함께 구상할 필요성에 따라 메이시 재단은 의학교육과 AI 분야의 저명한 전문가·혁신가들로 회의 기획위원회를 구성했다. 재단 이사회 위원이자 캘리포니아대학교 샌프란시스코(UCSF) 의과대학 내과 학과장인 Robert Wachter 박사가 이끈 이 위원회(아래의 회의 참가자·저자 명단 참조)는 2024년 11월 18~21일 조지아주 애틀랜타에서 개최된 ‘2024 메이시 재단 의학교육 AI 회의’를 설계했다.

의학교육 AI의 현재 현황과 미래 방향 (Current landscape and future directions of AI in medical education) 

회의 첫날은 의학교육에서 AI에 관한 논의를 진전시킬 동료 공동체를 모으는 데 초점을 맞췄다. 회의는 사우스캐롤라이나주 최대 학술의료체계인 사우스캐롤라이나 의과대학교(Medical University of South Carolina, MUSC) Health의 최고경영자 Patrick Cawley 박사가 학술의료센터와 의료체계의 일상 업무에 AI를 통합할 때 따르는 기회와 과제를 설명하는 것으로 시작했다. 이어 UCSF의 Christy Boscardin 박사와 일리노이대학교 시카고의 Brian Gin 박사가 메이시 재단의 의뢰로 수행한 의학교육 AI 현황 연구보고서(이 특별부록에 두 편으로 나누어 출판됨)를 발표하며 현재 상태와 미래의 기회·과제를 요약했다.26,27 첫날은 소그룹 및 전체 토론으로 마무리되었으며, 참가자들은 권고안을 작성하고 이에 대한 합의를 구축할 토대를 마련했다.

AI에 대한 의료체계 최고경영자의 관점 (A health system CEO’s view of AI) 

환자 진료, 보건의료 전문직 교육, 연구에 사명을 둔 학술의료체계와 학술의료센터는 의료 분야 AI 혁명의 중심에 서 있다. Wachter 박사의 인터뷰에서 Cawley 박사는 MUSC의 디지털 전환이 2019년에 공식적으로 시작되었고, 2022년 ChatGPT 출시 이후 더욱 가속되었다고 말했다. 그는 “[ChatGPT가 등장했을 때] 우리는 곧장 출발했습니다. [우리는] 기존의 방식을 계속할 수 없다는 것을 알았습니다”라고 말했다. Cawley 박사는 기회와 함께 경쟁상의 위협도 인식했다. 다른 의료체계가 AI를 효과적으로 통합하는 동안 MUSC가 뒤처진다면 “우리는 낙오할 것”이라고 했다.


Cawley 박사는 의료체계 최고경영자로서 MUSC 환자들이 우려하는 두 가지 문제, 즉 상승하는 의료비와 의료 접근의 장벽에 초점을 맞춘다고 말했다. 그는 AI가 주로 효율성을 높여 이러한 우려에 대응할 수 있다고 믿는다. 그는 “이전에 보지 못한 방식으로 비용을 유발하는 관료적 절차를 실제로 없앨 수 있습니다”라고 말했다. Cawley 박사는 비용보다 더 큰 걱정거리이지만 해결하기도 더 어려운 의료 접근성 확대 능력에 대해서도 열의를 보였다. 특히 1차의료를 비롯한 모든 전문과목에 의사가 부족하므로 그는 접근성을 높일 방안을 생각하는 데 많은 시간을 쓴다. 그는 AI 도구를 사용한 환자 차트 요약, 진료 계획의 공백 파악, 약물 최적화, 최적의 진료 장소 결정 등을 포함하여 “환자 진료 중, 특히 의학적으로 복잡한 환자를 볼 때 개선할 수 있는 일이 많다”고 말했다. AI가 가져올 효율성 향상이 역설적으로 의사에게 맡겨지는 환자 수를 늘려 업무량을 확대할 수 있다는 의사와 환자 모두의 우려에 대한 질문을 받자, Cawley 박사는 진료기록을 갱신하고 보험 서류를 작성하느라 근무시간 이후까지 일할 필요를 없애는 등 AI를 사용해 의사의 소진을 완화하고 직무 만족도를 높이는 데 관심이 있다고 말했다.


특히 의학교육에 AI가 미칠 영향에 관한 질문에 Cawley 박사는 의학교육이 씨름해야 할 엄청난 변화 가능성을 설명했다. 여기에는 교육과 훈련에도 통합해야 하는 임상 진료 기술의 급속한 발전이 포함된다. 그는 “어떤 AI 강화 도구를 사용하고 어떻게 사용할지 모두가 빠르게 익히도록 해야 합니다”라고 말했다. 의료체계는 잠재적인 정확성·보안 문제에 대응하고 AI 도구의 안전성을 보장해야 한다고 했으며, 특히 생성형 AI 도구에 프롬프트(prompt)를 입력하는 방법과 결과의 타당성을 평가하는 방법을 사용자에게 즉시 가르쳐야 한다고 강조했다. 그는 “모두가 AI에 질문하는 법을 배워야 합니다. 매번 다른 답을 줄 수 있기 때문입니다. 거의 일종의 기술입니다”라고 말했다.

의학교육 AI 현황 보고서 (Report on AI landscape in medical education) 

회의 전에 참가자들은 의학교육에서 현재 AI의 현황을 조사하고 미래에 대한 함의를 제시한 의뢰 연구보고서인 「의학교육 AI에 관한 메이시 재단 혁신 보고서」(The Macy Foundation Innovation Report on AI in Medical Education)를 읽었다. 이 보고서는 이 특별부록에 두 편으로 출판되었다.26,27 책임연구자인 Boscardin과 Gin도 회의에서 연구의 세부사항을 발표했다. 이들은 생성형 AI의 도움을 받아 관련 학술논문 2,000편 이상을 추려 내고, 남은 논문을 검토해 정보를 추출했으며, AI 도구가 의학교육에서 어떻게 사용될 가능성이 탐색되는지와 그 한계 및 향후 적용 가능성을 어떻게 파악했는지 설명했다.26 저자들은 의학교육과 AI 분야의 혁신가들을 인터뷰하여 현재 상황에 대한 생각과 미래의 우선순위에 관한 통찰도 얻었다.27


이 의뢰 연구는 의학교육의 다섯 영역, 즉 (1) 입학 선발, (2) 강의실 기반 학습·교수, (3) 일터 기반 학습·실천(workplace-based learning and practice), (4) 학습자 평가·피드백·자격인증, (5) 프로그램 평가·연구에서 현재 및 잠재적으로 AI를 활용하는 ‘모범적’ 사례를 확인했다. 이러한 활용 사례 중 다수는 장애물을 줄이고 역량바탕 및 정밀 의학교육으로의 전환을 촉진할 수 있는 방식이다. 예를 들어 실제 환자 사례에 기반하면서 수련생의 학습 요구에 맞춘 가상 튜터링과 코칭, 학습자에게 효율적인 실시간 피드백을 제공하도록 강화된 표준화 환자 모형, 개인화된 피드백을 제공하고 학습 궤적을 예측하는 데 사용할 수 있는 자동 평가가 있다. Boscardin 박사는 “역량바탕 의학교육을 실제로 운영할 상당한 잠재력을 보고 있습니다. 역량바탕 의학교육은 20년 동안 존재해 왔지만, 특히 피드백과 데이터 관리, 실제적 평가(authentic assessment)에서 큰 장벽과 난관에 부딪혀 왔습니다. 새로운 AI 모형은 이러한 문제를 해결하는 데 도움을 줄 수 있습니다”라고 말했다.


연구자들은 유망한 AI 응용 분야를 확인하는 것 외에도 인터뷰 참가자들에게 해결해야 할 가장 큰 AI 관련 과제를 돌아보게 했다.


  • 많은 AI 도구가 ‘블랙박스(black boxes)’처럼 작동한다는 점에서 그 작동 방식의 투명성 부족에 대한 우려가 제기되었다.
  • AI가 환자 진료와 의학교육 과정의 편향뿐 아니라 교육기관 내부와 기관 간의 자원 불평등을 악화할 수 있다는 우려도 있었다.
  • 데이터 보안과 학습자·환자의 사생활,
  • 사용자가 AI 도구에 지나치게 의존할 가능성,
  • AI가 의학교육과 학습자·환자 성과에 미치는 영향을 평가해야 할 필요성에 대한 우려도 추가로 제기되었다.


Boscardin과 Gin은 의학교육에 AI를 도입하기 위한 우선순위를 제시하며 발표를 마쳤다. 여기에는 의학교육의 AI 역량 집합을 마련해야 할 ‘시급한’ 필요성이 포함되었다. 이들은 AI가 의사의 역할과 책임을 바꾸는 방식을 반영해 임상 역량을 조정하고, AI 사용의 윤리 기준을 개발하며, AI의 결과물과 영향을 지속해서 모니터링할 도구와 절차를 마련할 것도 촉구했다. 마지막으로 연구 협력과 재원 조달 기제를 포함하여 의학교육자와 기술 산업 간의 새로운 유형의 협력이 필요하다고 말했다.

합의 권고안의 토대 (Groundwork for consensus recommendations) 

발표가 끝난 뒤 참가자들은 의학교육 안의 서로 다른 영역에 초점을 맞춘 분과 그룹으로 나뉘었다. 교수와 학습자의 경험에 직접 적용되고 의학교육에서 기본적으로 중요한 네 중점 영역은


  • (1) 기초 교육과정,
  • (2) 경험 교육과정,
  • (3) 학습자 평가와 프로그램 평가,
  • (4) 코칭과 피드백이었다.


회의 첫날, 기획위원회 구성원들이 진행을 맡은 각 그룹에는 동일한 과제가 주어졌다. 회의 목적 진술문 초안(상자 1)에 의견을 제시하고, 오늘날의 의학 학습자가 앞으로 몇 년 동안 강의실과 임상 학습환경에서 AI를 어떻게 접할 가능성이 있는지에 관한 가상이지만 현실적인 비전을 담은 종단적 사례연구(longitudinal case study, http://links.lww.com/ACADMED/B719의 디지털 보충 부록 2 참조)를 토의하는 일이었다.


메이시 재단은 공동 작업을 시작할 때 참가자들에게 기획위원회가 작성한 통합적인 목적 진술문에 대한 의견을 요청하곤 한다. 참가자들이 회의와 관련된 개인적 관점, 동기, 우선순위를 공유하는 이 활동은 궁극적으로 회의와 권고안의 포괄적 목적 또는 비전을 다듬고 명확히 표현하는 역할을 한다. 이번 회의의 최종 목적 진술문은 상자 1에 제시되어 있다.


상자 1. 회의 목적 진술문 (Box 1. Conference Purpose Statement) 

인공지능은 강력하고 빠르게 진화하는 기술이다. 의학교육계는 역량바탕 의학교육을 최적화하고, 현재와 미래의 의사가 양질의 환자중심 진료를 제공하는 고성과 팀의 일원으로 일하도록 준비시키기 위해, 이 기술을 안전하고 형평성 있으며 효과적인 방식으로 활용해야 한다.


이 사례연구(디지털 보충 부록 2: http://links.lww.com/ACADMED/B719)는 한 가상의 학습자가 의과대학에서 일반외과 레지던트 수련으로 나아가는 과정을 따른다. 그 과정에서 학습자는 AI로 강화된 교육과정, 임상 경험, 평가, 코칭을 접한다. 회의 목적 진술문과 종단적 사례연구에 대한 그룹 토의에서는 AI 시대의 의학교육자가 직면한 다양한 과제가 확인되었으며, 여기에는 다음의 필요성이 포함되었다.


  • 모든 의학 학습자와 교육자에게 지금 필요한 데이터과학(data science) 및 AI 리터러시(literacy) 기술과 역량을 결정한다.
  • AI 혁신과 관계없이 바뀌어서는 안 되는 의학교육의 핵심 또는 기초 요소를 확인한다.
  • 전문직 간 임상 진료팀에 전문 데이터 과학자를 통합할 가능성을 탐색한다.


회의 첫날이 끝날 무렵 한 참가자는 이후 논의의 방향을 제시했다. “AI가 우리[의학교육계]에게 일방적으로 닥쳐오는 것이 아니라는 점을 기억해야 합니다. AI는 우리가 항상 해 온 일, 즉 가능한 최고의 도구, 지식, 기술, 연구를 활용해 의사를 교육할 기회를 제공합니다. [의학교육에] AI를 도입하는 것은 그 성과를 어떻게 쓸지 우리가 결정할 수 있는 기회입니다.”

권고안을 형성한 회의의 주제 (Conference Themes Inform Recommendations) 

회의의 전체 토론, 소그룹 토론, 비공식 대화에서 여러 주제가 반복적으로 나타났다. 아래에 간략히 설명하는 이 주제들은 이 보고서 마지막 부분에 제시된 다섯 가지 합의 권고안과 이에 따른 실행 단계(상자 2)에 반영되어 있다. 완전한 투명성을 위해 밝히면, 권고안을 포함한 이 보고서의 내용은 회의 참가자들이 메이시 재단 직원들의 지원을 받아 다음 자료를 활용하여 개발했다. 메이시 재단이 의뢰한 AI와 의학교육에 관한 연구보고서 및 기타 배경자료, 회의 중 참가자들이 작성한 메모, 모든 참가자의 허락을 받아 녹음한 회의 토론의 AI 생성 요약본이다.

주제: AI 도구 평가를 위한 교육·정책 틀과 역량 구축 (Theme: Develop educational and policy frameworks and capacity to assess AI tools) 


  • 대부분 AI 혁신가이자 초기 수용자인 회의 참가자들은 AI가 의학교육을 발전시킬 잠재력에 기대를 표하면서도 신중할 것을 촉구했다. 참가자들은 기관 내부와 여러 체계 전반에서 AI를 안전하고 효과적이며 윤리적으로 도입·사용하도록 하는 효과적인 거버넌스 전략의 필요성을 거듭 우선시했다. 한 참가자는 “모든 사람이 AI를 충분히 교육받아 자신에게 계속 더 많은 교육이 필요하다는 사실을 제대로 이해해야 합니다”라고 말했다.
  • 연구자들은 AI 사용을 위한 안전장치를 제안해 왔다. 예를 들어 Triola와 Rodman은 개별 기관이
    • (1) 기관과 환자의 데이터를 보호하고 학업 환경에서 AI의 적절한 사용에 대해 학생에게 명확한 지침을 제공하는 정책을 만들고,
    • (2) 안전하고 윤리적인 AI 사용을 정의하며 감독하고 기술 발전을 따라갈 지역 거버넌스 기구를 설치하며,
    • (3) 학습자 역량을 정의하고 책임 있는 AI 사용을 가르칠 흥미로운 교육과정을 개발할 것을 권고했다.24
    • 이들은 AI에 관한 기본 지식, 윤리와 규제, 임상 진료에서의 활용, 도구의 질과 정확성 평가, 데이터 사생활 보호와 보안, 전문직업성을 포함하는 AI 역량 틀도 제안한다.
  • 의료와 보건의료 전문직 교육에 관련된 중요한 AI 역량은 주어진 도구의 정확성과 유용성을 비판적으로 평가하는 능력이다. 이를 위해 Gin과 동료들은 한 가지 가능한 접근법으로, 지도자가 학습자에게 특정 환자 진료 활동을 맡겨도 될 준비가 되었는지 평가하도록 하는 의학교육의 위임(entrustment) 패러다임을 채택할 것을 제안했다.28 이 연구를 설명하면서 Gin은 “위임 모형은 어떤 과업을 AI가 잘 수행한다고 믿고 맡길 수 있고 어떤 과업은 그렇지 않은지 결정하는 데 도움을 줄 수 있습니다. 이는 개별 수련생에게 서로 다른 수준의 감독과 자율성을 부여하면서 환자 진료 업무를 맡기거나 맡기지 않는 것과 같습니다”라고 말했다.


주제: 형평성을 높이고 편향을 완화하며 학습자와 환자를 중심에 두기 (Theme: Advance equity, mitigate bias, and center learners and patients) 


  • AI의 개발과 사용에서 형평성을 증진하고 편향을 완화하며 학습자와 환자를 중심에 두어야 한다는 주제는 회의 전반에 걸쳐 나타났다.
    • 형평성에 관한 대화는 주로 학습자, 프로그램과 기관, 의학교육계 전반에서 AI 도구와 기술에 형평성 있게 접근할 수 있어야 한다는 필요성에 집중되었다. 장애가 있거나 영어에 능숙하지 않은 학습자·교육자, 기술 또는 AI 도구 사용에 익숙하지 않은 사람, 인터넷이나 개인용 컴퓨터 등 지원 기술에 접근할 수 없는 사람, 최첨단 AI 모형의 구독료를 감당할 수 없는 사람은 AI 도구에 접근하기가 더 어려울 수 있다.29
    • 마찬가지로 참가자들은 재정 및 기타 자원이 적은 기관이 의학교육, 환자 진료, 연구를 포함한 여러 사명 영역의 활동에서 AI 기술을 이용·도입·배포·감독하는 데 더 큰 어려움을 겪을 수 있음을 인식했다. 따라서 모든 의대생에게 제공해야 할 최소한의 학습 경험을 정하는 데 주의를 기울여야 한다.
  • 또한 AI 알고리즘과 도구는 유해한 편향, 차별, 불평등을 악화할 수 있다는 우려를 낳는다.30,31
    • AI 도구는 학습에 사용된 데이터셋이나 개발자가 학습 데이터를 구성하고 우선순위를 정한 방식 자체에 편향이 있거나, 그 도구의 대상 인구집단을 대표하지 못하는 경우 불평등을 지속시킬 수 있다.32,33
    • 불평등의 확산을 줄이려면 편향을 알아보도록 훈련된 전문가가 AI 도구를 검토해야 하며, 기관은 도구 도입 이후 지속적으로 모니터링하는 절차를 수립해야 한다.21
    • AI의 편향과 불평등이 초래하는 위험은 학술의료체계에서 강력한 AI 거버넌스를 마련하고, 최종 사용자와 의사결정자를 대상으로 탄탄한 AI 교육·훈련을 제공해야 할 필요성을 더욱 뒷받침한다.
  • 참가자들은 데이터 투명성의 필요성과, 의학교육에서 AI 강화 도구를 개발·사용하기 위한 계획에 교육자가 학습자와 환자의 관점을 반영해야 한다는 점도 논의했다. 학습자의 향후 수행을 예측하는 데 사용될 수도 있는 도구를 포함하여, AI 제품 개발을 위한 데이터의 이차적 사용에 동의하지 않았을 수 있는 학습자와 환자 모두에게 데이터가 어떻게 사용되는지에 관한 투명성은 필수적이다.34 역사적으로 소외된 공동체의 구성원이라고 정체화하는 학습자와 환자와 함께 AI 시행계획을 공동 생산(co-production)하면 편향을 완화하고 형평성을 증진하는 데 도움이 될 수 있다. 데이터 보안과 사생활 보호 노력에도 정보를 제공할 수 있다. 나아가 참가자들은 많은 의학 학습자가 이미 기술 활용 능력을 지닌 채 의학교육에 들어오며 기술로 더욱 강화된 교육 경험을 기대한다고 지적했다. 환자에게도 기술 활용 능력이 있고, 진단과 치료 선택지를 이해하고 전반적인 건강을 관리하는 데 AI 도구를 사용한다. 한 참가자는 환자들이 임상의와 상호작용할 때 기술 전문성의 정도가 매우 다양하므로, 의학 학습자도 AI 접근성이 없거나 낮은 환자부터 AI를 생활 속에 깊이 활용하는 환자까지 마찬가지로 다양한 가상 환자와 상호작용해야 한다고 제안했다.


주제: 새로운 임상의 역할과 관계를 받아들이고 교육하기 (Theme: Embrace and educate around new clinician roles and relationships) 


  • AI 기술의 진화와 의료 분야 도입은 의사의 새로운 역할을 만들고 의료 관계의 역학을 바꾸고 있다. 의학교육은 의사들이 이러한 변화에 대비하도록 해야 한다. 한 논문은 미래의 임상의를 AI 도구의 ‘소비자(consumers), 번역자(translators), 개발자(developers)’로 개념화하는 의학교육 과정을 제안한다.22
    • AI 소비자인 임상의는 “임상 환경에서 AI 도구를 효과적으로 선택하고 사용할 충분한 지식과 기술”이 필요하다.
    • 임상의-번역자는 AI의 소비자이면서 어느 정도 개발자 역할도 할 수 있다.
    • 개발자는 임상·과학 전문성에 더해 AI에 관해 더 깊은 지식과 기술을 갖춘 사람이다.
    • 이러한 노력은 기존의 임상정보학(clinical informatics) 교육과정과 훈련 프로그램을 토대로 삼을 수 있다.35
  • AI 도구와 기술의 도입은 의료 관계도 바꾸고 있으며, 팀워크와 협력 진료의 중요성을 더욱 높이고 환자들이 AI에 더 익숙해지면서 의료제공자–환자 관계도 변화시키고 있다. 한 참가자는 이렇게 요약했다.
    • “지금까지 의학교육에서 우리는 AI를 인지적 활동으로 생각하는 경향이 있었고, 그것이 임상 추론을 어떻게 발전시킬 수 있는지에 초점을 맞췄습니다. 하지만 임상의와 환자 사이, 진료팀 내부와 팀 간의 대인관계 상호작용과 관계의 역학도 중요합니다. 저는 AI가 환자 진료에 대해 더 인간중심적이고 포괄적인 팀 접근을 위한 여지를 만들 것이라고 생각합니다.”
    • 이 참가자는 임상의가 AI를 진료팀의 또 다른 구성원으로 생각하기 시작할 것을 권했다.
  • AI 기반 도구가 의학에서 보편화되어 임상의의 승인을 기다리는 권고, 예측, 문서 초안을 제공하게 됨에 따라, 효과적인 ‘인간 참여형(human-in-the-loop)’ 감독에 필요한 역량을 면밀히 검토해야 한다.36
    • 가까운 미래에도 AI의 결과물은 불완전할 것이므로, 임상의가 안주하거나 자동화 편향(automation bias)에 빠지지 않으면서 핵심 술기를 유지하도록 준비시키는 것은 양질의 AI 활용 진료를 제공하는 데 필수적이 될 것이다.37
    • 참가자들은 임상의가 핵심 생물과학에 관한 기초 지식과 이를 임상 추론에 적용하는 능력을 유지하는 것이 특히 중요하다고 논의했다.
  • 참가자들은 AI가 임상의의 역할과 관계를 바꾸는 데 그치지 않고 일부 의료제공자 집단을 아예 대체할 수도 있다는 우려를 인정했다. 이러한 우려는 AI가 인간보다 뛰어난 진단 정확도와 치료 계획 능력을 보일 수 있다는 새롭게 등장하는 근거에 바탕을 둔다.38 논의는 AI를 임상의의 지식·기술·전문성을 보완하고 강화하는 도구로 규정하는 방향으로 자주 돌아왔다.
    • Sezgin이 설명했듯이 인간과 AI의 협력은 “보건의료 제공자의 인지적 강점과 AI의 분석 능력을 결합”하고, “인간의 전문성이 AI 체계를 이끌고 이에 관해 소통하며 감독하도록 하여 의료서비스의 안전과 질을 유지”한다.38


주제: 협력·파트너십과 탄탄한 AI 연구 의제 개발 (Theme: Develop collaborations, partnerships, and a robust AI research agenda) 


  • 참가자들은 기관과 조직 사이의 새로운 관계가 필요하다는 점도 인식했다. MUSC의 Cawley 박사는 학술의료센터와 의료체계가 독립적으로 운영되어 온 전통을 강조했다. 이들은 내부의 복잡한 부서 장벽을 넘어서는 협력에도, 다른 의료센터나 의료체계와의 외부 협력에도 익숙하지 않다. 그러나 생성형 AI 도입은 시간이 중요한 동시에 자원이 많이 드는 과제이며, 상당한 재정 투자와 폭넓은 기술 전문성이 필요하다. 의학교육계 내부와 기관 간의 파트너십 및 기술 기업과의 협력은 비용을 분담하고 효율성을 높이며 더 폭넓은 전문성과 다양한 접근법을 활용하여 더 견고한 기술 도구를 만드는 데 도움이 될 수 있다.
  • 참가자들에 따르면 협력과 파트너십은 데이터의 민주화, 모범 실무·교육과정·역량의 개발과 보급, AI 도구의 개발·시험·평가 등 여러 방식으로 AI 도입을 촉진할 수 있다. 참가자들 가운데 일부는 의학교육자를 위한 AI 연구 지침39의 개발에 참여했으며, 파트너십을 통해 추진할 수 있는 시급한 우선순위로 탄탄한 연구 의제의 개발과 지원을 꼽았다. Ng 등은 “AI 연구는 보고가 미흡한 경우가 많고, 많은 검증 연구의 방법론에 결함이 있으며, 마케팅은 환자에 대한 AI 응용의 근거로 입증된 이익을 과장하는 경우가 많다”고 지적했다.22
  • 회의 발표에서 Boscardin과 Gin도 비슷한 우려를 표했다. Boscardin 박사는 “AI 도구를 검증하고, 가장 적합한 활용 사례를 설명하며, 위험과 한계를 상세히 밝히는 연구가 훨씬 더 많이 필요합니다”라고 말했다. 여러 참가자는 전통적인 학술연구와 출판에 필요한 시간에 대한 우려를 표했다. 한 참가자는 “매우 비싼 연구에 대한 지원을 받고, 연구를 수행하고, 출판할 즈음에는 연구 대상 기술이 이미 구식이 되어 있습니다”라고 말했다. 이러한 문제는 연구 기준과 지침을 개발하고, 시의적절한 결과를 지원·생산·공유할 방법을 찾는 공동 노력을 통해 해결할 수 있다.
  • 모든 참가자는 AI라는 ‘요정’이 이미 병 밖으로 나왔고, 의학교육과 임상 진료에서 AI의 존재가 확실하다는 데 동의했다. 이제 과제는 우리가 사물을 보고 일을 하는 새로운 방식에 대해 상상하고 적응하는 능력만큼 변혁의 가능성이 커지는 기술의 힘을 활용하는 것이다. 하버드의 Chang 학장이 설명했듯이 “아마 수십 년에 한 번쯤은 의대생을 가르치는 방식과 그들이 의사가 되었을 때 기대하는 능력에 진정한 혁명이 일어납니다. 지금이 바로 그런 시기입니다.”6 다음 권고안은 의학교육자들이 생성형 AI와 미래의 AI 혁신을 도입하면서 보건의료 전문직 교육과 의료를 계속 발전시키고 개선하도록 돕기 위한 것이다.


권고안 (Recommendations) 

다음 합의 권고안은 AI와 의학교육에 관련된 주요 당사자들의 노력을 이끌기 위한 것으로, 대상에는 다음이 포함된다.


  • 의학교육 학장, 프로그램 지도자, 교육과정 책임자, 교수자, 관련 인력.
  • 학부·대학원·계속 의학교육 전 단계의 학습자.
  • 환자와 환자 옹호자.
  • 의과대학, 교육병원, 학술의료체계 및 학술의료센터의 이사회 위원, 임원, 관리자, 기타 지도자.
  • 관련 인증·면허·자격인증 기관의 대표자.
  • 의사, 전문과목, 의과대학, 레지던트 프로그램의 활동을 지원하고 발전시키는 협회와 조직의 대표자.
  • 간호 및 다른 보건의료 전문직의 지도자, 교육자, 학습자.
  • 정책 입안자와 정부 규제 담당자.
  • 교육 중심 AI 기술 기업.


상자 2. 권고안과 실행 단계 (Box 2. Recommendations and Action Steps)

1. 의학교육에서 안전하고 효과적인 AI의 도입을 촉진한다.


  • 1.1 AI 교육과정과 역량을 시행한다.
  • 1.2 AI 시대에 맞추어 의사의 기초 역량을 재평가한다.
  • 1.3 인증·면허·자격인증의 기준과 절차를 수정한다.
  • 1.4 학습을 촉진하기 위한 교육자의 AI 사용을 지원한다.
  • 1.5 개인과 조직의 적응력을 촉진한다.
  • 1.6 파트너십과 협력을 구축한다.


2. 의학교육에서 공동 생산한 AI 강화 교수·학습·학습자 평가·프로그램 평가 접근법을 시행한다.


  • 2.1 AI 실험 공간을 개발한다.
  • 2.2 기존 교수 전략을 개선하는 데 AI를 사용한다.
  • 2.3 AI 시대에 맞추어 평가 프로그램을 조정한다.


3. 의학교육에서 AI 도입을 촉진할 탄탄한 데이터 생태계를 개발하고 활용한다.


  • 3.1 데이터 체계를 통합한다.
  • 3.2 학습자 평가에 데이터 투명성을 내재화한다.
  • 3.3 역량바탕 및 정밀 의학교육을 수용한다.
  • 3.4 인증에서 데이터 기반의 탁월성을 촉진한다.


4. 의학교육에서 윤리적 AI 거버넌스 틀과 AI 도구·기술의 책임 있는 활용을 촉진한다.


  • 4.1 포괄적인 AI 틀과 윤리 지침을 마련한다.
  • 4.2 전국적 모범 실무 네트워크를 구축한다.


5. 의학교육의 AI에 관한 학술활동을 발전시킨다.


  • 5.1 의학교육의 AI를 연구한다.
  • 5.2 참여형 연구를 수행한다.
  • 5.3 도전적인 학술활동에 자금을 지원한다.
  • 5.4 보고 기준을 사용한다.
  • 5.5 연구 성과의 보급을 강화한다.
  • 5.6 학제 간 협력을 지원하고 산업계와의 파트너십을 모색한다.
  • 5.7 AI와 의학의 미래에 관한 전략적 비전을 구상한다.


권고안 1: 의학교육에서 안전하고 효과적인 AI의 도입 촉진 (Recommendation 1: Promote the implementation of safe and effective AI in medical education)

의학교육·훈련 프로그램을 후원하는 기관의 지도자는 교수, 학습, 학습자 평가, 환자 진료에서 안전하고 효과적인 AI 도구·기술의 도입을 촉진하도록 실질적인 지원과 자원을 제공해야 한다. 여기에는 의대생부터 대학원 수련생, 교수진, 진료 중인 의사에 이르는 학습자가 의료 분야에서 AI를 활용할 수 있도록 준비시키는 포괄적인 교육과정의 개발·시행이 포함된다.


  • 실행 단계 1.1: AI 교육과정과 역량 시행 (Action step 1.1: Implement AI curricula and competencies). 기관 지도자와 의학교육자는 현재와 미래 의사를 위한 AI 교육과정과 역량을 개발·시행해야 한다. 교육과정과 역량은 AI의 유형, 기능, 능력, 한계 등 기본 원리와 사회적 함의를 다루어야 한다. 또한 의사가 AI를 효과적으로 사용하는 데 필요한 기술, 즉 도구를 비판적으로 평가하고 환각 및 편향을 지속시킬 수 있는 능력과 같은 단점을 완화하는 방법도 가르쳐야 한다. AI 교육과정의 효과는 학습자와 환자의 성과를 측정하여 평가해야 하며, 그 결과를 교육 프로그램의 지속적인 향상에 반영해야 한다.
  • 실행 단계 1.2: AI 시대에 맞추어 의사의 기초 역량 재평가 (Action step 1.2: Reevaluate foundational physician competencies for the AI era). 주요 당사자들은 의료 분야에서 AI가 갖는 함의를 의사의 기초 역량 영역과 훈련이라는 관점에서 평가해야 한다. 여기에는 의학 지식, 비판적 사고와 임상 의사결정, 데이터 리터러시(data literacy), 팀워크, 지속적인 질 향상, 전문직업성, 의사소통 교육이 포함된다. 의사의 업무 중 어떤 요소를 AI에 맡길 수 있는지, AI가 활용되는 환경에서 수련생에게 더 이상 필수적이지 않을 수 있으므로 기존 교육과정의 어떤 요소를 제거해야 하는지 신중히 고려해야 한다. 교육과정에서 무엇을 제거할지 결정하려면 세심한 사고와 분석이 필요하며, 이용 가능한 최선의 근거와 기관 및 그 지역사회의 고유한 사명·상황에 근거해야 한다. 이때 AI 도구의 가용성과 효과가 다소 예측하기 어렵고 진료 환경마다 균일하지 않으며, 가까운 미래에도 진단과 치료처럼 중대한 AI 결과물을 감독하는 책임이 의사에게 있다는 점을 인정해야 한다.
  • 실행 단계 1.3: 인증·면허·자격인증 기준과 절차 수정 (Action step 1.3: Modify accreditation, licensing, and certification standards and processes). 의학교육 인증·면허·자격인증 기관의 지도자들은 면허 및 자격인증 과정에서 AI 역량을 평가하는 일을 포함하여, AI 역량을 의학교육과 의사 진료의 기준에 통합하는 방안을 고려해야 한다.
  • 실행 단계 1.4: 학습 촉진을 위한 교육자의 AI 사용 지원 (Action step 1.4: Support educators’ use of AI to promote learning). 기관 지도자들은 AI와 관련된 의료 역량, 도구, 방법론을 통합하도록 교육과정과 평가체계를 재설계하는 교육자를 적극적으로 지원하기 위해 자원을 배정하고 기반시설을 개발해야 한다. 구체적인 단계에는 다음이 포함되지만 이에 한정되지는 않는다.
    • AI의 기초 원칙과 의학교육에서 현재 및 잠재적인 활용에 관한 훈련을 포함하여, 교수·학습·학습자 평가·프로그램 평가에서 AI를 사용하는 교수개발을 제공하고 장려한다.
    • AI를 활용한 교수·학습(예: 가상 환자와 개별화 튜터링 시스템)을 지원하는 데 필요한 컴퓨팅 기반시설을 제공한다.
    • 교육과정에서 문서 초안 작성, 수작업 채점처럼 학습 효과가 낮고 반복적인 과업을 AI 도구에 안전하게 맡기도록 한다. 그러면 교육자는 학습자, 환자, 동료와의 인간적 상호작용에 더 집중할 수 있다.
    • 연구·재정 지원 등을 제공하여 AI 활용 의학교육의 혁신과 학술활동에 교수진이 기여하도록 장려한다.
  • 실행 단계 1.5: 개인과 조직의 적응력 촉진 (Action step 1.5: Facilitate personal and organizational adaptability). 주요 당사자들은 AI와 관련된 기술 발전과 정책 변화에 신속하게 대응할 수 있도록 의학교육·훈련 프로그램의 적응력과 민첩성을 높여야 한다. 조직 차원에서 이를 실현할 한 가지 방법은 AI 발전에 대응하고 이를 반영하여 역량과 교육과정을 갱신하기 위해 정기적으로 회의하는 AI 교육과정 검토위원회를 설치하는 것이다.
  • 실행 단계 1.6: 파트너십과 협력 구축 (Action step 1.6: Create partnerships and collaborations). 지도자들은 의학교육에서 AI의 도입을 강화·확대하기 위해 기관 내부와 외부의 전문가들과 전략적 파트너십 및 기타 협력 관계를 구축해야 한다. 예를 들어 필요에 따라 기술 전문가를 채용할 자원을 갖추고, 학부·대학원 의학교육 및 다른 보건의료 전문직 교육 프로그램을 아우르는 교육 디지털 혁신실(Office of Educational Digital Innovation)을 설립해야 할 수도 있다. 의학교육에서 AI 도입을 지역·국가·국제 수준으로 확대할 수 있도록 허브·스포크(hub-and-spoke) 방식의 협력에 참여하는 방안도 포함될 수 있다.


권고안 2: 의학교육에서 공동 생산한 AI 강화 교수·학습·학습자 평가·프로그램 평가 접근법 시행 (Recommendation 2: Implement coproduced, AI-enhanced teaching, learning, assessment, and evaluation approaches in medical education)

AI를 통한 학습을 장려하기 위해 의학교육자는 학습자, 교수진, 전문직 간 팀원, 환자와 함께 AI 활용 교육 실험 공간, 거꾸로 학습(flipped classrooms), 형성적 자기평가 도구(formative self-assessment tools), 가상 환자 시뮬레이션 등을 공동 생산해야 한다. AI 자체의 전문가도 참여해야 하는 이 공동 생산 모형은 학습자와 교수진이 데이터과학과 AI에 대한 이해를 깊게 하면서 AI 기술을 적극적으로 탐색하고 실험하며 그 발전에 영향을 미치게 할 것이다.


  • 실행 단계 2.1: AI 실험 공간 개발 (Action step 2.1: Develop AI playgrounds). 기관 지도자와 의학교육자는 기술 전문가와 협력하여 학습자와 교수진이 실제 운영 버전에 필요한 제약 없이 특정 과업에 AI 도구를 탐색·실험·적용할 수 있는 안전한 공간인 ‘AI 실험 공간(AI playgrounds)’을 만들어야 한다.
  • 실행 단계 2.2: 기존 교수 전략 개선에 AI 사용 (Action step 2.2: Use AI to improve existing instructional strategies). 의학교육자는 다음을 수행해야 한다.
    • AI 도구를 활용해 학습 경험의 상호작용성을 높이는 거꾸로 학습과 같은 AI 활용 교육 모형을 시행한다.
    • 표준화되고 통제된 학습환경에서 핵심 술기를 연습할 기회를 확장하기 위해 AI 강화 가상 환자 시뮬레이션을 시행한다.
    • 피드백 도구를 개선한다. 교육자는 기술·평가 전문가와 협력하여 모든 수준의 학습자에게 즉각적인 피드백을 제공하는 AI 강화 형성평가, 자기평가 및 기타 피드백 도구를 사용해야 한다. 이는 정밀교육에 부합하는 방식으로 학습 성과와 교육 효과를 높인다.
  • 실행 단계 2.3: AI 시대에 맞추어 평가 프로그램 조정 (Action step 2.3: Adapt assessment programs to the AI era). 의학교육자는 다음을 수행해야 한다.
    • AI 도구가 임상 진료 전반에 스며들 것이므로 평가 환경에도 스며들어야 한다는 사실을 인정한다.
    • 환자 진료에서 빠르게 진화하는 AI의 역할과 관련하여 학습자(및 교수진)에게 새롭게 요구되는 중요한 수행 기대치를 확인한다.
    • 현재의 평가 전략을 조사하여 효과를 평가하고, AI 시대의 수행 기대치에 맞추며, 개선할 부분을 파악한다. 더 이상 적절하지 않은 영역과 도구는 버린다.
    • 의사소통 술기, 체계 기반 진료(systems-based practice), 전문직업성처럼 전통적으로 측정하기 어려웠던 역량을 평가할 수 있도록 AI 도구와 기술의 사용을 고려한다.


권고안 3: 의학교육에서 AI 도입을 촉진할 탄탄한 데이터 생태계의 개발과 활용 (Recommendation 3: Develop and leverage robust data ecosystems to facilitate AI implementation in medical education)

의학교육기관의 지도자들은 표준화된 체계(schema)와 공유된 어휘를 사용하여 교육 데이터와 임상 데이터를 결합하는 포괄적인 데이터 생태계(data ecosystem) 구축에 투자해야 한다. 이러한 데이터 생태계에는 정보기술 전문가, 데이터 과학자, 교육자, 관리자, 질 향상 전문가를 포함한 학술의료센터 전반의 여러 주요 당사자의 의견과 협력이 필요하다. 체계가 구축되면 정밀교육, 체계 기반 교육의 개선, 평가 등 다양한 교육적 활용을 촉진해야 한다.


  • 실행 단계 3.1: 데이터 체계 통합 (Action step 3.1: Integrate data systems). 의학교육 및 의료체계 지도자와 다른 주요 당사자는 임상 데이터 체계와 교육 데이터 체계의 통합을 촉진하기 위해 협력해야 한다. 양방향 데이터 통합은 임상 진료가 의학교육에 정보를 제공하고, 교육 실천이 임상 성과에 미치는 영향을 측정할 수 있게 한다. 시행팀에는 교육정보학자(educational informaticians), 연구자, 프로그래머 등을 포함하여 다학제로 구성하고 AI의 안전하고 효과적이며 윤리적인 사용을 지원해야 한다.
  • 실행 단계 3.2: 학습자 평가에 데이터 투명성 내재화 (Action step 3.2: Build data transparency into assessment). 기관 지도자와 교육자는 평가 자료가 어떻게 수집되고 사용되는지에 관한 투명성을 높여야 한다. 이를 위해 다음을 수행해야 한다.
    • 형성평가 자료를 공동 생산하고 투명하게 사용하며, 실행 가능한 경우 학습자에게 자료의 소유권을 부여함으로써 학습자의 역량을 강화하고 안전과 신뢰를 우선시한다.
    • 평가 자료에서 의도하지 않은 결과와 AI가 유발한 편향을 모니터링하면서 학습자 성과를 지속적으로 평가하고, 문제가 발견되면 대응한다.
    • 데이터 분석에서 얻은 통찰이 의미 있는 프로그램 차원의 행동으로 이어지도록 시행과학(implementation science)의 원칙을 적용한다.
  • 실행 단계 3.3: 역량바탕 및 정밀 의학교육 수용 (Action step 3.3: Embrace competency-based and precision medical education). 지도자와 교육자는 다음을 수행해야 한다.
    • 역량바탕 의학교육에 따라 필요한 교수진의 학습자 상호작용·관찰 확대와 함께 AI 생성 평가를 사용한다.
    • 임상 환경에서 사용할 AI 활용 역량 평가 도구를 설계·시행한다.
    • 역량바탕 교육과 정밀교육의 실천·원칙에 맞추어, AI와 교수진이 확인한 학습자별 역량 공백에 맞춤형 학습계획으로 대응하고 AI 도구를 이용해 각 학습자에게 교육 콘텐츠를 맞춘다.
  • 실행 단계 3.4: 인증에서 데이터 기반의 탁월성 촉진 (Action step 3.4: Promote data-driven excellence in accreditation). 의학교육 인증기관의 지도자는 다음을 수행해야 한다.
    • 진료 중인 의사와 수련 중인 의사를 위해 데이터 기반, 역량바탕, 개인맞춤형 교육 경로를 촉진하고 학습자·교수진·기관이 사용할 AI 관련 자원의 적절성을 보장하도록 인증 기준을 검토·개정·조정한다.
    • 인증 심사의 절차, 보고서, 결정에서 AI를 사용하는 방식에 관해 투명하게 공개한다.


권고안 4: 의학교육에서 윤리적 AI 거버넌스 틀과 AI 도구·기술의 책임 있는 활용 촉진 (Recommendation 4: Facilitate ethical AI governance frameworks and responsible utilization of AI tools and technologies in medical education)

의학교육에서 AI 도구와 기술을 책임 있게 활용하도록 기관·교육·조직의 지도자와 재원 지원자는 윤리적이고 형평성 있는 AI 거버넌스 틀의 개발과 시행을 우선시해야 한다. 또한 미국의사협회(American Medical Association), 미국의과대학협회(Association of American Medical Colleges), 미국정골의과대학협회(American Association of Colleges of Osteopathic Medicine), 전공의교육인증위원회(Accreditation Council for Graduate Medical Education), 미국의학전문과목위원회(American Board of Medical Specialties) 등을 포함한 의학교육기관들은 의학교육과 임상 진료에 AI를 신중하게 도입하는 데 공동의 강한 이해관계를 갖고 있다. 이들 기관의 지도자들은 의학교육에서 AI를 공정하고 형평성 있게 도입하고 체계적으로 활용하도록 협력해야 하며, 의학교육의 AI에 관한 연구를 후원·촉진·공유해야 한다.


  • 실행 단계 4.1: 포괄적인 AI 틀과 윤리 지침 마련 (Action step 4.1: Create comprehensive AI frameworks and ethical guidelines). 이러한 틀과 지침은 AI 도구와 결과물의 사용·평가를 관리해야 하며, 데이터 보호와 AI가 환자 진료·교육·사생활에 미치는 함의에 초점을 맞추어 책임 있는 AI 도입을 보장해야 한다. 추가 활동에는 다음이 포함되어야 한다.
    • 교육기관, 의료체계, 산업계 간의 협력을 강화하고 종단적 데이터를 활용하여 개인의 평생학습 참여와 지원을 촉진함으로써 AI 강화 평가가 실제 임상 진료 양상에 부합하도록 한다.
    • AI에 특화된 틀과 지침은 HIPAA와 FERPA 같은 규제가 관장하는 환자 또는 학습자 데이터의 공유·사생활 보호에 관한 기존 작업을 토대로 하고 그와 연계되어야 한다. 의료·교육 데이터 생태계를 설계하거나 수정하여 학습자의 경험에 영향을 주는 경우, 교육자는 핵심 당사자로 참여해야 한다.
    • AI 강화 도구가 생성한 평가 자료에서 편향과 의도하지 않은 결과를 엄격하게 모니터링한다. 필요한 경우 형평성과 공정성을 뒷받침하도록 시정 조치를 취해야 한다.
  • 실행 단계 4.2: 전국적 모범 실무 네트워크 구축 (Action step 4.2: Build a national best practices network). 전국적인 의료 및 의학교육 기관의 지도자들은 적절한 이해관계자 대표성을 갖춘 협력 네트워크를 구성하여 모범 실무의 시행을 지원하고 다음 활동을 촉진해야 한다.
    • AI 관련 자료를 위한 중앙 저장소를 개발·유지·공유하여, 모든 의학교육자와 학습자가 검증된 양질의 교육자료에 무료로 형평성 있게 접근하도록 보장한다.
    • AI 활용 교육과정 개발, 교수진 훈련, 윤리적 고려사항, 평가 방법 등 특정 영역에서 협력할 전문 실무그룹을 만든다. 그룹 구성원은 협력과 지식 교류를 촉진하기 위해 회의·워크숍·학술대회 등의 행사도 계획하고 참여해야 한다. 임상정보학 훈련 프로그램과 네트워크는 중요한 파트너가 될 수 있다.
    • 네트워크 사업을 지원하고 장기적인 지속가능성을 보장할 재원을 확보하고 자원을 배정한다.
    • 엄격한 데이터 및 윤리 기준에 따라 도구의 개발·도입·평가를 발전시키기 위해 산업계와 파트너십을 구축한다.


권고안 5: 의학교육의 AI에 관한 학술활동 발전 (Recommendation 5: Advance scholarship on AI in medical education)

의학교육 지도자, 교수진, 모든 주요 당사자는 의학교육 및 더 넓은 보건의료 전문직 교육 전반에서 AI를 탐색·검증·도입하기 위한 포괄적인 연구 의제와 기타 학술활동을 수립하고 재원을 지원해야 한다. 이 의제는 의학교육과 보건의료 전문직 교육의 AI 교수 도구를 개발하고 엄격하게 평가하는 데 초점을 맞추어야 한다. 또한 미래 의사가 ‘과정에 참여하는 인간(human in the loop)’이 되도록 준비시키는 것과 같은 AI 역량을 어떻게 가르칠지도 검토해야 한다.


  • 실행 단계 5.1: 의학교육의 AI 연구 (Action step 5.1: Study AI in medical education). 연구자와 의학교육자는 AI 기반 교육 중재를 현재의 표준이나 관행과 비교하는 엄격한 실험연구 또는 관찰연구를 수행하여 그 효과와 영향을 연구해야 한다. AI 활용 임상체계가 교육에 미치는 영향에 관한 연구도 연구 의제에 포함되어야 한다. 이러한 연구는 편향과 불평등의 지속을 포함해 의도한 결과와 의도하지 않은 결과를 평가해야 하며, 연구 의제를 가속하도록 프로그램과 조직 간 데이터 공유를 뒷받침해야 한다.
  • 실행 단계 5.2: 참여형 연구 수행 (Action step 5.2: Conduct participatory research). 공동 생산이라는 개념을 강화하면서 연구자와 의학교육자는 학습자, 교육자, 환자, 관리자의 다양한 통찰을 수집해야 한다. 이를 통해 의학교육에서 AI에 대한 이들의 수용과 사용에 영향을 미치는 요인을 이해하고, 모든 주요 당사자의 AI 도입을 촉진하거나 저해하는 요인에 대응할 방법을 찾아야 한다.
  • 실행 단계 5.3: 도전적인 학술활동 지원 (Action step 5.3: Fund ambitious scholarship). 의학교육 연구비는 AI를 사용하여 교수, 경험학습(experiential learning), 학습자 평가, 프로그램 평가, 교육 학술활동, 교육행정 절차를 개선할 잠재력이 있는 연구와 실증 사업을 포함해 혁신적이고 영향력이 큰 학술활동에 중점을 두어야 한다.
  • 실행 단계 5.4: 보고 기준 사용 (Action step 5.4: Use reporting standards). 교육 지도자, 교수진, 주요 당사자는 충분한 엄밀성을 보장하고 보건의료 전문직 공동체의 신뢰를 높이기 위해, AI 관련 교육연구를 투명하게 보고하는 방법에 관한 합의 권고안을 개발해야 한다.
  • 실행 단계 5.5: 보급 강화 (Action step 5.5: Enhance dissemination). 교육 지도자, 교수진, 주요 당사자는 학술 성과물과 연구 결과에 재원을 지원하고 이를 보건의료 전문직 교육계에 보급하는 더 효율적이고 효과적이며 시의적절한 방법을 개발해야 한다.
  • 실행 단계 5.6: 학제 간 협력 지원과 산업계 파트너십 모색 (Action step 5.6: Support interdisciplinary collaboration and seek industry partnerships). 재원 지원자는 학술활동의 영향을 최대화하기 위해 다양한 보건의료 전문직의 학자와 데이터 과학자 및 정보학자를 포함한 학제 간 협력을 지원해야 한다. 또한 폭넓게 일반화하고 확장할 수 있는 사업을 지원하고, 이러한 협력을 뒷받침하는 과정에서 AI 기술 기업과 파트너가 되어야 한다.
  • 실행 단계 5.7: AI와 의학의 미래에 관한 전략적 비전 구상 (Action step 5.7: Engage in strategic visioning around AI and medicine). AI는 이미 의학과 의학교육을 변화시키고 있다. 의학교육 지도자들은 선견지명이 있는 사람들을 모아 AI가 주도하는 세계에서 의사와 다른 임상의가 맡게 될 미래의 역할을 파악해야 한다. 이러한 미래상을 널리 알리면 교육자들이 오늘의 학습자를 내일의 진료에 대비시킬 수 있다.


결론 (Conclusion) 

AI의 폭발적인 성장과 이에 대한 관심은 의료 실천과 의사 교육에 심대한 결과를 가져올 것이며, 오늘날 온전히 예측하기 어려운 방식으로 미래 의사의 역할을 거의 확실히 변화시킬 것이다. 이 보고서는 다가오는 변화에 대비하기 위해 지금 시행해야 하는 중요한 변화를 강조하고자 한다. AI가 빠르게 진화하는 만큼, 의도한 결과와 의도하지 않은 결과를 모두 엄격하게 측정하고 적응하는 접근법이 필수적이다. 이를 통해 놀라운 새 도구를 활용하면서도 최첨단 기술로 인간의 건강을 증진하는 의사를 교육한다는 우리의 변함없는 목표를 지킬 수 있다.

Holly J. Humphrey를 기리며 (Remembering Holly J. Humphrey)

  • 의학교육 분야에서 전국적으로 저명한 지도자이자 혁신가이며 조시아 메이시 주니어 재단의 회장이었던 Holly J. Humphrey, MD, MACP가 2025년 4월 17일 별세했다. Humphrey 박사는 1983년에 졸업한 시카고대학교 프리츠커 의과대학(University of Chicago Pritzker School of Medicine)에서 오랜 학술의학 경력을 쌓은 뒤 2018년에 재단을 이끌기 시작했다. 시카고대학교와 함께한 40년 동안 수석 전공의, 레지던트 프로그램 책임자, 의학 분야 Ralph W. Gerard 교수, 의학교육 학장을 지냈다. 1989년 Humphrey 박사와 시카고대학교의 한 동료는 졸업을 앞둔 의대생을 위한 미국 최초의 백의식(White Coat Ceremony)을 이끌었다. 경력 동안 셀 수 없이 많은 상과 찬사를 받았지만, 의대생들이 선정하는 ‘가장 좋아하는 교수’ 교육상을 25차례 받은 것을 가장 자랑스럽게 생각한다고 자주 말했다. 그는 미국국립의학한림원(National Academy of Medicine) 회원이기도 했으며, 카이저 퍼머넌트 버나드 J. 타이슨 의과대학(Kaiser Permanente Bernard J. Tyson School of Medicine), 학부 모교인 노스센트럴 칼리지(North Central College), 미국내과전문의위원회(American Board of Internal Medicine), 알파 오메가 알파 의학명예협회(Alpha Omega Alpha Medical Honor Society)의 이사회 의장 등 여러 전국적 지도자 직책을 맡았다. 전문성, 진실성, 연민, 관대함, 학습자의 교육 경험을 개선하려는 흔들림 없는 헌신으로 널리 인정받은 Humphrey 박사의 유산은 그가 경력에 영감을 준 수많은 뛰어난 의사 지도자를 통해 이어질 것이다. 의학교육에 대한 Humphrey 박사의 기여에 관한 자세한 내용은 메이시 재단 웹사이트의 「Holly J. Humphrey를 기리며」(Remembering Holly J. Humphrey, https://macyfoundation.org/news-and-commentary/remembering-holly-j-humphrey-md-macp)를 참조하기 바란다.

https://engage.aamc.org/UME-Competencies-AAMC-ACGME-AACOM

Foundational Competencies for Undergraduate Medical Education 


🩺 미국 의과대학의 "공통 졸업역량"이 나왔습니다: AAMC·AACOM·ACGME의 『Foundational Competencies for UME』 읽기

📄 AAMC, AACOM, ACGME. Foundational Competencies for Undergraduate Medical Education. 2024. (CC BY-NC 오픈 액세스)


  • 안녕하세요! 오늘은 2024년 말 미국에서 나온 보고서 하나를 소개할게요. 미국의과대학협회(AAMC), 미국정골의과대학협회(AACOM), 졸업후의학교육인증위원회(ACGME), 이 세 기관이 함께 만든 기본의학교육 기초역량(Foundational Competencies for Undergraduate Medical Education) 이에요.
  • 한 줄로 줄이면 이래요. "미국의 모든 의대생이 졸업할 때 갖춰야 할 공통 역량을 처음으로 합의해서 만들었다." 전공의 교육에서는 25년 넘게 써 온 6개 핵심역량(Core Competencies)을 이제 의과대학 단계에도 발달 단계에 맞는 언어로 옮겨 온 거죠. 하나씩 볼게요.


📌 1. 한눈에 보는 구조: 6개 역량, 45개 세부역량, 그리고 DO용 4개

프레임워크 구성은 간단해요.

  • 6개 역량(competencies):
    • 전문직업성(Professionalism),
    • 환자진료와 술기(Patient Care and Procedural Skills),
    • 의학지식(Medical Knowledge),
    • 진료기반 학습과 개선(Practice-Based Learning and Improvement),
    • 대인관계와 의사소통 기술(Interpersonal and Communication Skills),
    • 시스템기반 진료(Systems-Based Practice)
  • 45개 세부역량(subcompetencies): 모든 의대생 대상
  • 4개 추가 세부역량: 정골의학(DO, Doctor of Osteopathic Medicine) 학생만 해당

ACGME의 6개 핵심역량을 아시는 분이라면 틀이 익숙하실 거예요. 맞아요, 같은 틀이에요. 그런데 문장이 "의대생 수준"에 맞게 다시 쓰였다는 게 핵심이에요. 뒤에서 다시 볼게요.

먼저 이 보고서가 말하는 "역량(competency)"이 뭔지부터 짚고 갈게요. Frank 등(2010)의 정의를 가져와요.

역량이란 "보건의료인이 지식, 기술, 태도 같은 여러 요소를 통합해 보여 주는, 관찰 가능한 능력"이다.
"observable abilities of a health professional, integrating multiple components, such as knowledge, skills, and attitudes."

관찰 가능(observable) 하다는 게 포인트예요. 관찰할 수 있어야 평가할 수 있으니까요.


🧭 2. 왜 이제야? CBME 30년의 흐름

보고서는 역량바탕의학교육(CBME, Competency-Based Medical Education)의 역사를 짧게 정리해요. 연표로 보면 이렇게 돼요.

연도 사건
1996 캐나다 왕립의사회 CanMEDS 발표 / AAMC 의과대학 목표 프로젝트(MSOP, Medical School Objectives Project) 시작
1999 ACGME·ABMS 6개 핵심역량(Core Competencies) 발표
2001 ACGME Outcome Project 시작
2012 ACGME 차세대 인증체계(NAS, Next Accreditation System) 와 마일스톤(Milestones) 도입 / AACOM 정골의대생 핵심역량 발표
2013 AAMC 의사역량 참조세트(PCRS, Physician Competency Reference Set), 8개 역량
2014 AAMC 핵심 EPA 13개(Core EPAs for Entering Residency) / Physician Accountability 연합이 6개 핵심역량 공식 지지

그러니까 2014년에 이미 의학교육 전 과정(continuum)의 주요 기관들이 "6개 영역으로 가자"고 합의했던 거예요. 그런데 정작 의과대학 쪽에서는 공통 틀을 만들지 않은 채로 10년이 지나갔죠. 보고서도 이 점을 솔직하게 인정해요.

10년 전의 이러한 지지에도 불구하고, 의학교육계는 지금까지 기본의학교육(UME)을 위한 공통 역량 프레임워크를 함께 정의하지 않았다. 여기서 다루는 작업이 바로 그 일, 즉 미국 UME를 위한 공유된 역량 프레임워크를 만드는 일이다.
"Despite this endorsement a decade ago, the medical education community had not, until now, worked collaboratively to define a common competency framework for UME. The current work described here is to do just that: create a shared competency framework for UME in the United States."

🔗 직접적인 계기: UME-GME 전환 문제

직접적인 계기는 2021년 Physician Accountability 연합의 UME-GME 검토위원회(UGRC) 보고서, 그중에서도 권고 9번이에요.

UME와 GME 교육자는 교육 연속체 전반의 대표들과 함께, UME-GME 전환 과정의 학습자에게 적용할 공통 프레임워크와 성과(역량)를 공동으로 정의하고 실행해야 한다.
"UME and GME educators, along with representatives of the full educational continuum, should jointly define and implement a common framework and set of outcomes (competencies) to apply to learners across the UME-GME transition."


왜 공통 언어가 필요한지도 같은 보고서에 잘 나와 있어요. 저는 이 대목이 이 프레임워크의 존재 이유를 가장 잘 설명한다고 봐요.

역량에 대한 공유된 정신모형은 학습자의 진전을 평가하는 전략과, 평가에서 끌어낼 수 있는 추론에 대한 합의를 쉽게 해 준다. (...) 개별 학습자에게는 성과를 정의하는 것이 학습을 촉진하고 성장 마인드셋을 북돋울 수 있다. 교수에게는 수행 기대치에 맞춘 평가도구 사용과 교수개발을 가능하게 한다. 수련 프로그램에게는 전공의 선발, UME로부터의 학습자 인계, 전공의 수련, 진료 준비에 유용하다.
"A shared mental model of competence facilitates agreement on assessment strategies used to evaluate a learner's progress, and the inferences that can be drawn from assessments. (...) For individual learners, defining these outcomes will facilitate learning and may promote a growth mindset. For faculty, defining outcomes will allow for the use of assessment tools aligned with performance expectations and faculty development. For residency programs, defining outcomes will be useful for resident selection and learner handovers from UME, resident training, and resident preparation for practice."


공유된 정신모형(shared mental model), 이 키워드 기억해 두시면 좋아요.

📚 CBME는 전통적 교육과 뭐가 다를까?

보고서는 CBME와 전통적 접근을 네 가지로 대비해요.

  • 성과(outcomes) 중심 vs 과정(processes) 중심
  • 학습자 중심·환자 초점(learner-centered and patient-focused) vs 교수 주도(teacher-driven)
  • 시간에 걸친 다면적 형성평가(multifaceted, formative assessments) vs 드문 고부담 시험(infrequent, high-stakes tests)
  • 유연하고 시간에 얽매이지 않는 학습(flexible, time-independent learning) vs 모두에게 같은 표준 방식

더 깊이 알고 싶은 분께는 Van Melle 등(2019)의 CBME 5대 핵심 구성요소(five core components), 즉 성과 역량, 순차적 진급, 맞춤형 학습경험, 역량 중심 교수, 프로그램식 평가(programmatic assessment)를 함께 보라고 권해요.


🛠️ 3. 어떻게 만들었나: 3년, 3,000명 넘는 목소리

개발 과정이 꽤 공들인 편이라 따로 소개할 만해요. Batt 등(2021)의 보건의료 역량 프레임워크 개발 6단계 모형(six-step model) 을 따랐고, 약 3년이 걸렸어요.


👥 참여 구조

  • 공동리더(co-leads): 세 기관 대표
  • 자문위원회(AC, Advisory Committee): 16개 기관 24명
  • 작업그룹(WG, Working Group): 전국 공모로 뽑은 20명. 지역, 기관 규모와 미션, 전문과목, 학위 유형, 인종·민족·성별까지 고려해서 구성했어요.
  • 반응그룹(RG, Reactor Groups) 2개: 하나는 환자·보호자, 하나는 의대생

📅 진행 단계

  1. 협력적 기획 (2021.9~2022.7)
  2. 커뮤니티 논의와 현황 검토 (2022.8~2023.2): 1,000명 넘게 참여한 포럼
  3. 역량 개발 (2023.3~2024.6): 초안을 여러 차례 공개 의견수렴(1차 761건, 2차 1,189건 등 총 2,000건 이상)
  4. 최종 승인 (2024.9)과 확산

포럼에서 던진 핵심 질문은 이거였어요.

전공과 상관없이, 우리는 미래의 모든 의사가 무엇을 할 수 있고, 무엇을 알고, 무엇을 가치 있게 여기기를 기대하는가?
"What will we expect all future physicians to be able to do, know, and value, regardless of their future specialties?"


여기에 한 환자 옹호자(patient advocate)가 이렇게 답했어요. 인상 깊어서 옮겨 둘게요 💬

의사소통 없이 과학과 임상기술은 있을 수 없어요. (...) 번아웃도 많고 의사의 기쁨도 사라졌죠. 서로 소통하지 않는 사일로에서 일하는 것도 문제고요. 그러니까 의사소통이 팀워크와 진료 조정으로 이어지고, 서로 어려운 대화도 나눌 수 있어야 해요.
"You can't have science and clinical skills without communication. (...) There's so much burnout and lack of physician joy. It's also the struggles … working in silos that aren't communicating. So it's communication, leading to teamwork, care coordination, making sure that we can have difficult conversations with each other, pushing through that together and not being afraid of it."


작업 방식에서 눈에 띄는 점도 두 가지 있었어요.

  • 7개 지침 원칙(guiding principles) 을 먼저 정했어요. 첫 번째가 "속도보다 질(Choose quality over speed)"이고, 소수 전문가보다 관점의 다양성, 짧은 한 번의 의견수렴 대신 반복적 피드백을 통한 공동창조(cocreate), 그리고 CBME 작업이 관련된 사람들의 웰빙(well-being) 에 미칠 영향까지 고려하자는 원칙이 들어 있어요.
  • 공개 의견이 워낙 많다 보니 수작업 검토와 AI 기반 자동 텍스트 분석(artificial intelligence-automated text analyses) 을 함께 써서 주제를 분류했대요. 🤖

의견수렴 결과 가장 많이 고친 영역은 의학지식이었고, 의사소통, 건강시스템과학(health system science), 보건정책, 근거기반 진료, 환자중심 진료를 더 강조해 달라는 요구가 많았다고 해요.


📊 4. 6개 역량: GME 버전과 뭐가 다를까?

작업그룹이 처음 한 일은 1999년 GME용으로 만들고 2019년에 마지막으로 고친 역량 문장이 의대생에게도 맞는가 를 따지는 거였어요. 결론은 이래요.

두 역량 세트는 서로 정렬되어 있지만, UME 기초역량은 UME 학습자에게 발달적으로 적절한 언어를 반영한다.
"Although the two sets of competencies align, the Foundational Competencies for UME reflect developmentally appropriate language for the UME learner."

직접 비교해 볼게요.

역량 UME (의대생) GME (전공의)
전문직업성 (Professionalism) 모든 상호작용에서 진실성, 존중, 윤리적 추론을 보여 주고 차이의 포용(inclusion of differences) 을 증진해 환자·지역사회·인구집단의 의료를 개선한다 전문직업성에 대한 헌신과 윤리 원칙 준수를 보여 준다
환자진료와 술기 공감적이고, 효과적이며, 전인적(holistic), 근거정보기반(evidence-informed), 형평하고, 환자중심적인 진료를 보여 준다 환자·가족 중심의 진료를 제공하고, 해당 분야의 필수 술기를 모두 수행한다
의학지식 기초지식을 적용하고 통합해 환자와 인구집단의 의료를 개선한다 기존·신규 생의학, 임상, 역학, 사회행동과학 지식과 그 적용을 보여 준다
진료기반 학습과 개선 피드백, 근거, 성찰(reflection) 을 통합해 행동을 조정하고 개선을 촉진하며 평생학습을 기른다 자신의 진료를 조사·평가하고, 과학적 근거를 평가·흡수해 진료를 지속적으로 개선한다
대인관계와 의사소통 환자, 보호자, 의료팀과 효과적으로 소통하고 상호작용해 양질의 환자중심 진료에 기여한다 효과적인 정보 교환과 협업으로 이어지는 대인관계·의사소통 기술을 보여 준다
시스템기반 진료 사회적·구조적 결정요인을 포함한 더 넓은 건강의 맥락과 의료 안팎의 시스템·자원에 대한 지식을 적용한다 의료의 더 넓은 맥락과 시스템을 인식하고 대응하며, 다른 자원을 효과적으로 활용한다

차이가 보이시나요? 👀


  • GME는 "필수 술기를 모두 수행한다(Performs all ... procedures)", "진료를 조사·평가한다"처럼 독립적 실무자 기준으로 쓰여 있어요.
  • 반면 UME는 "적용하고 통합한다", "기여한다(contribute to)"처럼 아직 발달 중인 학습자 수준에 맞춰져 있어요. 또 포용, 전인성, 성찰, 구조적 결정요인처럼 최근 의학교육의 관심사가 UME 문장 쪽에 더 분명하게 들어가 있어요.


🔍 5. 45개 세부역량에서 눈여겨볼 항목들

세부역량 수는 역량별로 이렇게 나뉘어요. 괄호 안은 DO 전용 항목이에요.

  • 전문직업성 10개 (+1)
  • 환자진료와 술기 11개 (+2)
  • 의학지식 5개 (+1)
  • 진료기반 학습과 개선 5개
  • 대인관계와 의사소통 6개
  • 시스템기반 진료 8개

전부 소개하기보다, 제가 보기에 새롭거나 의미 있는 항목만 골라 볼게요 ✍️


🌱 자기 인식과 웰빙 (전문직업성)

  • 개인의 편향을 알아차리고 그 영향을 줄이는 전략을 찾는다 (Identifies personal biases and strategies to mitigate their effects.)
  • 전문가로서의 수행에 영향을 줄 수 있는 개인의 웰빙 요구를 인식하고 다룬다 (Recognizes and addresses personal well-being needs that may impact professional performance.)
  • 실수에 대한 책임을 지고 이를 바로잡기 위해 행동한다 (Takes ownership of mistakes and acts to address them.)

웰빙이 "개인 사정"이 아니라 전문직업성의 한 요소로 들어간 게 눈에 띄어요.


🤖 신기술 (의학지식, 시스템기반 진료)

  • 신기술을 포함한 적절한 자원을 활용해 임상 문제와 관련된 지식에 접근한다 (Accesses knowledge relevant to clinical problems using appropriate resources, including emerging technologies.)
  • 환자진료에서 현재 기술과 신기술을 쓸 때의 위험과 이익을 평가한다 (Evaluates the risks and benefits of using current and emerging technologies in patient care.)

"AI"라는 단어가 직접 나오지는 않아요. 그래도 신기술을 쓰는 능력과 따져 보는 능력을 모두 기본 역량에 넣었다는 점은 분명해요.


🔎 정보 판별 (의학지식)

  • 정보의 정확성과 임상 문제와의 관련성을 판별한다 (Discerns the accuracy of information and relevance to clinical problems.)

💬 피드백을 "주는" 능력 (대인관계와 의사소통)

  • 다른 사람에게 건설적으로 피드백을 구성하고 전달한다 (Formulates and shares feedback constructively with others.)

피드백을 구하고 반영하는 능력은 진료기반 학습과 개선에, 피드백을 주는 능력은 의사소통에 따로 배치했어요. 피드백을 양방향 역량으로 본 거죠.


🏥 형평과 정책 (시스템기반 진료)

  • 환자진료와 의료시스템에서 격차를 줄이고 건강형평(health equity)을 증진하는 기전을 인식한다
  • 보건정책과 의료의 재정적 맥락을 설명한다 (Describes health policy and the financial context of health care.)

🎯 6. 이걸로 뭘 할 수 있을까? 의도된 활용

보고서는 역할에 따라 활용 방식이 다르다고 해요. 예를 들어 교육과정 학장과 위원회는 현재의 교수·평가 활동에 역량을 매핑(mapping) 해서 강점과 빈틈을 찾을 수 있고, 교수 코치는 학생과 함께 학습계획을 짤 수 있어요. 그 밖에 이런 용도를 들어요.

  • 학생 자기평가와 개별 학습계획(individual learning plans)
  • 교육 경험이나 과목의 학습목표 개발
  • 프로그램식 평가(programmatic assessment) 의 빈틈 찾기
  • 평가방법 개발
  • 의학교육 연구와 학술활동

🔄 기존 프레임워크와의 관계

실무적으로 중요한 내용이 두 가지 있어요.

더 포괄적이고, 최신이며, 정렬된 프레임워크인 UME 기초역량은 2013년 AAMC PCRS를 대체할 것이다. EPA는 넓은 역량 프레임워크를 뒷받침하도록 설계되었으므로, UME 기초역량에 기반해 핵심 EPA를 재검토하는 협력 작업이 향후 계획되어 있다.
"The Foundational Competencies for UME — a more inclusive, current, and aligned framework — will replace the 2013 AAMC PCRS. Since EPAs are designed to support a broad competency framework, a future, collaborative effort is being planned to revisit the Core EPAs, based on the Foundational Competencies for UME."


정리하면 ① PCRS는 퇴장하고, ② Core EPAs도 이 프레임워크에 맞춰 다시 손볼 예정이라는 거예요. EPA가 역량 프레임워크 "위에" 놓인다는 관계를 분명히 했다는 점도 짚어 둘 만해요.


⚠️ 7. 연구진이 거듭 강조한 것: "모두에게 똑같이"가 아니다

보고서를 읽다 보면 연구진이 여러 번 되풀이하는 메시지가 있어요. 이 프레임워크는 최소한의 공통 기반이지 완성된 교육과정이 아니라는 거예요. 먼저, 망라적이지 않다고 분명히 말해요.

UME 기초역량은 향후 진로와 관계없이 미국의 모든 DO·MD 학생에게 적용하도록 의도되었지만, 학생이 기본의학교육 동안 성취하기를 기대하는 것을 망라하려는 것은 아니다.
"The Foundational Competencies for UME are intended to apply to all DO and MD students in the United States, regardless of their future career plans; however, regarding what students are expected to achieve during their undergraduate medical education, these competencies are not intended to be exhaustive."


획일화를 목표로 하지도 않았대요.

우리의 사명은 '모두에게 맞는 단일한(one-size-fits-all)' 시스템을 만드는 것이 아니었다.
"Our mission was not intended to create a 'one-size-fits-all' system."

그래서 각 학교가 할 일이 남아 있다고 해요.

모든 역량과 세부역량은 포괄적으로 쓰여 있어서, 구체적인 교수·학습·평가 방법을 위해서는 더 세분화가 필요하다. 모든 의과대학은 이 역량이 자신의 지역적 사명과 효과적인 환자진료 방식에 어떻게 적용되는지, 그리고 교수와 평가를 위해 어떻게 더 세분화할 수 있는지 고민해야 한다.
"all competencies and subcompetencies, however, are broad and will need further delineation for specific teaching, learning, and assessment methods. All medical schools should consider how the competencies apply to their local missions and approaches to effective patient care, as well as how they can be further delineated for teaching and assessments."


또 이 프레임워크는 한 번 만들고 끝이 아니라 주기적으로 검토하고 개정할 계획이라고 밝혔어요.


💡 8. 한국 의학교육에 주는 시사점

마지막으로 제 생각을 조금 덧붙여 볼게요. 어디까지나 제 해석이에요.

  • ① UME-GME를 잇는 "공통 언어"의 문제 🔗
    • 이 보고서의 출발점은 결국 "의대 졸업역량과 전공의 수련역량이 서로 다른 말을 쓰고 있다"는 문제의식이었어요. 우리도 기본의학교육 학습성과나 『한국의 의사상』 같은 졸업 단계 틀이 있고, 전공의 수련 쪽은 최근 역량바탕 수련과 WBA 도입이 진행되고 있죠. 두 단계가 같은 역량 틀과 용어로 연결돼 있는지, 그래서 학생 정보가 수련 프로그램으로 의미 있게 인계(handover) 될 수 있는지는 한번 따져 볼 만한 질문이라고 생각해요.
  • ② "같은 틀, 다른 수준"이라는 설계 방식 📐
    • GME 역량을 그대로 가져오지 않고 발달 단계에 맞는 언어로 다시 쓴 방식은 참고할 만해요. 연속체 전체에서 틀은 유지하면서 기대 수준만 조정하는 거죠. 마일스톤 같은 발달 단계 기술과도 자연스럽게 이어질 수 있는 구조예요.
  • ③ 개발 과정 자체의 교훈 🤝
    • 환자·보호자와 학생을 반응그룹으로 공식 참여시키고, 여러 차례 공개 의견수렴을 거친 점, 그리고 "속도보다 질"을 원칙으로 내건 점이 인상적이었어요. 역량 프레임워크의 정당성은 문장 자체만큼이나 누가 어떻게 만들었는가 에서 나온다는 걸 보여 주는 사례 같아요.
  • ④ 남는 질문들 🤔
    • 물론 한계도 있어요. 45개 세부역량은 여전히 추상적이어서, 보고서 스스로 말하듯 결국 각 학교의 세분화(delineation) 와 평가 설계가 성패를 가를 거예요. 또 역량 목록이 늘어날수록 평가 부담이 커질 수 있다는 점, EPA 재정비가 아직 "계획" 단계라는 점도 지켜봐야 할 부분이에요.

✅ 정리하며

  • 미국 AAMC·AACOM·ACGME가 모든 의대생을 위한 공통 기초역량을 처음으로 함께 만들었어요.
  • 6개 역량, 45개 세부역량, DO 전용 4개로 구성되고, ACGME 6개 핵심역량과 정렬돼 있어요.
  • GME 역량을 의대생 발달 수준에 맞는 언어로 다시 썼고, 웰빙, 편향 인식, 신기술, 건강형평이 눈에 띄게 들어갔어요.
  • PCRS를 대체하고, Core EPAs 재검토도 예고했어요.
  • 연구진은 이것이 망라적이지도, 획일적이지도 않은 공통 기반이며, 각 학교가 자기 사명에 맞게 구체화해야 한다고 거듭 강조해요.

원문은 CC BY-NC 오픈 액세스라 AAMC 홈페이지에서 무료로 받을 수 있어요. 특히 11~13쪽의 세부역량 목록은 교육과정 매핑 작업을 하실 때 옆에 두고 보시면 좋을 거예요. 📎


서론 (Introduction) 

미국의과대학협회(AAMC), 미국정골의과대학협회(AACOM), 전공의교육인증위원회(ACGME)는 미국 의과대학에서 함께 사용할 공통의 기초 역량을 마련하기 위한 사업을 공동 후원했다. 이 역량은 정골의학박사(DO) 학위 수여 대학과 의학박사(MD) 학위 수여 대학이 의료체계에 기여하는 고유한 정체성과 역할을 인정한다. 이 보고서는 그 사업의 산물인 학부 의학교육(undergraduate medical education, UME)을 위한 기초 역량, 포용적이고 반복적인 개발 과정, 그리고 역량바탕 의학교육(CBME)을 발전시키는 데 이러한 역량을 어떻게 사용하고자 하는지를 제시한다. 이 틀은 전문직업성(Professionalism), 환자 진료 및 시술 술기(Patient Care and Procedural Skills), 의학 지식(Medical Knowledge), 진료 기반 학습 및 개선(Practice-Based Learning and Improvement), 대인관계 및 의사소통 술기(Interpersonal and Communication Skills), 체계 기반 진료(Systems-Based Practice)의 6개 역량과 모든 의대생에게 적용되는 45개 세부역량, DO 학생에게만 적용되는 추가 세부역량 4개로 구성된다.


역량(competencies)은 “지식, 기술, 태도 등 여러 요소를 통합하는 보건의료 전문직의 관찰 가능한 능력”이다.1 학부 의학교육을 위한 기초 역량은 장래 진로와 무관하게 미국의 모든 DO 및 MD 학생에게 적용되도록 마련되었지만, 학부 의학교육 중 학생이 달성해야 할 사항을 빠짐없이 망라하려는 것은 아니다. 또한 의과대학과 교수진은 이러한 역량을 가르치는 방식이 서로 다를 것이며, 각자의 사명, 원칙, 지역사회를 더 충실하게 반영하도록 이를 확장하고자 할 것이다.


이 사업은 의사 책무성 연합(Coalition for Physician Accountability)의 학부 의학교육–대학원 의학교육 검토위원회 보고서2에 제시된 권고와 궤를 같이하며, 학부 의학교육(UME)에서 대학원 의학교육(graduate medical education, GME)으로의 전환을 개선하려는 보고서의 세 공동 후원 기관의 포괄적 노력에 속한다.


학부 의학교육을 위한 기초 역량을 개발하면서 우리는 DO와 MD 교육과정을 포함한 모든 의과대학의 기여, 고유한 정체성과 전통을 인정하고, 그 학습자에게 공통적인 성과와 서로 다른 성과를 인정하고자 했다. 우리의 목적은 ‘모든 상황에 똑같이 적용되는’ 체계를 만드는 것이 아니었다. DO 학위 수여 대학은 모든 역량 전반에 정골의학 원칙과 신조(osteopathic principles and tenets)를 계속 통합할 것이다. DO 교육에만 해당하는 세부역량은 3개 역량 영역에 포함되어 있지만, 모든 역량과 세부역량은 폭넓게 제시되어 있으므로 구체적인 교수·학습·평가 방법을 위해서는 한층 세분화해야 한다. 모든 의과대학은 이 역량이 각 기관의 사명과 효과적인 환자 진료 방식에 어떻게 적용되는지, 교수와 평가를 위해 어떻게 더 세분화할 수 있는지 고려해야 한다. 이 보고서에서 사용한 약어와 용어의 전체 목록은 용어집을 참조하기 바란다.

역량바탕 의학교육의 간략한 배경 (Brief Background on Competency-Based Medical Education) 

학부 의학교육을 위한 기초 역량의 공동 개발은 세 후원 기관과 의학교육계 전체가 수십 년 동안 이끌어 온 노력의 중요한 발전을 보여 준다.

  • 역량바탕 교육은 매우 오랜 역사를 지녔지만, 의학에서 전문직 역량에 관한 최초의 현대적 국가 수준 틀은 캐나다 왕립의사외과의사협회(Royal College of Physicians and Surgeons of Canada)가 1996년에 발표했다.3 CanMEDS 틀로 알려진 이 체계는 의사가 자신이 돌보는 사람들의 의료 요구에 효과적으로 대응하기 위해 갖추어야 하는 능력을 설명한다. 지금도 왕립협회의 캐나다 교육·진료 기준의 토대가 된다.
  • 같은 1996년에 AAMC는 MD 학위 수여 의학교육계에서 의대생이 졸업 시 갖추어야 할 특성에 대한 합의를 이루고, 그 특성에 근거한 의과대학 교육과정의 학습목표를 제시하기 위해 의과대학 교육목표 프로젝트(Medical School Objectives Project)4라는 대규모 사업에 착수했다. 이는 미국에서 성과바탕 교육(outcomes-based education)을 강조한 초기의 노력이었다.
  • 몇 년 뒤인 1999년, ACGME와 미국의학전문과목위원회(American Board of Medical Specialties)는 ACGME 인증 레지던트 과정을 마친 모든 의사에게 필요한 기초 능력을 규정하여 레지던트 교육을 설계하고 평가하기 위한 6개 핵심 역량 틀을 발표했다.5
  • 2001년에는 역량바탕 대학원 의학교육을 실현하기 위해 ACGME 성과 프로젝트(Outcome Project)가 공식적으로 출범했다.6
  • 2003년 미국정골의학협회(American Osteopathic Association)는 「핵심 역량 태스크포스 보고서」(Report of the Core Competency Task Force)7를 발표했으며, 이는 2006년 미국정골의사국가시험위원회의 초기 역량 보고서8의 토대가 되었다.
  • 2012년에는 AACOM이 「의대생을 위한 정골의학 핵심 역량」(Osteopathic Core Competencies for Medical Students)9을 출판했고, ACGME는 6개 핵심 역량을 더욱 세분화하는 마일스톤(milestones)을 통합한 차세대 인증체계(Next Accreditation System)10를 시작했다. 마일스톤은 전공의와 펠로우가 6개 핵심 역량에서 보여 주어야 할 발달 단계별 수행 수준을 설명했다.
  • 2013년 AAMC는 학부 의학교육 프로그램의 기대 성과를 종합한 8개 역량의 의사 역량 참조 집합(Physician Competency Reference Set, PCRS)11을 발표했다.

2014년에는 평가, 인증, 면허, 자격인증 활동을 통해 의학교육의 전 연속체를 대표하고 감독하는 국가 조직들의 연합체인 의사 책무성 연합12이 ACGME와 미국의학전문과목위원회의 6개 핵심 역량 틀을 지지했다.13 연합은 DO 공동체처럼 일부 구성 집단이 특정 역량을 강조할 수 있음을 인정하면서도, 모든 의사에게 필수적인 역량에 지지를 집중했다.

“연합 회원들은 전문직 역량을 위한 틀로서, 일반적이지만 필수적인 6개 역량 영역, 즉 전문직업성, 의학 지식, 환자 진료 및 시술 술기, 대인관계 및 의사소통 술기, 진료 기반 학습 및 개선, 체계 기반 진료를 포함하는 틀을 지지한다. 연합 회원 기관들은 사회와 의료전달체계의 요구가 변화하더라도 학생과 의사가 탁월한 환자 진료에 필요한 지식과 기술을 갖추도록, 역량을 지속적이고 의미 있게 평가하고 발전시키는 절차에 전념한다.”


10년 전에 이러한 지지가 있었지만, 의학교육계는 지금까지 학부 의학교육을 위한 공통 역량 틀을 공동으로 정의하지 못했다. 이 문서가 설명하는 현재의 작업은 바로 미국 학부 의학교육을 위한 공유 역량 틀을 만드는 일이다.


지난 10년간 역량바탕 의학교육을 발전시키기 위한 다른 국가적 노력도 이 간략한 역사 개관에서 언급할 만하다.

  • 2005년에 위임가능 전문직무(entrustable professional activities, EPAs)는 수련자가 충분한 역량을 갖추었을 때 감독 없이 수행하도록 맡길 수 있는 전문직 실무 단위, 과업 또는 책임으로 처음 정의되었다.14
  • 2014년 AAMC는 모든 의대생이 전공의 과정에 진입할 때 간접 감독하에 수행할 수 있어야 하는 13개 전공의 진입 핵심 위임가능 전문직무(Core EPAs)15를 발표했다. 핵심 EPA는 학생의 UME–GME 전환을 개선하기 위해 개발되고 PCRS에 맞추어졌으며 시범 시험을 거쳤다.
  • 2016년 AACOM은 「전공의 진입 핵심 위임가능 전문직무를 위한 정골의학적 고려사항」(Osteopathic Considerations for Core Entrustable Professional Activities for Entering Residency)16을 발표했고, ACGME는 마일스톤 2.0(Milestones 2.0)을 통해 GME 마일스톤을 갱신하고 개선하기 위한 노력을 시작했다.5
  • 2015년부터 2020년까지 레지던트 및 펠로십 프로그램 인증은 단일 체계로 전환되었다. ACGME는 정골의학 원칙과 실천에 대한 정규 교육을 교육과정에 통합한 레지던트 또는 펠로십 프로그램을 위해 정골의학 인정(Osteopathic Recognition)을 마련했다.17

학부 의학교육을 위한 기초 역량의 개발은 역량바탕 의학교육의 중요한 발전일 뿐 아니라, 의사 책무성 연합의 2021년 학부 의학교육–대학원 의학교육 검토위원회 보고서2의 권고에도 부응한다. 구체적으로 제9권고는 “UME와 GME 교육자들이 교육 연속체 전체의 대표자들과 함께 UME–GME 전환 과정의 학습자에게 적용할 공통 틀과 일련의 성과(역량)를 공동으로 정의하고 시행해야 한다”고 명시한다.


보고서는 이 권고를 다음과 같이 더 설명한다.

“역량에 관한 공유된 정신모형(shared mental model)은 학습자의 진전을 평가하는 데 사용되는 평가 전략과 평가에서 이끌어 낼 수 있는 추론에 대한 합의를 촉진한다. 성과를 표현하는 공통 언어는 환자와 대중의 신뢰를 염두에 두고 학습자의 역량에 관한 정보를 전달할 수 있다. 개별 학습자에게 이러한 성과의 정의는 학습을 돕고 성장 사고방식을 촉진할 수 있다. 교수진에게는 수행 기대치에 부합하는 평가도구의 사용과 교수개발을 가능하게 한다. 레지던트 프로그램에는 전공의 선발, UME에서의 학습자 인계, 전공의 교육, 진료 준비에 유용할 것이다.”2


역량바탕 의학교육과 전통적인 교수·학습 접근법을 각각 비교하면, 일부 특징은 다음과 같이 요약할 수 있다.


  • 과정(processes)보다 성과(outcomes)에 초점을 맞춘다.
  • 교수자 주도보다 학습자 중심·환자 중심이다.
  • 드물게 시행하는 고부담 시험보다 시간에 걸친 다면적 형성평가(formative assessment)를 요구한다.
  • 모두에게 동일한 표준 접근보다 유연하고 시간에 구애받지 않는 학습을 지원한다.


역량바탕 의학교육을 뒷받침하는 방대한 연구와 여러 교육 이론을 포함한 추가적인 세부사항은 이 문서의 범위를 훨씬 벗어난다. 다만 독자들이 Van Melle 등18이 설명한 다섯 가지 핵심 구성요소에 익숙해지고 학부 의학교육을 위한 기초 역량을 역량바탕 의학교육의 더 넓은 맥락 속에 놓고 이해하기를 권한다.

개발 과정 (The Development Process) 

학부 의학교육을 위한 기초 역량을 개발하는 약 3년의 과정(그림 1)은 Batt 등19이 제시한 보건의료 전문직 역량 틀 개발 모형을 참고했으며, 공동 기획, 지역사회 논의, 현황 검토(landscape review), 역량 개발, 보고, 보급을 포함했다. 세 후원 기관을 대표하는 공동 책임자들은 학술의학 전반의 전문기관 관계자로 구성된 자문위원회(advisory committee, AC)의 지원을 받았다. 전국 단위의 지원 절차를 거쳐 학부 의학교육을 위한 기초 역량 초안을 작성할 실무그룹(working group, WG)을 구성했고, 중요한 통찰을 제공하여 실무그룹의 노력을 뒷받침할 두 반응그룹(reactor groups, RGs), 즉 환자·돌봄제공자 그룹과 의대생 그룹을 만들었다. 자원 참가자들의 활동과 개발 과정에 관한 자세한 내용은 부록을 참조하기 바란다.


그림 1. 학부 의학교육을 위한 기초 역량 개발 일정 (Figure 1. The timeline for the development of the Foundational Competencies for Undergraduate Medical Education).

  • 2021년 9월–2022년 7월: 세 후원 기관이 역량 사업을 계획하고 자문위원회를 소집한다.
  • 2022년 8월–2023년 2월: 기초 역량과 학부 의학교육 전반에서 공통 성과를 도입하는 데 따른 함의에 관해 의료 전문가, 학습자, 환자, 돌봄제공자 1,000명 이상에게서 초기 의견을 수집한다. 전국 지원자 모집에 이어 다양한 구성원의 실무그룹을 선정한다.
  • 2023년 3월–2024년 6월: 실무그룹이 학부 의학교육을 위한 기초 역량을 개발한다. 반복 수정된 초안을 공개 검토와 의견 수렴에 부친다.
  • 2024년 말 이후: 기초 역량을 널리 배포하고, 역량바탕 의학교육을 실현하기 위한 공동 노력에 의학교육계의 참여를 요청한다.


지역사회 논의 단계 전반에 걸쳐 여러 포럼을 열어 의료와 의학교육에 관한 다양한 관점을 가진 1,000명 이상을 참여시켰다. 공동 책임자들은 의대생, 전공의, 펠로우, 교수, 환자, 병원 최고경영자, 의과대학 학장, 박사 학위 과학자의 관점을 들었다. 포럼에서 자주 던진 질문은 “미래 전문과목과 관계없이 모든 미래의 의사가 무엇을 할 수 있고, 무엇을 알고, 무엇을 중시하기를 기대할 것인가?”였다. 다음은 그 응답의 일부다.

  • 연민(Compassion) — “언젠가 의사와 간호사에게서 빠져 있는 그 연결고리를 표현할 수 있으리라는 것을 알고 있었어요. 그들은 삶의 마지막 시기에 관해 충분히 배우지 못합니다. … 세상에는 그 부분에서 조금 더 많은 연민이 필요합니다.” — 돌봄제공자
  • 자기돌봄(Self-Care) — “목표는 단지 어떻게 견딜 것인가가 아니라, 이상적으로는 타인의 삶에 선을 행한다는 직업의 목적과 의미를 중시하는 기준점으로 어떻게 계속 돌아올 것인가입니다.” — 교육병원 최고경영자
  • 양질의 진료(Quality Care) — “모든 환자에게 개인화된 방식으로 최고 수준의 근거바탕 진료를 제공해야 합니다. 이는 높은 수준의 성과와 과정 개선을 뒷받침하는 체계를 어떻게 만들어 개별 환자와 인구집단의 진료 질을 지속해서 높일지 이해한다는 뜻입니다.” — 교육병원 최고경영자
  • 유연성과 회복탄력성(Flexibility and Resiliency) — “현재도, 앞으로도 의료에 접근하는 길은 매우 많습니다. … 이러한 변화에 적응하면서 의료의 구조는 빠르게 바뀔 가능성이 큽니다. … 의사가 성공적인 경력을 이어가려면 유연성과 회복탄력성이 필요합니다.” — 교수
  • 의사소통(Communication) — “의사소통 없이는 과학과 임상 술기가 있을 수 없습니다. … 소진도 많고 의사로서 느끼는 기쁨도 부족합니다. 서로 의사소통하지 않는 칸막이 속에서 일하는 어려움도 있습니다. 그러니 의사소통에서 팀워크와 진료 조정으로 이어지고, 서로 어려운 대화를 나누며, 두려워하지 않고 함께 헤쳐 나갈 수 있어야 합니다.” — 환자 옹호자

우리는 또한 학부 의학교육을 위한 기초 역량의 예상되는 이점을 의학교육계에 물었다. 그들은 다음과 같이 이 작업이 유익할 수 있는 여러 방식을 제시했다.

  • 개별화된 학습 기회의 확대.
  • 의과대학에서 레지던트 과정으로의 전환 개선:
  • 전공의가 첫 근무일을 더 잘 준비한다.
  • 의과대학과 레지던트 프로그램이 공통 언어를 사용한다.
  • 레지던트 프로그램이 신입 전공의에게 무엇을 기대하고 어떻게 가장 잘 도울지 안다.
  • 환자 성과의 개선.

개발 단계에서 실무그룹은 여러 차례 초안을 만들고 수정했다. 대면 모임, 설문조사, 온라인 의견 양식을 통해 각 초안에 대해 반응그룹, 자문위원회, 의학교육계와 일반 대중의 의견을 구했다. 세 차례의 반복 초안을 검토한 뒤 총 2,000건 이상의 응답을 받았다(세 번째 초안은 자문위원회와 반응그룹에만 공유했다). 모든 의견은 최종 학부 의학교육을 위한 기초 역량, 즉 6개 역량, 45개 세부역량, DO에만 적용되는 추가 세부역량 4개를 확정하는 데 기여했다.


학부 의학교육을 위한 기초 역량은 주기적으로 검토·갱신될 것이다. 다양한 의학교육계의 의견을 수렴하여 새로운 역량이 미국 전역의 의과대학에서 어떻게 사용되는지 더 잘 파악하고, 후원 기관과 다른 관계자들이 그 사용과 향후 조정을 어떻게 더 잘 지원할지 판단하는 데 활용할 것이다.

중요한 고려사항 (Important Considerations) 

UME와 GME 역량의 비교 (Comparing UME and GME Competencies) 

표 1은 학부 의학교육을 위한 새로운 6개 기초 역량과 현재의 GME 역량을 비교한다.20 실무그룹의 첫 과제 중 하나는 1999년 GME를 위해 만들어지고 2019년에 마지막으로 개정된 역량 진술문이 UME 학습자에게 적절한지 검토하는 것이었다. 두 역량 집합은 서로 맞닿아 있지만, 학부 의학교육을 위한 기초 역량은 UME 학습자의 발달 단계에 적절한 언어로 표현된다.


표 1. 여섯 가지 역량: 학부 의학교육과 대학원 의학교육 (Table 1. Six Competencies: Undergraduate Medical Education and Graduate Medical Education) 

역량 학부 의학교육(UME) 대학원 의학교육(GME)
전문직업성(Professionalism) 환자, 지역사회, 인구집단의 의료를 개선하기 위해 모든 상호작용에서 진실성, 존중, 윤리적 추론을 보여 주고 차이에 대한 포용을 증진한다. 전문직업성에 대한 헌신과 윤리 원칙의 준수를 보여 준다.
환자 진료 및 시술 술기(Patient Care and Procedural Skills) 연민이 있고 효과적이며 전인적·근거정보 기반·형평적인 환자중심 진료를 보여 준다. 건강 문제의 치료와 건강 증진을 위해 환자·가족 중심이며 연민이 있고 형평적이며 적절하고 효과적인 환자 진료를 제공한다. 해당 진료 영역에서 필수적인 것으로 간주되는 모든 의학적·진단적·외과적 시술을 수행한다.
의학 지식(Medical Knowledge) 환자와 인구집단의 의료를 개선하기 위해 기초 지식을 적용하고 통합한다. 과학적 탐구를 포함한 확립된 생의학·임상의학·역학·사회행동과학 지식과 그 발전 양상, 그리고 이 지식을 환자 진료에 적용하는 방법을 알고 있음을 보여 준다.
진료 기반 학습 및 개선(Practice-Based Learning and Improvement) 피드백, 근거, 성찰을 통합하여 행동을 조정하고 개선을 촉진하며 평생학습을 함양한다. 자신의 환자 진료를 조사·평가하고, 과학적 근거를 비판적으로 평가·동화하며, 지속적인 자기평가와 평생학습을 바탕으로 환자 진료를 계속 개선하는 능력을 보여 준다.
대인관계 및 의사소통 술기(Interpersonal and Communication Skills) 양질의 환자중심 진료에 기여하기 위해 환자, 돌봄제공자, 의료팀과 효과적으로 소통하고 상호작용한다. 환자, 가족, 보건의료 전문직과 효과적으로 정보를 교환하고 협력하게 하는 대인관계 및 의사소통 술기를 보여 준다.
체계 기반 진료(Systems-Based Practice) 건강의 사회적·구조적 결정요인을 포함한 더 넓은 건강 맥락과 의료 안팎의 체계·자원에 관한 지식을 적용하여 환자, 지역사회, 인구집단을 위한 양질의 진료를 최적화한다. 건강의 구조적·사회적 결정요인을 포함한 더 넓은 건강 맥락과 의료체계를 인식하고 이에 대응하며, 최적의 의료를 제공하기 위해 다른 자원을 효과적으로 활용하는 능력을 보여 준다.

학부 의학교육을 위한 기초 역량의 의도된 활용 (Intended Uses of the Foundational Competencies for UME) 

학부 의학교육을 위한 기초 역량은 학술의학에서 맡은 역할에 따라 여러 용도로 활용할 수 있다. 예를 들어 교육과정 학장과 위원회는 현재의 교수 및 평가 관행에 역량을 대응시켜 강점과 잠재적 공백을 찾을 수 있다. 역량은 교수 코치가 학생과 학습계획을 공동 설계하고 교수 경험과 평가 방법을 설계하거나 조정하는 데 도움을 줄 수 있다. 그 밖의 활용에는 다음이 포함된다.

  • 학생의 자기평가와 개인 학습계획 수립.
  • 교육 경험 또는 교과목의 학습목표 개발.
  • 프로그램 차원 평가(programmatic assessment)의 공백 파악.
  • 평가 방법 개발.
  • 의학교육 연구와 학술활동의 발전.

학부 의학교육을 위한 기초 역량과 다른 틀의 관계 (How the Foundational Competencies for UME Relate to Other Frameworks) 

학부 의학교육을 위한 기초 역량은 2014년 의학계 전반에서 폭넓게 지지한 6개 광범위한 영역의 기대 성과를 제시한다(표 1).13 이러한 영역은 학위 종류나 장래 전문과목과 관계없이 모든 의대생에게 기초가 되는 역량을 나타낸다. AAMC의 「의학의 새로운·부상하는 분야 역량 시리즈」(New and Emerging Areas in Medicine Competency Series)21와 AACOM의 「농촌의학 핵심 역량」(Rural Medicine Core Competencies)22 같은 다른 역량은 새롭게 부상하는 주제 영역의 깊이를 더하고, 특히 교육과정에서 충분히 다루지 않는 영역에서 교육과정 및 전문직 개발의 길잡이가 되도록 마련되었다. 주제별 역량과 학부 의학교육을 위한 기초 역량은 모두 형성적 수행평가와 교육 연속체 간 협력을 이끌고, 궁극적으로 의료서비스와 성과를 개선하기 위한 것이다.


더 포용적이고 최신이며 서로 연계된 틀인 학부 의학교육을 위한 기초 역량은 2013년 AAMC PCRS를 대체할 것이다. EPA는 광범위한 역량 틀을 뒷받침하도록 설계되었으므로, 학부 의학교육을 위한 기초 역량에 근거하여 핵심 EPA15,16를 재검토하는 향후 공동 작업이 계획되고 있다.

정골의학 원칙과 신조 (Osteopathic Principles and Tenets) 

학부 의학교육을 위한 기초 역량을 개발하면서 DO 교육자들과 다른 참여자들은 정골의학 원칙과 신조의 통합에 초점을 맞추었다.23

  1. 신체는 하나의 단위이며, 사람은 몸·마음·정신의 통합체다.
  2. 신체에는 자기조절, 자가치유, 건강 유지 능력이 있다.
  3. 구조와 기능은 상호 관련된다.
  4. 합리적 치료는 신체의 통일성, 자기조절, 구조와 기능의 상호관계라는 기본 원칙에 대한 이해를 바탕으로 한다.

DO와 MD 교육과정의 고유한 정체성은 앞으로도 인정받고 존중받는다. DO 학위 수여 대학은 모든 세부역량을 구체화할 때 정골의학 원칙과 신조를 통합해야 한다. 실무그룹은 정골의학에만 적용되는 세부역량 4개를 만들기로 했지만, 이것이 정골의학의 원칙과 신조가 구현될 모든 방식을 나타내는 것은 아니다. 모든 세부역량은 의도적으로 폭넓게 설계되었으므로 구체적인 교수·학습·평가 방법을 위해서는 더 세분화해야 한다. 다시 말해, 모든 DO 및 MD 학위 수여 대학과 교수진은 학부 의학교육을 위한 기초 역량이 각 기관의 사명과 지역사회에 어떻게 적용되는지, 교수와 평가를 위해 어떻게 더 세분화할 수 있는지 고려해야 한다.

학부 의학교육을 위한 기초 역량
(Foundational Competencies for Undergraduate Medical Education)
 

전문직업성(Professionalism) 

환자, 지역사회, 인구집단의 의료를 개선하기 위해 모든 상호작용에서 진실성, 존중, 윤리적 추론을 보여 주고 차이에 대한 포용을 증진한다.

1. 환자, 돌봄제공자, 가족, 팀원에게 존중과 연민을 보여 준다.

2. 환자의 사생활, 비밀, 자율성을 보호한다.

3. 윤리 원칙과 추론을 활용해 행동을 이끈다.

4. 상황에 따라 행동과 의사소통을 조정한다.

5. 자신의 실수를 책임지고 이를 해결하기 위해 행동한다.

6. 자신의 지식과 기술의 한계를 파악하고 적절하게 도움을 구한다.

7. 자신의 편향과 그 영향을 완화할 전략을 파악한다.

8. 서로 다른 배경과 경험을 가진 사람들에게서 배우려는 겸손과 의지를 보여 준다.

9. 전문직 수행에 영향을 줄 수 있는 자신의 웰빙 요구를 인식하고 대응한다.

10. 의무와 과업을 철저하고 신뢰성 있게, 제때 완수한다.

11. DO 학생만 해당: 네 가지 신조를 증진함으로써 정골의학 철학을 보여 준다.

환자 진료 및 시술 술기(Patient Care and Procedural Skills) 

연민이 있고 효과적이며 전인적·근거정보 기반·형평적인 환자중심 진료를 보여 준다.

1. 환자와 돌봄제공자의 상황, 요구, 가치, 선호, 경험을 환자 진료에 통합한다.

2. 필요에 따라 여러 자료원에서 관련 환자 병력을 수집한다.

3. 적절한 기법과 도구를 사용하여 관련 신체진찰을 수행한다.

4. 긴급 또는 응급 진료가 필요한 환자를 파악하고, 도움을 구하며, 초기 평가와 관리 방안을 제안한다.

5. 감별진단을 구성하고 우선순위를 정한다.

6. 가설에 근거한 진단검사를 제안하고 결과를 해석한다.

7. 흔히 접하는 임상 상태에 대한 치료 관리 계획을 수립한다.

8. 환자중심 언어를 사용하여 일반적인 진단·치료 중재와 계획을 설명한다.

9. 기본적인 시술 기법을 보여 준다.

10. 건강증진과 질병예방을 환자 진료 계획에 포함한다.

11. 건강과 웰빙에 영향을 미치는 개인적·구조적 요인을 파악한다.

12. DO 학생만 해당: 정골의학 원칙, 실천, 신조를 환자 진료에 통합한다.

13. DO 학생만 해당: 정골의학적 구조 검진(osteopathic structural examination)을 수행하고, 정골의학 도수치료(osteopathic manipulative treatment, OMT)로 신체 구조계의 기능 변화 또는 체성기능장애(somatic dysfunction)를 치료한다.

의학 지식(Medical Knowledge) 

환자와 인구집단의 의료를 개선하기 위해 기초 지식을 적용하고 통합한다.

1. 임상 진료에 필요한 기초과학, 임상의학, 병태생리학, 사회과학, 보건의료체계과학(health systems sciences), 인문학 지식을 보여 준다.

2. 임상 상황에서 임상 문제해결, 진단적 추론, 의사결정에 기초 지식을 적용한다.

3. 정보의 정확성과 임상 문제와의 관련성을 판단한다.

4. 연구 설계, 해석, 임상 질문에의 적용에 관한 지식을 보여 준다.

5. 새롭게 등장하는 기술을 포함한 적절한 자원을 사용하여 임상 문제와 관련된 지식에 접근한다.

6. DO 학생만 해당: 정골의학 원칙, 실천, 신조를 환자 진료에 통합하는 방법에 관한 지식을 보여 준다.

진료 기반 학습 및 개선(Practice-Based Learning and Improvement) 

피드백, 근거, 성찰을 통합하여 행동을 조정하고 개선을 촉진하며 평생학습(lifelong learning)을 함양한다.

1. 수행을 개선하기 위해 피드백과 평가 자료를 능동적으로 구하고 반영한다.

2. 정보에 근거한 자기평가와 성찰적 실천(reflective practice)을 통해 자신의 수행에서 성장 기회를 찾는다.

3. 학습과 개선 목표를 세우고 실행하며 재평가한다.

4. 근거정보 기반의 환자중심 임상 의사결정을 뒷받침하기 위해 정보를 찾고 비판적으로 평가하며 종합한다.

5. 탐구심과 성장하고 새로운 지식을 구하는 능력을 보여 준다.

대인관계 및 의사소통 술기(Interpersonal and Communication Skills) 

양질의 환자중심 진료에 기여하기 위해 환자, 돌봄제공자, 의료팀과 효과적으로 소통하고 상호작용한다.

1. 치료적 관계(therapeutic relationship)를 강화하기 위해 환자, 돌봄제공자, 팀원과 협력한다.

2. 팀과 조직의 기능을 향상하기 위해 의료 및 행정팀 구성원과 협력한다.

3. 적극적 경청(active listening)을 보여 준다.

4. 언어, 비언어, 서면, 전자 형식으로 명확하고 정확하며 연민을 담아 소통한다.

5. 환자, 돌봄제공자, 동료, 팀원을 교육하는 기술을 보여 준다.

6. 타인에게 건설적으로 피드백을 구성하여 전달한다.

체계 기반 진료(Systems-Based Practice) 

건강의 사회적·구조적 결정요인을 포함한 더 넓은 건강 맥락과 의료 안팎의 체계·자원에 관한 지식을 적용하여 환자, 지역사회, 인구집단을 위한 양질의 진료를 최적화한다.

1. 건강의 사회적·구조적 동인(social and structural drivers of health)에 관한 지식을 적용한다.

2. 환자 진료와 의료체계에서 격차를 줄이고 건강 형평성(health equity)을 증진할 기전을 인식한다.

3. 다양한 의료팀, 의료전달 환경, 체계에 맞추어 수행을 조정한다.

4. 환자 진료의 전환과 조정에 협력한다.

5. 환자 진료에서 현재 및 신흥 기술을 사용할 때의 위험과 이익을 평가한다.

6. 환자안전 우려, 체계상 문제, 질 향상 기회를 파악한다.

7. 보건정책과 의료의 재정적 맥락을 설명한다.

8. 지역 인구집단과 지역사회의 건강 요구, 격차, 자원에 관한 지식을 적용한다.

용어집 (Glossary) 

  • AACOM: American Association of Colleges of Osteopathic Medicine(미국정골의과대학협회).
  • AAMC: Association of American Medical Colleges(미국의과대학협회).
  • ACGME: Accreditation Council for Graduate Medical Education(전공의교육인증위원회).
  • 적극적 경청(Active listening): “… 화자가 하는 말에 깊이 관여하고 주의를 기울이는 것이다. 말하는 것보다 훨씬 더 많이 듣는 것이 필요하다. 적극적으로 경청하는 사람의 [목표]는 화자의 관점을 진정으로 이해하고 … 그 이해를 화자에게 다시 전달하여 [화자가] 듣는 사람의 이해가 정확한지 확인할 수 있게 하는 것이다.”24
  • 진료 계획(Care plan): “단일 평가 과정에 따라 환자의 통합된 건강 및 사회적 돌봄 요구를 상세히 기술하는 서면의 [개인화된] 진료 계획.”25
  • 역량 상태(Competence): “특정 맥락에서 수행의 여러 영역 또는 측면에 걸친 능력[(지식, 기술, 태도)]의 총체. 역량 상태에 관한 진술에는 관련 능력, 맥락, 수련 단계를 정의하는 설명적 한정어가 필요하다. 역량 상태는 다차원적이고 역동적이다. 시간, 경험, 환경에 따라 변한다.”1
  • 개별 역량(Competency): “지식, 기술, 가치, 태도를 [통합하는 특정 활동과 관련된] 보건의료 전문직의 관찰 가능한 능력. 역량은 관찰 가능하므로 습득 여부를 확인하기 위해 측정하고 평가할 수 있다. 역량은 점진적 발달을 돕도록 건축 블록처럼 조합할 수 있다.”1
  • 역량바탕 의학교육(Competency-based medical education, CBME): “역량을 조직화 틀로 사용하여 의학교육 프로그램을 설계, 시행, 평가, 검증하는 성과바탕 접근법.”1
  • 비밀유지(Confidentiality): 특정인이 정보를 제3자와 공유하지 못하도록 하는 윤리적 의무.
  • 교육 연속체/의학교육 연속체(Educational continuum/Continuum of medical education): 학부 의학교육(의과대학)에서 대학원 의학교육(레지던트 및 펠로십), 계속 의학교육(진료를 수행하는 동안)에 이르는 의사의 교육 전 범위.
  • 효과적인 진료(Effective care): 과학적 지식에 근거한 서비스를 혜택을 받을 수 있는 모든 사람에게 제공하고, 혜택을 받을 가능성이 낮은 사람에게는 제공하지 않는 것(각각 과소이용과 오용을 피함).26
  • 형평적인 진료(Equitable care): 성별, 민족성, 지리적 위치, 사회경제적 지위 같은 개인적 특성 때문에 질이 달라지지 않는 진료를 제공하는 것.26
  • 근거정보 기반 진료(Evidence-informed care): 과학적 연구, 임상 경험과 판단, 환자의 선호와 가치에서 얻은 정보를 통합하는 진료.27
  • 역량바탕 의학교육 교육과정의 다섯 가지 핵심 구성요소(Five core components of competency-based medical education curricula): 성과 역량(outcome competencies), 순차적 진전(sequenced progression), 맞춤형 학습 경험(tailored learning experiences), 역량 중심 교수(competency-focused instruction), 프로그램 차원 평가(programmatic assessment).18
  • 건강 격차(Health disparity): 다른 집단에 비해 한 집단이 더 큰 질병, 손상, 장애 또는 사망 부담을 겪는 것을 가리킨다.28
  • 건강 형평성(Health equity): “‘건강 형평성’ 또는 ‘건강에서의 형평성’은 이상적으로 모든 사람이 자신의 건강 잠재력을 온전히 달성할 공정한 기회를 가져야 하며, 누구도 그 잠재력의 달성에서 불리한 처지에 놓여서는 안 된다는 뜻을 함축한다.”29
  • 환자중심 진료(Patient-centered care): “개별 환자의 선호, 요구, 가치를 존중하고 이에 대응하며, 환자의 가치가 모든 임상적 결정을 이끌도록 보장하는 진료.”26
  • 환자중심 언어(Patient-centered language): “환자중심 의사소통은 의사, 환자, 그리고 적절한 경우 가족이 공동으로 달성해야 하는 목표에 초점을 맞춘다. 환자중심 의사소통의 몇 가지 특징은 다음과 같다.
    • “환자의 관점(신념, 선호, 우려, 요구)을 드러낸다.
    • “환자의 건강과 웰빙에 관한 생물·심리·사회적 맥락을 탐색한다.
    • “의사–환자 관계에서 신뢰와 상호 존중을 형성하거나 강화한다.
    • “환자가 이해할 수 있는 방식으로 질병과 치료 선택지를 제시한다.
    • “의사소통과 의사결정 과정에 환자가 적극적으로 참여하도록 돕는다.
    • “문제해결과 실행계획에서 상식에 바탕을 둔다.
    • “근거에 기반하고 환자의 가치와 일치하며 실행 가능한 결정을 허용한다.”30
  • 환자안전(Patient safety): 예방 가능한 위해사건과 의료 오류의 발생을 줄이는 실천.31
  • 환자의 사생활(Patient privacy): “… 개인 공간(신체적 사생활), 개인 자료(정보적 사생활), 문화적·종교적 소속을 포함한 개인적 선택(의사결정의 사생활), 가족 및 기타 친밀한 사람들과의 개인적 관계(관계적 사생활) 등 여러 측면을 포괄한다.”32
  • 질 향상(Quality improvement): 의료서비스와 환자 성과의 측정 가능한 개선으로 이어지는 체계적이고 지속적인 실천.31
  • 성찰적 실천(Reflective practice): “… 전문직 종사자가 자신의 암묵적 지식 기반을 자각하고 경험에서 배우는 실천.”33
  • 건강의 사회적·구조적 동인(Social and structural drivers of health): 건강의 사회적 동인과 구조적 동인은 서로 교차하며 의료서비스 접근성, 이환율과 사망률, 의료의 질을 비롯한 건강의 여러 측면에 영향을 준다.
  • 건강의 사회적 동인(Social drivers of health): “건강의 사회적 동인이라는 용어와 건강의 사회적 결정요인(social determinants of health)이라는 용어는 서로 바꾸어 사용한다.”34 “[건강의 사회적 동인은] 사람들이 태어나고 성장하고 생활하고 일하고 나이 드는 지역사회 전반의 기저에 놓인 사회적·경제적·물리적 조건을 가리킨다. 이는 광범위한 건강, 기능, 삶의 질 관련 성과와 위험에 영향을 미친다. 이러한 결정요인과 사회적 지위에 따른 불평등한 분포는 인구집단 간에 예방 가능하고 부당한 건강상태의 차이를 낳는다.”35
  • 건강의 구조적 동인(Structural drivers of health): 건강의 구조적 동인과 건강의 구조적 결정요인(structural determinants of health)은 서로 바꾸어 사용한다. “건강의 구조적 동인은 사회적 불평등을 만들어 내고 따라서 건강에 영향을 주는 상위 수준의 사회적·경제적·정치적 기전을 가리킨다(예: 정부의 의료 재정 지원 정도).”36
  • 정골의학의 신조(Tenets of Osteopathic Medicine): “… 정골의학의 근간이 되는 철학을 표현하며, 미국정골의학협회(AOA) 대의원회가 정책으로 승인했다.
    • 1. “신체는 하나의 단위이며, 사람은 몸·마음·정신의 통합체다.
    • 2. “신체에는 자기조절, 자가치유, 건강 유지 능력이 있다.
    • 3. “구조와 기능은 상호 관련된다.
    • 4. “합리적 치료는 신체의 통일성, 자기조절, 구조와 기능의 상호관계라는 기본 원칙에 대한 이해를 바탕으로 한다.”23
  • 치료적 관계(Therapeutic relationship): 돌봄제공자와 환자의 관계로, 돌봄제공자가 환자를 소중히 여기고 환자에게 헌신하며, 권력의 불균형을 관리하고, 인격과 역량을 갖추는 것을 포함한다.37
  • 진료 전환(Transition of care): “… 환자가 한 진료 환경에서 다른 환경으로 이동하는 것. 진료 환경에는 병원, 외래 1차의료 진료소, 외래 전문과 진료소, 장기요양시설, 재택의료, 재활시설이 포함될 수 있다.”38


Teach Learn Med. 2026 Apr-May;38(2):236-247. doi: 10.1080/10401334.2025.2495352. Epub 2025 Apr 24.

The Historical Roots of Tiered Grading in US Medical Education 


🤔 질문 하나로 시작해 볼까요

임상실습(clerkship)이 끝나면 학생들에게 Honors, High Pass, Pass 같은 등급을 매깁니다. 너무 당연해서 아무도 묻지 않는 관행이죠. 그런데 이 등급식 평가(tiered grading)는 대체 언제, 왜, 무슨 근거로 시작된 걸까요? 


이 논문은 바로 그 질문을 던집니다. 그리고 저자들이 250년치 문헌을 뒤진 끝에 내놓은 답은 꽤 불편합니다. 등급식 평가는 임상역량을 재려고 만들어진 게 아니었다는 겁니다. 의과대학이 대학(university) 체제 안으로 편입되는 과정에서 그냥 딸려 들어온 것에 가깝다는 거죠.


저자들이 쓰는 용어를 먼저 정리하면 이렇습니다. 관찰 도구가 평가(assessment), 그 자료로 내리는 판단이 평정(evaluation), 그 판단에 따른 의사결정이 성적 부여(grading)입니다. 그리고 이 논문이 겨냥하는 건 그중에서도 규준참조(norm-referenced) 방식으로 학생을 서열화하는 등급식 평가입니다.


🏛️ 1부. 의학교육이 대학으로 들어가기까지

미국 의학교육의 출발점은 1765년 John Morgan입니다. 도제식 교육을 넘어 대학과 같은 원리 위에 의학교육을 세우자고 주장했죠. 다만 그가 평가 체계를 구체적으로 설계한 건 아니었습니다. 학위 수여 전에 제대로 된 판단이 필요하다는 정도의 신념은 있었어요.

"그렇다면 우리는 합당한 보상으로 진가를 가려내고, 진정한 공적에 마땅한 영예를 부여하는 것을 목표로 삼읍시다."

"Let us aim then to distinguish worth with adequate reward and confer due honors on real merit." (Morgan, 1765)


문제는 19세기입니다. 대학 밖에 영리 의과대학(proprietary medical school)이 우후죽순 생겨났는데, 입학 기준도 교육과정도 제각각이었고 졸업 요건은 마지막 시험 한 번이 전부인 경우가 많았습니다. 여기서 흥미로운 대목이 있어요. 학생이 학교를 떠나는 이유는 학업 부진보다 등록금을 못 내서인 경우가 훨씬 많았습니다. 교수 수입이 학생 등록금에서 나왔으니 낙제를 시킬 유인이 없었던 거죠.


그러다 1847년 미국의사협회(AMA) 설립, 1910년 Flexner Report를 거치며 의학교육은 본격적으로 대학 안으로 들어갑니다. 그리고 이때 대학의 문화와 환경이 함께 따라 들어옵니다. 평가 방식까지 통째로요.


🎓 2부. 등급제의 진짜 기원: 학문이 아니라 규율

그럼 대학은 그 등급제를 어디서 가져왔을까요? 논문은 영국, 특히 케임브리지의 수학 경시대회 Tripos를 지목합니다. 원래는 자발적 참가 경쟁이었고 학위 수여와 무관했는데, 점수화가 유럽 대학 전반으로 퍼졌고 미국까지 건너왔습니다.


미국 최초의 서열화는 1785년 예일대의 Ezra Stiles 총장이었습니다. 학생들을 optimi, secondary optimi, inferiors, pejores의 네 등급으로 나눴죠. 목적이 뭐였는지가 중요합니다. 성적이 낮은 학생이 느낄 수치심(humiliation)이 더 열심히 공부하게 만들 거라고 기대한 겁니다.


학생들 반응이요? 1786년 4월, 나흘간 폭동이 일어났습니다. 창문에 벽돌을 던지고 튜터들 집 문을 부수려 했다고 해요. (총장 관저는 무사했다고 합니다. 😅)


이 대목이 이 논문에서 가장 인상적인 부분이라고 생각합니다. 역사학자 David Allmendinger는 일상 과제에 점수를 매기고, 석차를 내고, 성적표를 부모에게 보내는 이 모든 것이 "규율 절차로 도입된 개혁"(reforms introduced as disciplinary procedures)이었지 학문 수준을 높이기 위한 수단이 아니었다고 정리합니다.


즉, 등급제는 타당한 교수학습 원리에서 나온 게 아니라 수치심과 낭패감을 통해 행동을 통제하려는 장치로 출발했다는 겁니다.

이후 흐름은 빠릅니다. Mount Holyoke가 1884년 A-F 문자 등급을 도입했고, 1930년경에는 대부분의 대학이 5단계 문자 등급을 쓰게 됩니다.


⚠️ 3부. 사실 초기부터 비판은 있었습니다

여기서 논문이 파고드는 지점이 있습니다. 등급제는 도입 직후부터 계속 비판받아 왔다는 것.

미주리대 심리학자 Max Meyer는 등급제의 신뢰도 문제를 지적하면서, 교수들끼리도 학생들끼리도 서로를 의심의 눈초리로 보게 되고 이것이 공동체 의식을 해친다고 했습니다.

1910년 미국심리학회장 J. McKeen Cattell은 하버드 교사협회 연설에서 이렇게 말했죠.

"학생들이 석차를 놓고 경쟁하도록 설득해서 학업을 향상시키려는 계획은 헛되고 다소 반도덕적입니다. 무미건조하고 소득 없는 공부를 경쟁으로 재미있게 만들려는 것은 자동차 앞에 냄새를 두는 격입니다."

"Futile and somewhat anti-moral is the plan proposed of trying to improve scholarship by trying to persuade students to compete for class rank...to try to make dull and profitless work interesting by competition puts the smell before the automobile." (Cattell, 1910)


더 뼈아픈 건 등급제 지지자들의 인정입니다. 교육심리학자 S.S. Colvin은 1912년에 등급제가 제대로 이해된 적도 일관되게 운영된 적도 없다고 하면서, 이렇게 덧붙입니다.

"그것을 고안한 사람들이나 운영한 사람들의 선견지명 때문이 아니라, 우연히 자라난 것이다."

"...had grown up by chance rather than because of any foresight on the part of those who devised it, or those who administered it." (Colvin, 1912)

그리고 Tripos 출신인 수학자 G.H. Hardy(하디-바인베르크 평형의 그 Hardy 맞습니다)는 1926년에 아주 직설적으로 말합니다.

"나는 Tripos를 개혁하고 싶은 것이 아니라 없애 버리고 싶다."

"I do not want to reform the Tripos but to destroy it." (Hardy, 1926)


🩺 4부. 의과대학에 옮겨붙다

18-19세기 의과대학의 평가는 학업 마지막에 치르는 비공개 시험과 학위논문(inaugural thesis) 공개 발표 정도였습니다. 교육과정 중간에 학생을 등급으로 나누고 서열화하는 일은 없었습니다.

그런데 대학 편입과 함께 상황이 바뀝니다. 1900년 노스캐롤라이나대 의학부 학장 R.H. Whitehead의 진술이 이 변화를 잘 보여줍니다.

"학문적 방식이 지배하고, 학업 수준은 높으며, 의과대학생은 다른 학생들과 동일한 일반 규율의 적용을 받는다."

"...academic methods prevail, the standard of scholarship is high, and the medical student is subject to the same rules of general discipline with his academic fellows." (Whitehead, 1900)


문제는 이 구조가 임상 현장에 필요한 지식과 술기를 기르는 방향으로 설계된 적이 없다는 점입니다. 오히려 암기 편중을 정당화하고 가속했습니다. 1908년 Murray Galt Motter는 요약집과 시험 대비서가 넘쳐나는 현실을 이렇게 꼬집었습니다.

"단순 암기법이 얼마나 널리 길러지고 있는지를 보여 주는 딱한 증거다."

"...are sorry evidence to the extent to which the mere memory method is being cultivated." (Motter, 1908)


Flexner 본인도 나중에 후회 비슷한 말을 남깁니다. 대학 환경을 그토록 밀어붙였던 사람이 1925년에 이렇게 씁니다.

"우리의 현재 족쇄는 형편없는 의과대학들이 부적격한 학생들에게 '더 나은' 교육을 제공하도록 강제하기 위해 벼려진 것이었다."

"...our present fetters were therefore forged in order to compel wretched medical schools to give unfit medical students a 'better' training." (Flexner, 1925)


그리고 인턴 선발도 곧 시험 점수 중심으로 굳어집니다. 1899년 시카고 카운티병원의 선발 방식을 두고 Bayard Holmes는 필기시험만으로 전문가적 능력을 재는 것은 전적으로 부적절하며, 지원자의 건강, 도덕적 자질, 이전 임상 경력이 완전히 배제된다고 지적했습니다.


📉 5부. 성적은 좋은 의사를 예측하지 못한다

1960년대에 들어 실증 연구가 나오기 시작합니다.

  • Price 등(1964): 학점으로 측정한 형식 교육에서의 수행은 의사로서의 수행과 관련된 요인들과 "거의 완전히 독립적"(almost completely independent)이라는 결론.
  • Geertsma & Chapman(1967): 문자 등급과 석차는 학생이 의사의 역할과 기능을 향해 나아가는 진전을 적절히 대변하지 못한다는 지적.

정신건강 이슈는 더 오래된 이야기입니다. 1832년 Daniel Drake는 이미 의과대학생의 소화불량, 두통, 심계항진, 무기력을 언급했고, 1864년 Samuel Chew는 시험 전 24시간 이상 잠을 못 자고 불면, 두통, 현훈, 사고 혼란, 기억력 저하를 겪는 학생을 기술했습니다. 1937년 Strecker 등은 정신과의사 4명의 분석 결과 졸업반 학생의 46% 이상이 상당한 수준의 신경증적 부담을 지고 있다고 보고했고요.


그런데 여기서 저자들이 짚는 지점이 날카롭습니다. 당시 대응은 학습 환경을 바꾸는 게 아니라 학생 개인에게 해결을 맡기는 쪽이었습니다. Drake는 절제된 생활과 야외 운동을, Chew는 무리한 노력을 삼가라고 권했죠. 90년이 지난 지금도 구조를 문제 삼기보다 학생의 회복탄력성을 주문하는 방식, 어딘가 익숙하지 않으신가요?


📌 6부. 그래서 지금은

현재 미국 의과대학 155곳 중 약 84%가 필수 임상실습에서 어떤 형태로든 등급식 평가를 사용하고 있고, 이 비율은 오히려 늘고 있습니다.


저자들은 두 가지 해석을 제시합니다.


  • 하나는 USMLE Step 1의 pass/fail 전환 이후 변별 수단이 사라지면서 다른 대안(WBA, EPA, holistic review, programmatic assessment)을 쓰기 어려워 등급제로 회귀했다는 해석.
  • 다른 하나는 애초에 등급제의 기원이 이렇게 허술하다는 사실 자체가 인식되지 않았기 때문이라는 해석입니다.


이 논문에서 가장 핵심적인 한 문장을 꼽으라면 저는 이걸 고르겠습니다.

"등급식 평가는 향후 훈련과 진료에서의 성공에 요구되는 준비도, 신뢰가능성, 숙련도에 잘 맞지 않는 대리지표다."

"Tiered grading is an ill-fitting proxy for the readiness, trustworthiness, and mastery" required for success in future training and practice. (Smith & Piemonte, 2026)


🔭 7부. 저자들이 제안하는 다음 단계

정리하면 이렇습니다.

  1. 필기시험 자체를 없애자는 게 아닙니다. 필기시험은 학생이 자신의 성취와 진전을 확인하는 도구이고, 그 자체로 학습 경험이 될 수 있습니다. 문제는 필기시험 결과에 근거한 등급식 서열화입니다.
  2. WBA는 새로운 아이디어가 아닙니다. 1911년 존스홉킨스의 Lewellys Barker는 학생들이 소그룹으로 병동에서 일하고 선임 의사가 직접 관찰해야 한다고 했습니다. 그 의사들은 학생 및 전공의와 긴밀히 접촉하며 "통제하고, 비판하고, 검토하고, 제안하고, 격려해야"(controlling, criticizing, reviewing, suggesting, encouraging) 한다고요. WBA의 핵심 요소가 100년 전에 이미 서술돼 있었던 셈입니다.
  3. 인증평가 기구를 지렛대로. LCME가 USMLE 합격률로 교육과정 효과성을 측정하는 방식은 결국 시험 점수 중심 문화를 재생산합니다. 저자들은 일차의료 진출 졸업생 수, 의료취약지 근무 졸업생 수 같은 지표를 대안으로 제안합니다.
  4. Programmatic assessment로의 전환. 잦은 피드백, 다양한 평가 방법의 통합, 코칭, 그리고 비례성(고부담 결정은 충분한 근거로 뒷받침되어야 한다는 원칙). 저자들은 이것이 오히려 도제교육 시절 스승이 직접 관찰하며 임상추론을 길러 주던 역사적 뿌리로 돌아가는 길이라고 봅니다.
  5. 그리고 저자들의 바람 하나. "기말고사(final exam)"라는 용어를 의학교육에서 은퇴시키자는 것입니다. 의사의 경력에서 학습이 "최종"인 시점은 없으니까요.
  6. 마지막으로, 교수들에게 전하는 안심의 메시지가 있습니다. 등급제에서 벗어나는 것은 학생 평가의 발전 과정에서 극단적인 단절이 아니라, 애초에 등급제가 제대로 검증된 적이 없었다는 사실을 인정하는 일이라는 겁니다.

💭 읽고 나서 든 생각

이 논문은 실증 연구가 아니라 Observations 형식의 역사적 논평입니다. 그래서 "등급제를 없애면 이렇게 된다"는 인과적 근거를 기대하면 아쉬울 수 있습니다. 미국 맥락 중심이라는 한계도 분명하고요.


그럼에도 이 논문이 유용한 이유는 논쟁의 프레임을 바꾸기 때문입니다. 보통 우리는 "등급제를 없앨 만큼 충분한 근거가 있느냐"고 묻습니다. 그런데 이 논문은 방향을 뒤집습니다. 애초에 등급제를 도입할 만한 근거가 있었느냐고요. 기본값(default)이 무엇인지, 입증 책임이 어느 쪽에 있는지가 달라지는 질문입니다.


Kuper 등의 표현대로 역사는 "의학교육의 많은 부분이 구성된 것이고 따라서 변경 가능하다는 점을 보여 주는 효과적인 방법"입니다. 익숙한 것이 곧 타당한 것은 아니라는 얘기죠.


우리 맥락에서도 생각해 볼 지점이 있습니다. 임상실습 성적을 상대평가로 산출하는 관행, 전공의 선발에서의 성적 활용, 그리고 최근의 pass/fail 논의까지. 우리는 이 관행들을 언제, 왜, 어떤 근거로 도입했는지 스스로에게 물어본 적이 있을까요. 아마 대부분은 미국과 일본을 거쳐 들어온 대학 관행의 유산일 가능성이 큽니다. 그렇다면 우리도 같은 질문을 던져야 할 것 같습니다.


서론 (Introduction) 

학술의학의 복잡한 쟁점들 가운데 학생 사정(student assessment)과 평가(student evaluation)를 적절히 사용하고, 그 형식을 정하며, 적용하는 일은 특히 어렵다. 이는 사정과 평가가 의료교육자에게, 환자 진료, 자기 돌봄, 전문직 발달에 평생 헌신하는 데 필요한 기술, 추진력, 끈기를 갖춘 다양하고 협력적이며 회복탄력적인 의사 인력을 길러내고 있다는 확신을 주어야 하기 때문에 더욱 그러하다. 사정과 평가는 의과대학생의 학습, 역량 보장(competency assurance), 대중의 신뢰(public trust)에 필요하다는 점이 널리 받아들여지고 있다.1 사정과 평가는 끊임없이 변화하는 보건의료 환경에서도 타당하고 신뢰할 수 있어야 하며, 의과대학생이 장차 봉사하게 될 대중에게도 의미가 있어야 한다. 의학교육을 위해 개발되고 사용되는 사정도구(assessment instruments)와 이에 근거한 후속 평가가 잠재적으로 서로 경합하는 이러한 요구를 충족하지 못하는 정도는, 의과대학생의 사정과 평가가 어떤 형식을 취해야 하며 어떻게 적용되어야 하는지를 둘러싼 논쟁의 토대가 되어 왔다. 이 점에서 단계형 성적평가는 전형적인 논쟁 사례라고 할 수 있다.2


이러한 복잡성과 어려움을 더하는 요인에는 ‘사정(assessment)’, ‘평가(evaluation)’, ‘성적평가(grading)’라는 용어의 다양한 사용방식과 해석이 있다.3 이 논의에서 우리는 


  • ‘사정’을 학습자의 숙달도(proficiency)에 대한 관찰을 뜻하는 용어로 사용한다. 이는 대개 필기시험이나 선다형 문항시험(multiple-choice question examinations), 또는 관찰 가능한 술기의 성공적 수행을 기술한 체크리스트 등의 도구를 사용하는 것과 관련된다.
  • ‘평가’는 사정자료에 근거해 학습자에 관하여 내리는 해석과 판단을 뜻한다. 이는 대개 안전하고 효과적인 의료실무에 필요한 임상지식, 의사소통기술, 프로페셔널리즘(professionalism) 등의 영역에서 역량을 판정하는 것으로 나타난다. 평가는 규준참조 패러다임(norm-referenced paradigm)으로 더 확장될 수 있다. 이 평가 패러다임에서는 학습자가 역량을 범주적으로 입증하는 데 그치지 않고, 동료들의 수행과 비교되어 추가로 분류된다.
  • ‘성적평가’라는 용어는 학습자에 대한 사정과 평가를 토대로 의사결정을 내리는 행위를 가리킨다. 성적평가는 일반적으로 의학교육과정의 더 높은 단계로 진급하는 결과로 이어진다. 이 글에서는 단계형 성적평가에 초점을 맞추며, 이를 규준참조 사정과 평가에 근거하여 학생을 평정(rating), 순위화(ranking), 또는 분류(sorting)하는 행위로 간주한다.


대부분의 학술의료기관에서 학생 사정과 평가는 여전히 학생끼리 규준참조 패러다임에 따라 비교하는 전통적 학문 지향성을 유지하고 있다. 다시 말해 수행 수준을 구별하기 위해 학생을 여러 범주로 순위화한다. 이 범주는 다양한 형식으로 표현되며, 문자등급(letter grades), 숫자점수(numeric scores), 그리고/또는 ‘통과(pass)’, ‘우수통과(high pass)’, ‘최우수(honors)’ 같은 질적 기술어(qualitative descriptors)를 포함할 수 있다. 이는 임상실습(clerkship) 학년에서 가장 두드러진다.4 학생의 단계형 성적평가는 기본의학교육(undergraduate medical education, UME)에서 졸업후의학교육(graduate medical education, GME)으로 이행하기 위한 전공의 선발(residency selection) 과정의 필수 구성요소로 설명되어 왔다.5 또한 의과대학생의 학습과 수행을 촉진하는 동기요인으로도 제시되어 왔다.6,7 그러나 이러한 규정은 단계형 성적평가가 학생의 스트레스와 불안, 번아웃, 집단 응집성 저하, 경쟁 심화, 과소대표 소수집단(under-represented minority) 학생의 불리함과 연결된다는 근거를 부차화하거나 심지어 무시한다.8–11 따라서 기관들이 단계형 성적평가를 넘어 다른 형태의 사정과 평가로 전환하기를 주저하는 것은 당혹스럽고 우려스럽다.


성적평가가 기반을 두는 사정 및 평가 관행을 포함하여 의과대학생 성적평가의 역사적 발달을 탐색하면 이러한 쟁점을 더 잘 이해할 수 있다. 역사적 관점은 현재의 쟁점과 논쟁을 그것이 출현하고 발달한 맥락 속에서 바라볼 수 있게 한다. 더욱이 역사적 관점은 “의학교육의 많은 부분이 구성된 것이며, 따라서 변화할 수 있다는 본질을 보여주는 효과적인 방법”이 될 수 있다.12 (p.e850) 의학교육 개선에 대한 고려의 폭을 넓히는 일은 전문직적 겸손(professional humility)과 지속적 변화에 대한 개방성을 촉진할 수 있다.13


초기 및 현대 미국 의학교육의 역사를 학술적으로 개괄한 문헌이 존재한다.14–16 이 문헌들은 사용된 사정방법을 언급하지만, 의과대학생 성적평가의 역사적 발달과 진화를 구체적으로 탐색하지는 않는다. 사실 역사적 서술은 단계형 성적평가를 의과대학생 교육에서 당연히 전제되고 필요한 특성으로 취급하면서, 이 평가형식이나 다른 사정·평가 형식의 실제 기원을 거의 고려하지 않는 것으로 보인다. 학부교육(baccalaureate education) 과정에서 대학생 성적평가의 역사적 경향을 요약한 문헌고찰17–19도 존재하지만, 의과대학생이나 다른 대학원 수준 학생의 사정을 탐색하지는 않는다. 의학 학습자 사정의 최근 경향20,21은 문헌에 기술되어 있지만, 이 연구들도 단계형 성적평가의 역사적 출현을 구체적으로 탐색하지 않는다. 의과대학생을 사정하는 가장 효과적인 방법을 둘러싼 현재의 논의에 기여하고자, 우리는 미국 의과대학생 사정과 평가의 역사를 간략히 검토했던 이전 연구2를 확장하고자 한다. 이 ‘관찰(Observations)’ 논문에서 우리는 미국 의학교육에서 단계형 성적평가의 뿌리와, 그 뿌리가 오늘날 의학교육에서 우리가 마주한 가장 시급한 쟁점 가운데 일부를 어떻게 계속 지탱하고 형성하는지를 구체적으로 탐색한다.

미국의 초기 의학교육 (Early medical education in the US) 

미국 의학교육의 발달은 잘 기록되어 있다.14–16 초기 도제식 교육(apprenticeship-based education)에서 공식적인 대학 기반 교육(university-based education)으로의 전환은 특정한 시점을 경계로 일어난 것이 아니라, 지리적 여건, 영리 사립 의학교육(proprietary medical education)의 흥망, 의료실무의 질에 대한 대중의 불만, 19세기와 20세기를 특징짓는 과학지식 기반의 급속한 확대 등 국가적·지역적 영향에 의해 형성되었다. 현대 의학교육의 역사적 발달을 심층적으로 검토하는 것은 이 논문의 범위를 벗어나지만, 의과대학생이 과거와 현재에 언제, 어떻게, 왜 사정되고 평가되었는지에 관한 논의에 정보를 제공하기 위해 몇 가지 주요 지점을 아래에 개괄한다.


의학 도제교육, 군 의료 경험, 유럽에서의 수련을 모두 거친 John Morgan은 1765년 아메리카의 영국 식민지에 이상적인 의학교육 형태를 제시한 중요한 논문을 출판했다.22 그는 의학교육이 도제교육을 넘어 공식화되고 대학 교육과 동일한 원리에 기초해야 한다고 주장했다.23 Morgan은 자신이 제안한 의과대학에 구체적인 사정·평가 체계를 명시하지는 않았지만, 학위 수여 전 엄정한 판단이 적어도 가치 있으며 어쩌면 필수적이라고 분명히 생각했다. “그러므로 합당한 보상으로 가치를 구별하고 진정한 공로에는 마땅한 영예를 수여하도록 힘쓰자. 이는 교육기관을 완전하게[원문 표기: compleat] 만들고 학생들에게 가능한 모든 격려를 제공할 것이다.”22 (p. 36) Morgan의 선견지명 있는 구상은 당시 어느 정도 회의적인 반응을 받았지만, 여러 유력 대학은 해당 교육기관의 학문 원리와 행정구조에 기초한 의학부를 설립했다.24 대학 입장에서 의학부의 존재는 학문적 명성을 높이고 학생에게 매력적인 전문직 진로를 추가했다. 또한 대학 교수진을 이루기 시작한 신흥 학술 과학자들에게 자연스럽고 실용적인 초점을 제공했다.


19세기에는 대학 기반 의학부와 별개인 독립적 영리 사립 의과대학이 미국에 출현하면서 의심스러운 형태의 학생 사정과 평가도 함께 등장했다.25,26 이 학교들은 의문스러운 입학 기준, 임의적인 교육과정, 제각기 다른 수학기간, 흔히 교육과정 말미의 단 한 차례 시험만을 포함하는 모호한 졸업요건을 특징으로 했다.15 신규 졸업생이 이후에 얻게 되는 직업적 평판이 그 역량을 충분히 입증하는 것으로 여겨졌으며, ‘상류사회’ 고객군을 확보하는 것은 전문직적 성취의 증거가 되었다.15 학업 실패는 드물었고, 교수진의 단순 과반수 투표로 졸업이 결정되었다. 의학교수들은 의과대학생의 등록금 수입에 의존했고 교수라는 지위로 직업적·사회적 평판이 높아졌으므로, 학생이 학교를 떠나는 이유는 학업성취 부족보다 등록금을 내지 못해서인 경우가 훨씬 많았다.27 교육자들이 의과대학생을 낙제시키면 수입을 잃을 뿐 아니라, 의학학위를 가장 쉽고 저렴하고 빠르게 취득할 방법을 찾는 예비 학생의 반감을 살 수 있었으므로 당연히 낙제시키기를 꺼렸다. 대학과 관계를 유지한 의과대학조차 엄격한 학문적 기준을 보장하지는 못했다. 실제로 일부 대학 기반 의학부는 명목상으로만 모체 대학과 연계되어 있었다.28 이처럼 미약한 대학과의 연계는 “교육학적 의미에서 거의 가치가 없는 것”으로 평가되었다.27 (p. 764)


1847년 미국의사협회(American Medical Association)가 학문적 기준을 강화함으로써 의료인의 대중적 인식, 사회적 지위, 전문직적 위상을 높이라는 최초의 과업을 부여받으면서 영리 사립 의과대학의 폐지가 주요 목표가 되었다.29 대학 기반 의학교육과 Morgan의 원래 구상이 우세해진 것은 기존 의과대학이 대학과 공식적으로 연계되거나 대학이 자체 의학교육 부서를 설립한 결과였다.28 1910년 Abraham Flexner가 카네기 교육진흥재단(Carnegie Foundation for the Advancement of Teaching)에 제출한 보고서(‘Flexner 보고서’)30는 의학교육이 대학의 환경, 문화, 영향권으로 전환되는 과정을 가속한 현대적 변곡점으로 널리 인정된다.15 이는 의학 수학과정 이수 후 주 면허요건(state licensure requirements)이 만들어진 시기와 일치했다.31 이는 안전하고 효과적인 진료를 제공할 수 없는, 제대로 사정되지 않았고 자격이 부족하며 무능한 의료인이 과잉 배출된 데 대한 대중의 자연스러운 대응이었다.


의학교육이 비구조화된 도제교육에서 대학의 공식적 환경으로 전환되면서, 의과대학생의 사정과 평가는 아마도 당연하게 대학 학습자를 평가하는 특성을 띠게 되었다. 미국 의과대학에서 단계형 성적평가가 출현한 과정을 이해하려면, 미국의 학사과정 대학에서 그것이 언제, 어떻게, 왜 발달했는지를 검토하는 것이 유용하다. 대학과 의과대학의 사정 및 평가에 관한 전반적인 연대기를 ‘한눈에’ 볼 수 있도록 표 1에 제시했다.

초기 미국 대학의 학생 사정
(Student assessment in early US colleges and universities)
 

처음에는 학사과정 학생이 ‘졸업시험(leaving exam)’ 또는 ‘학위시험(degree exam)’을 성공적으로 치러 학위를 받는 것으로 학업성취를 표시했다.17 Harvard와 Yale 같은 대학은 졸업 전에 졸업시험을 시행하고 척도체계(scale system)에 따라 졸업생 대표(valedictorian)와 차석 졸업생(salutatorian)을 선발했다.17 그러나 학생의 수학과정 말미에 단 한 번 치르는 이 시험은 시험관의 편향이 개입하기 쉬웠다. 시험관은 주로 대학의 튜터(하급 교수), 교수, 이사회 구성원이었다.17 이들은 식민지와 초기 미국 사회의 계급 구분을 영속시키기 위해 학생 가문의 세습 귀족성과 저명 동문의 배경을 의식했을 가능성이 크다.31 이러한 엘리트 배경의 학생은 자연스럽게 특권의식을 느끼고 수행이나 출석과 관계없이 학위를 받을 것으로 기대했으며, 일부는 최종 사정 자체를 완전히 피하기도 했다.32 대학이라는 협소한 울타리 밖의 시험관을 추가하고 시험관 수를 늘린 것은 학생 수행에 대한 최종 평가에서 교수진 편향을 줄이려 한 초기 시도의 사례였다.17

표 1. 미국 의학교육 사정 및 평가의 연대기 (Timeline of assessments and evaluations in U.S. medical education) 

시기 사건
1600–1800 도제식 의학교육(apprenticeship medical education)
1650–1800 수학과정 말미에 대학 ‘졸업시험(leaving exams)’ 시행
1765 John Morgan이 엄정한 학생 사정을 포함한 공식적 의학교육을 기술
1700–1800 Cambridge의 Tripos 경연이 유럽 대학과 미국의 단계형 성적평가를 촉진
1785 Yale University가 학사학위 후보자의 수행 순위를 도입
1750–1850 의학학위 수여 전 유일한 평가로서 의학 수학과정 말미에 ‘취임논문(inaugural thesis)’이 등장
1800–1900 모호한 졸업요건을 가진 영리 사립 의과대학의 증가
1847 의학교육 기준 강화를 위해 미국의사협회 설립
1884 Mt. Holyoke College가 문자등급 체계를 도입
1910 Flexner 보고서가 의학교육의 대학 환경 편입을 가속
1900 의학교육에서 단계형 성적평가의 역할에 관한 우려가 등장
1900–1920 미국 대학 대부분이 문자등급을 채택
1900–1930 대학에서 단계형 성적평가에 대한 초기 유보가 등장
1960–1970 성적과 의사 수행 간 상관관계가 부족하다는 초기 우려가 의학교육계에서 등장
현재 미국 의과대학 155개교 중 약 84%가 필수 임상실습에서 어떤 형태로든 단계형 성적평가를 사용하며, 그 비율은 증가 추세임


이 표는 중요한 시기와 사건을 대표하여 제시한 것이며, 망라하려는 것이 아니다.


단계형 성적평가는 학계 인사들이 유럽, 특히 영국 대학을 방문하며 경험한 교육모형을 따라 미국에 유입되었을 가능성이 크다.33 18세기 Cambridge University에서는 Tripos라는 수학 경연이 만들어졌으며, 그 상에는 안정적인 학문직과 연금을 통한 경제적 안정이 포함되었다.33,34 Tripos는 수상자를 가장 정확하고 공정하게 가려낼 수 있도록 채점되었다. 일반적으로 점수체계는 수행을 장려하고 경쟁을 자극하며 탁월한 성취를 인정하는 것으로 여겨졌다.33,35–37 중요한 점은 Tripos가 처음에는 자발적으로 참여하는 경쟁대회였고 그 점수가 학위 수여 결정에 반영되지 않았다는 것이다. 그럼에도 이러한 점수화는 결국 유럽 대학 환경 전반으로 확장되었고, 단계형 성적평가가 유럽 대학에서 확대되면서 미국 교육체계에도 편입되었다.37,38 단계형 성적평가는 대학의 학문환경과 동의어가 되었고, 의무교육(compulsory schooling)의 등장과 함께 결국 초등·중등·고등교육 전반으로 확산되었다.39


미국 대학에서 최초로 학생을 단계별로 순위화한 사례는 18세기 후반 Yale College에서 나타난 것으로 보인다.17 Yale 총장이던 Ezra Stiles는 1785년과 1786년에 학생들이 시험을 치르기 전에 대학을 떠나면서도 학위를 받을 것으로 기대하는 현실에 주목하고, 학생 규율과 학문적 엄격성을 높이고자 했다.32 Stiles는 학생들이 떠나기 전에 시험을 치를 수 있도록 1785년 봄 최종시험 일정을 앞당겼다. 또한 학생을 학업성취에 따라 optimi, secondary optimi, inferiors, pejores의 네 범주로 순위화했다.17,33,38 이 네 범주 체계는 벨기에 Louvain University에서 개발된 유사 체계(rigorosi, transibilies, gratiosi, 그리고 명칭이 없는 네 번째 하위 성취 집단)17와 영국의 체계(Honor Men, Pass Men, Charity Passes, 그리고 “이름이 공표되지 않았기 때문에 익살스럽게 ‘언급할 수 없는 자들[Unmentionables]’이라고 부를 법한” 집단17 (p. 108))를 모방했다. Yale 학생을 순위화한 데 어느 정도 교육학적 근거가 있었을 수 있으나, 다른 미국 학교에서는 이전에 이런 일이 없었다. Stiles는 성취가 낮은 학생이 자신의 상대적으로 낮은 수행을 알게 되었을 때 경험하는 굴욕감이 이후 시험을 앞두고 더 열심히 공부하도록 자극하기를 기대했다.32 주목할 점은 Yale 학사과정 학생들이 이 새로운 시험일정과 수행 순위화의 대상이 되리라는 사실을 깨닫자, 1786년 4월 나흘 동안 폭동을 일으켜 창문에 벽돌을 던지고 튜터의 집 문을 부수려 했다는 것이다. Stiles의 집은 피해를 면한 것으로 보인다.32


학생에 대한 평정과 순위화는 다른 대학기관으로 확대되었는데, 특히 사회·경제적으로 더욱 다양해진 학생 집단으로 인해 학생 상호 간, 학생과 교수진 간, 학생과 지역주민 간 긴장과 폭력이 발생하던 북동부에서 그러했다. 이러한 학문적 환경에서 단계형 성적평가는 학생의 학업행동에 영향을 미치고, 중요하게는 사회적 행동을 통제하기 위한 방법으로 출현했다. 역사가 David F. Allmendinger는 다음과 같이 서술했다.


  • 일상 학업에 점수를 부여하고, 교과 수행에 따라 학생의 순위를 정하고, 우수자 명부를 만들고, 부모에게 정기적으로 보고하는 개혁은 규율 절차로 도입된 것이지, 미국에서 학문의 수준을 높이기 위한 수단만으로 도입된 것이 결코 아니었다.40 (p. 82)


학업성취에 근거해 학생을 평정하고 순위화하는 것은 강건하고 타당한 교육학적 원리라기보다 굴욕과 수치심을 통해 행동규율을 심어주는 방법으로 출현했다.41 Harvard를 포함한 여러 대학은 학생 순위를 정할 때 처음에는 100점 척도를 사용했다. Mount Holyoke는 ‘A’에서 ‘E’까지 각 문자가 백분율 점수를 나타내고 ‘E’가 낙제를 뜻하는 문자등급 체계를 최초로 채택한 대학으로 알려져 있다.33 1884년에는 처음 다섯 문자와 연계된 백분율을 조정하면서 ‘F’가 이 성적체계에 추가되었다.17 ‘E’는 시험을 다시 치를 수 있는 낙제등급이었고, ‘F’는 과목을 재이수해야 하는 낙제등급이었다. 문자등급을 사용하는 단계형 체계가 학업성취를 층화하는 더 효율적이고 정확한 방법이라는 인식과 함께,33 1930년 무렵에는 대부분의 대학이 5단계 문자등급을 사용했으며 ‘E’는 사라졌다.17


미국 교육체계가 단계형 성적평가를 비교적 빠르게 채택했음에도, 그 한계와 신뢰할 수 없음은 일찍부터 인식되었다. 이는 초등·중등교육뿐 아니라 대학에서도 지적되었다.39,40,42 대학에서 단계형 성적평가를 둘러싼 초기의 곤란한 경험과 관찰된 부정적 영향은 오늘날 의학교육에서 나타나는 어려움을 예고했다.

대학 수준에서 단계형 성적평가에 대한 유보
(Reservations about tiered grading at the collegiate level)
 

대학 내·대학 간 단계형 성적평가의 일관성과 표준화가 부족해 학생과 교수진 사이에 경쟁, 혼란, 심지어 적대감까지 생겼다. University of Missouri 최초의 심리학 교수였던 Max Meyer는 단계형 성적평가의 신뢰도 부족을 일찍부터 비판했다. 그는 다음과 같이 지적했다. “그 결과 교수진과 학생 모두가 서로를 의심의 눈초리로 바라본다. 이러한 태도가 일체감에 해롭다는 사실은…아무리 피상적으로 관찰하는 사람에게도 분명하다.”43 (p. 661) 단계형 성적평가는 초등·중등교육 수준에서도 의심스럽지만 고착된 교육의 특성으로 등장했고, 주관적이고 신뢰할 수 없으며 불공정하다는 지적을 받았다.39 이러한 한계는 때때로 교수(teaching)의 도덕적 차원으로 표현되었다. 미국심리학회 제4대 회장 J. McKeen Cattell은 1910년 Harvard Teachers’ Association 연설에서 다음과 같이 말했다. “학생들에게 석차 경쟁을 하도록 설득하여 학업을 향상하려는 제안은 무익하고 어느 정도 비도덕적이다…경쟁을 통해 따분하고 보람 없는 학업을 흥미롭게 만들려는 것은 자동차 앞에 냄새를 두는 격이다.”44 (p. 379)


역설적이게도, 학업 수행을 장려하는 수단으로 단계형 성적평가를 일찍부터 지지한 사람들도 그것이 미국 교육에서 허술하게 출현했다는 점을 인정했다. 교육심리학자 S. S. Colvin이 1912년에 기술했듯, 단계형 성적평가의 근거 자체는 “…지적으로 이해된 적도, 일관되게 운영된 적도 없었고…”, “…그것을 고안하거나 운영한 사람들의 선견지명 때문이 아니라 우연히 생겨났다.”35 (p. 561)


단계형 성적평가의 영감 가운데 하나였을 것으로 추정되는 Cambridge Mathematical Tripos의 학생 수행 층화조차,33,34 1926년 수학자 Godfrey Harold Hardy(‘Hardy-Weinberg’ 법칙의 Hardy)의 도전을 받았다. Hardy 자신도 Cambridge 학생 시절 Tripos에 참가했지만, 이후 수학경연과 다른 학문분야에서 대학생의 순위를 매기는 것이 초래할 수 있는 해악을 깨달았다.


  • …나는 [Tripos] 체계가 원리상 해롭고, 그 해악은 흔히 개혁이라 부르는 것으로 해결하기에는 너무 근본적이라는 견해를 고수한다…나는 Tripos를 개혁하려는 것이 아니라 없애려 한다. 그리고 Tripos가 특수한 사례인지, 아니면 내가 말한 내용이 다른 모든 고등 우등시험(high-grade honours examinations)에도 적용되는지 묻는다면, 내가 아는 한 그렇다고 답할 수밖에 없다.45 (p. 144)


성인학습(adult learning)에 관한 새로운 원리가 출현하면서 대학의 정통적 관행이 지닌 한계는 더욱 분명해졌다. 현대 성인교육학(adult pedagogy)의 가장 초기 주창자로 볼 수 있는 Eduard Lindeman은 1926년에 “성인학습자란 권위적이고 관습적인 교육기관의 경직되고 타협 없는 요구에 의해 지적 열망이 촉발될 가능성이 가장 낮은 바로 그 사람들”이라고 지적했다.46 (p. 28) 그럼에도 대학 기반 의학교육이 발전하면서 대학 문화, 환경, 학생 사정·평가의 속성이 의학교육과정에 적용되었다.47,48

의과대학 학생 사정 및 평가의 전환
(The transition of student assessment and evaluation in medical schools)
 

대학이 의과대학·의학교·의학부를 흡수하거나 설립하면서, 대학 학사과정 학생에게 사용하던 사정방법과 단계형 성적평가 패러다임은 의과대학생의 사정과 평가를 크게 형성했다. 역설적이게도 의학교육 개혁을 위한 전문직적 추진력이 강했고 Flexner 보고서 이후에는 대중의 관심도 높았지만, 단계형 성적평가가 의과대학생 사정과 평가의 지배적 형식으로 전환된 과정은 다소 은밀하게 진행되었다. 18세기와 19세기의 여러 의과대학에서 의과대학생 숙달도에 대한 유일한 사정과 평가는 학업 말미에 이루어졌으며, 의과대학 교수진이 실시하는 비공개시험과 학생이 자신의 ‘취임논문(inaugural thesis)’을 발표하고 방어하는 후속 공개시험으로 구성되었다.14,49 때로는 최고의 논문을 쓴 학생에게 상금이나 특별 표창을 주었지만, 논문의 질을 순위화한 것은 졸업 시점이었고 수학과정 중에는 아니었다. 따라서 교육과정 중 학생을 공식적으로 순위화하거나 평정하거나 분류하지 않았다.


의학의 실무에 필요한 능력, 술기, 전문직 속성을 판단하기 위해 의도적으로 고안된 교육학적으로 타당한 접근법이 아니라, 의학계의 단계형 성적평가는 대학 환경에 적응하는 과정에서 출현했다. 당시 University of North Carolina 의학부 학장이던 R. H. Whitehead는 1900년에 “…학문적 방법이 지배하고, 학문의 기준이 높으며, 의과대학생은 대학의 동료 학생들과 마찬가지로 일반 규율의 적용을 받는다”고 기술했다.47 (p. 523) 1920년대 중반이 되자 의학교육은 대학의 학문환경에 확고히 자리 잡았고, 대학 총장들은 의학교육의 그 위치를 강하게 옹호했다.50 미국 의과대학에서 단계형 성적평가에 대한 유보가 곧 나타났다.

의과대학의 단계형 성적평가에 대한 유보 (Reservations about tiered grading in medical school) 

Flexner 자신도 의학교육에서 대학 학문환경이 잠재적으로 억압적인 역할을 할 수 있음을 인식했다. 그는 영리 사립 의과대학을 없애기 위해 이러한 학문환경을 열렬히 장려했던 인물이기도 했다.51 최초 보고서가 나온 지 약 15년이 지난 1925년, Flexner는 의학교육의 상태를 성찰하며 “…따라서 현재 우리를 옭아매는 족쇄는 형편없는 의과대학이 부적합한 의과대학생에게 ‘더 나은’ 수련을 제공하도록 강제하기 위해 만들어진 것”이라고 지적했다.51 (p. 142) Flexner는 단계형 성적평가를 포함한 대학 환경이 의과대학생에게 미칠 해로운 영향을 예견했을지도 모른다. “…대학의 ‘학급정신(class spirit)’이 대학 의과대학에 침투했다…유능하게 지도를 받는 성숙한 학생은 ‘학교에서 바지를 입기 시작한 어린 학동’처럼 감시받을 필요가 없다.”30 (p. 76)


Flexner가 말한 ‘감시(policing)’는 제한적이고 일률적으로 고정된(lock-step) 의과대학 교육과정의 형식뿐 아니라, 단계형 성적평가, 암기를 강조하는 시험, 의과대학생의 학업행동 사이의 관계를 인정한 표현이었을 수 있다. Flexner 보고서가 배포되기 전인 1908년에도 Murray Galt Motter는 American Academy of Medicine 회의에서 발표한 논문에서 “퀴즈 요약집, 개요서, 시험 대비자료 등이 매우 많고 훨씬 더 큰 인기를 끄는 현실은 단순 암기법이 얼마나 조장되고 있는지를 보여주는 유감스러운 증거”라고 지적했다.52 (pp. 18–19)


이러한 비판에도 불구하고 단계형 성적평가는 일반적으로 의과대학생의 진전을 신뢰할 수 있게 ‘내부적으로’ 사정하고, 학생이 한 학교에서 다른 학교로 옮길 때 역량을 ‘외부적으로’ 전달할 수 있게 한다고 여겨졌다.33,53 또한 성적은 학생의 성취를 인정하고 좋은 수행을 유도하는 ‘당근’이라는 유인책(그 연장선에서 ‘채찍’이라는 억제책)을 제공하려는 것이었는데, 이는 대학 환경에서 보편화된 관행이었다.47 단계형 성적평가는 의과대학생의 학업 수행을 장려하여 의학의 전문직적 위상을 향상하는 방법으로 찬양되거나 적어도 용인되었다.


따라서 의과대학생은 규율과 학문 양 측면에서 당시 대학 학계에 지배적이던 철학을 위해 개발된 구인(construct)에 의해 평가되었다. 이 구인은 의과대학생이 장차 몸담을 임상실무 환경에 필요한 지식과 술기의 발달을 촉진하는 토대 위에서 개발된 것이 아니었다. 불행히도 이는 선망받는 병원 인턴십에 들어갈 의학 졸업생을 정할 때 총체적 선발과정(holistic selection process)보다 등급이 매겨진 시험점수를 더 중시하는 관행이 일찍부터 확대되는 데 기여했다.54 1899년 Chicago County Hospital의 인턴 선발과정을 논평하면서 의학교육자이자 외과의사·세균학자였던 Bayard Holmes는 다음과 같이 지적했다. “…전문직 능력의 검증 수단으로서 필기시험 체계는 전적으로 부적절하다…지원자의 건강, 도덕적 자질, 이전의 의학 관련 업무는 전혀 고려되지 않는다.”54 (p. 927)


의과대학 성적과 의사 수행 간 상관관계가 없음을 보여주는 의학교육 연구가 출현하면서 단계형 성적평가의 적절성에 대한 초기 의구심은 더욱 강해졌다.


  • 예를 들어 Price와 동료들은 1964년 의과대학 성적의 타당성에 대한 사정 결과를 보고하며, “…평균평점(grade-point average)으로 측정한 공식교육에서의 수행은 의사로서의 수행과 관련된 모든 요인으로부터 거의 완전히 독립된 요인으로 나타난다”고 지적했다.55 (p. 208)
  • 마찬가지로 University of Kansas의 Geertsma와 Chapman은 1967년에 “…전통적인 문자등급과 학급 내 숫자 순위는 의사의 전문직적 역할과 기능을 향해 의과대학에서 이루는 진전을 적절히 나타내지 못한다”고 지적했다.56 (p. 938)


더불어 의학교육의 스트레스와 그것이 의과대학생의 웰빙에 미치는 영향은 미국 의학교육의 초기부터 인식되었다.


  • Medical College of Ohio 교수였던 Daniel Drake는 1832년에 의과대학생이 “소화불량, 두통…심계항진, 건강염려증, 권태[무기력], 동요증[쉼 없는 신체 움직임], 안절부절못함, 그 밖의 신경과민 형태”에 취약하다고 언급했다.57 (p. 56) 그는 절제된 생활방식과 야외운동으로 이를 예방할 수 있다고 제안했다.
  • 1863년에 사망하기 전 University of Maryland 교수 Samuel Chew는 의과대학의 정서적 스트레스와 시험과정 사이의 연관성을 지적했다. 그는 “…불면, 두통, 현기증, 사고의 혼란, 기억력 감퇴, 그리고 신경계의 심각한 장애를 시사하는 여러 다른 증상”58 (p. 55)을 겪는 의과대학생을 묘사했다. 이 학생은 최종시험에서의 수행을 반복적으로 걱정했으며, 시험 전에 24시간 넘게 잠을 자지 않는 일이 흔했다. Chew는 그 학생에게 “지나치거나 조절되지 않은 노력”을 삼가라고 제안했다.58 (p. 56)


시험을 포함한 의과대학의 학문환경과 학생 정신건강 사이의 더 광범위한 연관성은 거의 90년 전에도 분명히 인식되었다.59,60 1937년 Strecker 등은 시험불안의 기여를 지적하며 “…네 명의 정신과 의사가 면밀히 분석한 결과, 한 대표적인 의과대학 최종학년 학생의 46%를 약간 넘는 수가 중대한 성격의 신경증적 장애를 겪는 것으로 나타났다면, 의과대학에 심각한 정신위생 문제가 존재하는 것”이라고 했다.60 (pp. 1228–9) 그러나 그들은 이에 기여했을 수 있는 교육환경의 속성을 다루기보다, 학생과 교수진의 긴밀한 관계가 불안과 스트레스를 완화할 수 있다고 제안했다.59 역사적으로 의과대학생의 웰빙과 정신건강에 대한 위협은 학문환경과 연결되어 있었다. 그러나 해결의 책임은 고통에 기여하는 학문환경의 속성을 비판적으로 검토하는 대신 학생 자신에게 부과되었다. 놀랍지 않게도 불안, 우울, 번아웃을 포함한 중대한 정서·정신적 고통의 위험은 오늘날 의과대학생에게도 지속되고 있다.8

역사적 관점의 현대적 관련성 (Contemporary relevance of historical perspectives) 

임상실습 학년에서 단계형 성적평가가 널리 사용된다는 사실은 그것이 현대 의학교육에 확고히 자리 잡았음을 보여준다. 현재 미국 의과대학 155개교의 약 84%가 필수 임상실습에서 어떤 형태로든 단계형 성적평가를 사용하며, 그 비율은 증가하고 있다.4 이처럼 두드러진 위상은 환자와 환자집단의 요구를 충족할 수 있는 의사 인력을 양성하는 데 단계형 성적평가가 효과적이고 타당하다는 견고한 역사적 토대가 있음을 시사할 법하다. 그러나 그러한 역사적 토대는 존재하지 않는 것으로 보인다. 임상실습 학년에서 단계형 성적평가 사용이 증가하는 추세는 직무현장 기반 사정(workplace-based assessments, WBAs), 위임가능 전문직업무(entrustable professional activities),61,62 지원자의 고유한 속성에 대한 총체적 검토(holistic review),63,64 프로그램화 평가(programmatic assessment)65 등 졸업후의학교육 지원자를 선발하는 다른 패러다임적 접근법이 사라졌거나 효과적으로 사용하기 어려워진 데 대한 대응일 수 있다. 또는 이러한 추세는 애초에 의과대학생을 위한 타당한 사정·평가도구로서 단계형 성적평가가 지닌 역사적 맥락과 의심스러운 기원을 인식하지 못한 결과일 수 있다. 오늘날 단계형 성적평가를 통한 의과대학생 평가는 의료실무의 다양한 차원에 대한 타당도에 초점을 맞추고 있지만, 의과대학생과 미래의 환자를 더 잘 섬기려면 우선 의학교육에서 단계형 성적평가의 역사적 토대 자체가 타당한지에 주목하는 편이 나을 수 있다. 단계형 성적평가는 향후 수련과 실무에서의 성공에 필요한 준비도(readiness), 신뢰가능성(trustworthiness), 숙달(mastery)을 제대로 대변하지 못하는 부적합한 대리지표(proxy)이다.


단계형 성적평가는 현대 의학교육을 여전히 괴롭히는 과학적 사실의 암기와 회상에 대한 과도한 의존을 정당화했으며—가속했다고 볼 수도 있다. 시험 수행 향상을 목표로 하는 학습보조자료와 시험 코칭이 교육과정에 넘쳐나면서 학습자의 탐구심은 효율성이라는 명분 아래 희생된다. 이에 대한 문제의식이 일찍부터(Flexner에게서조차) 있었음에도, 미국에서 대안적인 사정·평가 패러다임을 진지하게 고려하고 실행하려 하면 흔히 저항에 부딪힌다. 이는 학생 동기, 기관의 평판, 전공의 선발과정에 부정적 영향을 줄 것이라는 두려움 때문일 수 있다. 그러나 미국 의과대학 대다수의 임상실습에서 숙달학습(mastery learning)을 단계형 성적보다 계속 부차적으로 취급하면, 숙달학습의 달성 여부와 관계없이 시험 수행과 학급 순위에 지향된 학문적 사고방식이 영속된다. 그 결과 내재적 동기, 집단 응집성, 의사 인력의 다양성을 포함하여 의료실무에 중요한 다른 속성들은 과거에도 부정적 영향을 받았고 지금도 그러하다.


마지막으로 20세기 초 단계형 성적평가가 고착되면서 학생 사정과 학생 정신건강 사이의 연관성도 인식되었다. 그러나 이러한 인식은 의과대학생 사정과 평가의 목표와 올바른 형식을 비판적으로 검토하도록 촉진하기에 충분하지 않았다. 단계형 성적평가가 의과대학생의 스트레스와 불안, 번아웃, 집단 응집성 저하, 경쟁 심화, 의학계에서 과소대표된 학생의 불리함과 연관된다는 문헌이 발전하고 있음에도, 이러한 비판적 검토의 부재가 놀랍게도 계속되고 있다.8–11

미래에 정보를 제공하기 위한 과거의 탐색 (Exploring the past to inform the future) 

단계형 성적평가의 본래 의도 가운데 하나였던 학생의 사회적·학업적 행동에 영향을 미치는 수단으로서의 단계형 성적평가를 넘어서려면, 실제로 숙달학습과 더 나은 환자 결과(patient outcomes)로 이어지는 선택지를 탐색해야 한다. 이는 필기시험이 중요한 사정도구로 남아서는 안 된다는 뜻이 아니다. 필기시험은 의학교육에서 역사적으로나 현재에도 토대가 되는 역할을 한다. 사정의 한 형태로서 필기시험—가장 흔하게는 선다형 시험문항—은 학생이 의과대학 교육과정에서 자신이 이룬 성취와 진전을 파악할 수 있게 한다. 필기시험은 효율적인 지식 사정도구일 뿐 아니라 그 자체가 잠재적인 학습경험이기도 하다.66 비판적으로 검토해야 할 것은 주로 필기시험 결과에 근거한 단계형 성적평가이다.


직무현장 기반 사정(WBA)은 더 나은 환자 결과로 이어지는 임상역량을 사정하는 논리적인 방법이며, 실제로 100여 년 전에도 권장되었다. 1911년 Johns Hopkins Hospital의 내과부장이었던 Lewellys F. Barker는 학생이 병동에서 소집단으로 일해야 하며, 고참 의사가 학생의 전문직적 진전을 직접 관찰해야 한다고 지적했다. 그 고참 의사는 “직접 학생 및 하급 직원과 긴밀한 접촉을 유지하면서—통제하고, 비평하고, 검토하고, 제안하고, 격려해야 한다.”67 (p. 618) 표면적으로는 명령조인 이 역사적 서술은 임상환경에서 교수와 학습자 사이의 능동적이고 실질적인 관계를 묘사하며, 이는 WBA의 초석이다. 또한 이 서술은 현대의 ‘서브인턴십(subinternship)’을 예견한다. 이는 WBA에 적합할 수 있고 전공의 프로그램 책임자가 선발 목적으로 사용할 수 있는 교육적·임상적으로 의미 있는 경험이다.68


WBA와 더불어 전공의 지원자에 대한 총체적 검토는 지원자의 인품이나 기관 사명과의 적합성(mission fit)을 시사하는 속성을 사정하는 데 도움이 될 수 있다.63,64 그러나 전공의 선발에서 총체적 검토를 시행하려면 교수자, 학습자, 행정 인력의 시간과 자원이 더 많이 필요하며, 이러한 자원을 확보하기 어렵다는 점은 오래전부터 인식되어 왔다. Holmes는 1899년 전공의 선발에서 필기시험 결과만 강조하는 현실을 개탄하면서, 의학 졸업생에 대한 의무진의 더 총체적인 검토가 지닌 어려움도 인정했다.

  • “…[의무진은] 전적으로 필기시험만을 근거로 인턴을 선발하기로 했다. 지원자의 적합성과 능력을 검증하는 다른 모든 방법은 생각해보지 않았거나, 적용이 어렵다고 여겨져 제쳐두었거나, 비인격적인 방식으로 적용할 수 없다는 이유로 배제되었다.”54 (p. 927)

총체적 검토의 부담에도 불구하고 의과대학과 전공의 지원자 선발에서 그 사용은 증가하고 있다.63 그러나 일부 기관에서는 미국 의사면허시험(United States Medical Licensing Examination, USMLE)의 ‘절단점(cut-off)’ 같은 특정 지표를 충족한 뒤에야 총체적 검토가 이루어진다.63 USMLE Step 1이 범주형 합격-불합격 지표(categorical pass-fail metric)로 바뀌면서 학급 순위와 USMLE Step 2 점수 같은, 대안적이면서도 편의적인 선별·선발 기준을 찾으려는 움직임이 심화되었다. USMLE는 전공의 선발과정에서 지원자를 변별하기 위한 도구로 설계되지 않았으며 현재도 그러한 용도를 의도하지 않는다.69 그러나 전공의 수련프로그램 책임자는 여전히 USMLE Step 2 점수, 단계형 성적평가, 학급 순위 등의 지표를 사용해 전공의를 선발하며, 그 결과 기본의학교육 교육과정에서 이러한 지표에 대한 강조와 그로 인한 해로운 영향이 영속된다.70,71


기본의학교육에서 졸업후의학교육으로 이행할 때 단계형 성적평가와 학급 순위를 사용하는 것은, 모든 전문과목의 전공의 수련을 위해 총체적으로 교육받고 회복탄력적이며 다양한 지원자 풀을 강화할 수 있는 대안적 교육과정 설계를 의과대학이 탐색할 역량도 제한한다. 단계형 성적평가를 중단하고 준거기반(criterion-based) ‘합격-불합격’ 평가 패러다임을 확립한 곳에서는 학생들이 긍정적으로 반응했으며,72 교수진은 교육자이자 평가자로서 변화하는 자신의 역할에 호기심과 낙관을 보였다.73 단계형 성적평가를 사용하는 의과대학 출신 전공의를 프로그램 책임자가 더 선호하지는 않는다는 관찰은, 전공의 선발과정에 미칠 영향에 관한 우려를 어느 정도 완화한다.74


약 150년 전 잘 훈련된 의사를 보장하기 위해 면허요건과 의사면허시험 같은 주 법률의 개입이 등장했던 것과 유사하게,31 오늘날 의학교육합동위원회(Liaison Committee on Medical Education, LCME)와 졸업후의학교육인증위원회(Accreditation Council for Graduate Medical Education, ACGME) 같은 인증기구가 교육혁신을 촉진하고 기본의학교육에서 졸업후의학교육으로 이행할 때 시험점수, 학급 순위, 단계형 성적평가에 과도하게 의존하지 않도록 의미 있는 효율성을 창출하는 기준을 마련할 수 있을 것이다. 주 면허요건은 의학 ‘학위공장(diploma mills)’이 결국 사라지고 기본의학교육의 전반적 기준이 높아지는 과정을 가속했다.31 마찬가지로 인증을 통한 감독은 기본의학교육과 졸업후의학교육의 교육환경에 영향을 줄 수 있고 실제로 영향을 주며,75–77 기본의학교육에서 졸업후의학교육으로의 이행에 의미 있는 개혁을 일으키도록 활용할 수 있다.

  • 예를 들어 ACGME는 전공의·전임의 프로그램 졸업자의 전문의 인증시험(board certification) 합격률로 프로그램 효과성을 평가한다.78 따라서 프로그램 책임자는 이러한 시험에 불합격할 가능성이 가장 낮은 지원자를 선발하려 한다. USMLE 점수와, 그보다 정도는 덜하지만, 의과대학 성적이 전문의 인증시험 성공을 예측하는 데 도움이 되므로 프로그램 책임자는 전공의 선발과정에서 자연스럽게 이러한 지표에 초점을 맞춘다.
  • 마찬가지로 LCME가 의과대학 인증에서 USMLE 합격률을 교육과정 효과성의 측정치로 사용하면79 시험점수와 그 밖의 정량적 성공지표에 대한 과도한 의존이 영속된다. 

그러므로 ACGME와 LCME는 의과대학생과 수련생의 교육환경에 영향을 미치기 위해 교육효과성에 관한 대안적 측정치를 강조할 수 있다. 어쩌면 일차진료 전공의 수련에 진입하는 의과대학 졸업생의 수와, 의료취약 농촌 및 도시 지역에서 진료를 시작하는 전공의 프로그램 졸업생의 수에 주목하고 이를 강조하는 것이 학술의료체계가 봉사하는 인구집단에 더 의미 있는 대안적 효과성 지표가 될 수 있다.


이러한 역사적·현대적 쟁점을 모두 고려하여 우리는 몇 가지 ‘다음 단계(next steps)’를 제안한다.

  • 첫째, 학술의료센터와 교수진은 교육과정의 발전과 개혁을 고려할 때 미국 학생 사정과 평가의 역사적 뿌리를 참작해야 한다. 단계형 성적평가에서 벗어나는 전환은 학생 평가의 발전 과정에서 발생하는 극단적인 단절이 아니라, 의과대학생의 단계형 성적평가가 애초에 적절히 검증되지 않았음을 인정하는 것이라는 점에서 안심해도 된다. 이는 지역·권역·전국 수준의 발표와 기관 내·기관 간 대화를 통해 이루어질 수 있다.
  • 둘째, 현재 미국 전역의 의과대학에서 고려하거나 시행 중인 사정·평가 패러다임 가운데 프로그램화 평가(programmatic assessment)—필수 역량과 술기를 발달시키는 학습자의 진전을 포괄적·종단적으로 조망하기 위해 전체 교육프로그램에 걸쳐 여러 출처의 자료를 수집하고 분석하여 학생 학습을 평가하는 접근법—는 이 논문에서 제기한 여러 역사적 우려를 다루는 것으로 보인다.65 빈번한 피드백, 여러 사정방법의 통합, 코칭, 비례성(proportionality: ‘고부담’ 평가를 그에 비례하는 탄탄한 사정으로 뒷받침하는 것)을 포함한 프로그램화 평가의 특성은 임상추론(clinical reasoning)을 촉진하는 데 적합해 보인다. 역사적으로 의사 도제의 임상추론 능력은 의사 멘토의 지도와 직접관찰을 통해 촉진되고 평가되었다. 학생-교수 간 충분한 접촉을 갖춘 프로그램화 평가는 초기 미국 의사교육의 역사적 뿌리를 상기시키는 접근법이다. 이 접근법에는 더 많은 교수자의 시간과 노력뿐 아니라, 의과대학생에게 시의적절하고 진정성 있으며 의미 있고 효과적인 사정과 피드백을 제공하는 역량을 강화하기 위한 상당한 교수개발(faculty development)이 필요하다.65,73 임상실습 경험 말미의 평가는 여러 사정방법에 근거해야 하며, 모든 의학 전문과목에 공통으로 필요한 기본 임상술기를 개선할 기회를 포함해야 한다. 우리는 하나의 지향점으로서 의학교육에서 ‘최종시험(final exam)’이라는 용어와, 그러한 시험의 수행 결과에 따른 학생의 단계형 성적평가를 퇴장시키고자 한다. 의사 경력의 어느 단계에서도 학습은 결코 ‘최종’이 아니라고 믿기 때문이다. 프로그램화 평가를 향한 패러다임 전환은 의학교육 사정과 평가의 역사적 뿌리를 인정하는 것이며, 긍정적인 전진이다.

결론 (Conclusion) 

지난 250년 동안 의과대학생 수행에 대한 단계형 성적평가가 언제, 어떻게, 왜 진화했는지를 성찰하면, 학생과 그들이 돌보게 될 환자 및 지역사회를 가장 잘 지원하는 사정·평가 패러다임을 결정하는 데 따르는 어려움을 더 잘 이해하게 된다. 강력한 교육학적 토대의 부재, 숙달학습보다 암기에 몰두해 온 관행, 의과대학생의 역량·진전·성공을 확실히 판정할 수 없다는 초기의 인식, 고부담시험과 의과대학생 정신건강 사이의 연관성에 대한 초기 발견은 단계형 성적평가가 흔히 초래하는 해로운 영향에 관한 현재의 논의에 정보를 제공해야 한다. 사정과 평가를 둘러싼 지속적인 논쟁에 대한 우리의 집단적 대응은 의학교육에서 단계형 성적평가가 지닌 역사적 합리성과 지속적인 결과를 모두 고려해야 한다.

Acad Med. 2025 Sep 1;100(9S Suppl 1):S22-S29. doi: 10.1097/ACM.0000000000006117. Epub 2025 Jun 4.

Macy Foundation Innovation Report Part II: From Hype to Reality: Innovators' Visions for Navigating AI Integration Challenges in Medical Education 

의학교육 문헌은 지금 AI에 대한 낙관으로 넘쳐납니다. 그런데 그 아래로는 회의와 우려의 물살도 계속 흐르고 있죠. 이번에 소개할 논문은 그 낙관과 우려 사이에서, 실제로 AI를 만들고 쓰고 있는 사람들이 무슨 생각을 하는지 들어본 연구입니다.


Josiah Macy Jr. 재단이 2024년 11월 AI 콘퍼런스를 준비하면서 의뢰한 2부작 혁신 보고서(Innovation Report) 중 Part II예요. Part I이 문헌 기반 지형도(landscape review)였다면, Part II는 사람 이야기입니다.


참고로 제1저자 Brian Gin은 예전에 소개했던 'AI에 대한 위임(entrustment)과 EPA' 논문의 저자이기도 합니다. 이 논문에도 그 프레임워크가 인용되어 있어요.


📋 어떻게 한 연구인가

  • 대상: 의학교육 AI '혁신가(innovators)' 25명. 학습자 3명, 교수·기관 리더 15명, AI 산업계 7명. 30명에게 연락해 25명이 참여했습니다.
  • 혁신가의 정의: 개발자, 기관 리더와 교육자, 학습자를 포함해 의학교육 영역에서 AI 기반 기술을 개발·적용·활용하는 최전선의 개인들.
  • 방법: 반구조화 면담(semistructured interviews), 2024년 6월~8월, 온라인. 주제분석(thematic analysis)으로 코딩.
  • 결과 구조: 크게 두 덩어리 - (1) AI가 교수·학습과 평가에 미치는 영향, (2) 위협과 완화 전략.

🎓 1. 교수·학습: '어떻게 배우는가'와 '무엇을 배우는가'

어떻게 배우는가

혁신가들이 가장 많이 이야기한 건 역시 AI 튜터(AI tutor) 와 가상 환자(virtual patient) 입니다. AI가 학습자의 필요를 진단하고, 사례와 연습문제를 즉석에서 만들어내고, 면담 기술에 반응하며 대화하는 표준화 환자 역할을 한다는 그림이죠.


여기서 반복해서 등장하는 목표어가 정밀교육(precision education) 입니다. 논문은 이를 이렇게 정의합니다.

"적절한 교육적 개입을, 적절한 학습자에게, 적절한 시점에" 제공하는 것

"right educational intervention to the right learner at the right time"


두 번째로 흥미로운 건 중앙집중식 교육(centralized teaching) 아이디어예요. 참여자들은 이를 '허브 앤 스포크(hub-and-spoke)' 모델로 설명했습니다. 원격지의 학습자도 중앙의 교육에 접근할 수 있게 되고, 결국 각 분야에서 가장 잘 가르치는 교육자에게 배울 수 있다는 구상입니다. 매력적이면서 동시에 조금 서늘한 이야기이기도 하죠. 지역 의과대학 교수의 역할은 그럼 뭐가 되나, 하는 질문이 자연스럽게 따라옵니다.


강의실 형태에 대한 예측도 나옵니다. 전통적 강의 형식이 언젠가 쓸모없어지고(obsolete) 능동학습(active learning)의 비중이 커질 것이라는 전망, 그리고 소그룹 토론에서 동료(peer)의 역할을 AI가 대체할 수 있다는 전망까지요.

무엇을 배우는가

여기가 개인적으로 가장 논쟁적인 지점이라고 봅니다. 참여자들은 암기에서 지식 탐색으로(from memorizing knowledge toward navigating knowledge) 의 이동을 이야기했어요.


한 참여자가 든 예가 인상적입니다. AI가 Krebs 회로의 분자 수준 기전을 이미 알고 있으니, 학습자는 기전의 세부를 암기하는 대신 그것이 질병 과정이나 약물과 어떻게 상호작용하는지에 집중할 수 있다는 것이죠. 이게 여러 면담에서 반복된 인지적 오프로딩(cognitive offloading) 개념입니다.


임상추론 영역에서도 마찬가지입니다. AI가 여러 출처를 끌어와 감별진단을 확장하는 임상의사결정지원(clinical decision support, CDS) 도구로 기능한다는 구상인데, 여기서 참여자들의 의견이 갈립니다.

  • 한쪽: 학습자가 최소한의 역량 기준(minimum threshold of competence) 에 도달하기 전까지는 CDS 사용을 제한해야 한다
  • 다른 쪽: CDS는 이미 임상 현장에 스며들고 있고, 결국 처음부터 표준 진료의 일부가 될 것이다

AI를 얼마나 깊이 알아야 하는가에 대해서도 스펙트럼이 넓었습니다.


  • 한 극단에는 "의대생도 PyTorch로 코딩을 배워야 한다"는 주장이,
  • 반대편에는 "AI를 만들 줄 몰라도 쓰고 평가할 수 있다"는 주장이 있었어요.


📊 2. 평가: 채점 자동화를 넘어서

평가 영역의 논의는 세 층위로 정리됩니다.


  • ① 기존 평가의 자동화
    • 채점 기준표, 마일스톤, 역량에 대한 자동 채점. 특히 OSCE 채점과 가상 표준화 환자와의 상호작용 채점에 관심이 컸습니다. 서술형 평가와 수치 점수가 뒤섞인 대량의 다중양식 데이터(multimodal data) 해석도 여기 포함됩니다.
  • ② 새로운 데이터 원천
    • 가장 흥미로운 대목입니다. 참여자들은 '환자 진료의 흔적(artifacts of patient care)' 에서 학습자 수행 데이터를 끌어낼 수 있다고 봤습니다. 전자의무기록(EMR) 상호작용, 환자와의 소통, 다른 의료진과의 소통이 여기 해당하죠.
    • 한 참여자는 당뇨 환자 여러 명을 진료하며 전공의가 남긴 '디지털 발자국(digital footprints)' 을 AI로 분석하면 표준 진료에 대한 순응과 이탈을 모두 드러낼 수 있다고 했습니다.
  • ③ 피드백 생성
    • 혁신가들이 가장 열정적이었던 부분입니다. 학습자 개인의 필요와 목표에 맞춘 피드백과 맞춤형 평가를 AI가 생성한다는 것. 이들은 가상 튜터가 '안전한 공간(safe space)' 을 만들어 사실상 무제한의 형성평가(formative assessment) 기회를 준다고 상상했습니다.


⚠️ 3. 네 가지 위협, 그리고 완화 전략

여기가 이 논문의 진짜 알맹이입니다. 표로 정리하면 이렇습니다.

위협 핵심 문제 완화 전략
투명성·타당도 AI 모니터링 피로, 'human in the loop'의 한계 투명성을 설계 목표로, 산학 파트너십
편향(bias) 훈련 데이터의 알려진/알려지지 않은 편향 모델 '성적표', 맥락별 사용 평가
탈숙련·과의존 기초 역량의 침식 '기초 임상역량' 정의, 비판적 평가 능력
기관 간 불평등 가진 기관과 못 가진 기관 협력과 자원 공유, 오픈소스

투명성과 타당도 🔍


  • 가장 먼저 지적된 건 출처 표시의 부재입니다. 인기 있는 AI 모델이 생성한 정보의 출처가 표시되지 않아 정확성과 신뢰성을 검증하기 어렵다는 것. 임상 결정에 쓰이거나 수업 보조자료로 쓰일 때 특히 문제가 되죠. 게다가 특정 교육·임상 맥락에서 AI 모델의 타당도를 재는 표준화된 방법 자체가 없습니다.
  • 여기서 나온 개념이 'AI 모니터링 피로(AI monitoring fatigue)' 입니다. 인간 감독자가 AI 출력의 오류를 계속 감시하다 압도되는 상태예요. 'human in the loop' 접근이 좋아 보이지만, AI 출력의 규모 자체가 교육자와 임상의의 감독 역량을 넘어선다는 지적입니다. 저는 이 개념이 이 논문에서 가장 실무적으로 중요한 통찰이라고 봅니다.
  • 완화 전략으로는 'AI 도구 성적표(AI tool report cards)' 가 제안됐습니다. 정확도, 편향, 훈련에 사용된 지식 출처 같은 모델 성능 정보를 상세히 제공하자는 것이죠.


편향 ⚖️


  • LLM 훈련 데이터의 상당 부분이 인터넷과 공공 영역에서 왔고, 여기엔 편향된 정보, 허위, 유해한 관점, 특정 집단의 과소대표가 포함됩니다. 역사적으로 소외된 인구집단에 대해 편향된 예측이나 권고가 나올 수 있다는 것이죠.
  • 한 가지 더 날카로운 지적: 개발자가 윤리나 임상적 신뢰성보다 재정적·시장적 고려를 우선할 수 있다는 점입니다. 그러면 모델은 다양한 사용자 집단의 필요가 아니라 제작자의 이익에 복무하게 되겠죠.
  • 완화책으로는 데이터 대표성 평가, 검증된 출처(동료심사 문헌, 큐레이션된 임상 데이터베이스) 기반 훈련, 소외 지역 배포 후 피드백 수집, 이차 AI 모델을 통한 실시간 감시, 적대적 훈련(adversarial training) 등이 거론됐습니다.


과의존과 탈숙련 🧠

  • 참여자들은 계산기, 검색엔진, 위키피디아 같은 이전의 기술적 파괴를 비유로 들었습니다. 처음엔 위험하다고 했지만 결국 적응했다는 것이죠. 그럼에도 우려는 구체적입니다.
    • 추론을 AI에 맡기면 비판적 사고와 임상추론 능력이 저하될 수 있다
    • 오프로딩이 가능하면 스스로 지식을 종합할 동기 자체가 줄어든다
    • '생산적 분투(productive struggles)' 와 실패로부터의 학습이 사라진다. 학습자가 AI에 손을 뻗기 전 얼마나 버텨야 하는지 판단할 자기조절 능력이 있을까?
    • 부정행위, 그리고 AI 생성물과 인간 생성물을 교육자도 AI 자신도 신뢰성 있게 구별하지 못한다는 문제
    • 초기 학습자가 AI의 잘못된 피드백을 교정 없이 초기 인지에 각인시킬 위험
    • AI 튜터가 동료나 교수자를 대체하면서 생기는 사회적 고립과 협력적 문제해결·팀워크 역량 미발달
  • 핵심 완화 전략은 '기초 역량(foundational competencies)' 정의입니다. AI 지원이 있든 없든 갖춰야 할 최소한의 지식과 기술을 규정해서, 학습자가 필수 영역에서 자율적으로 기능할 수 있게 하자는 것이죠. 그리고 단계적 접근(staged approach): 기본 개념을 먼저 숙달하고 핵심 영역에서 숙련도를 입증한 다음에야 복잡한 과제에 AI를 쓰게 하는 것. 구구단을 뗀 뒤에 계산기를 주는 것과 같은 논리입니다.

기관 간 불평등 🏛️


  • 데이터 가용성, AI 관련 기관 정책, 안전한 컴퓨팅 인프라, AI 지식과 전문성, 재원. 이 다섯 가지에서 '가진 기관과 못 가진 기관(haves and have-nots)' 의 격차가 혁신이 진행될수록 더 벌어질 수 있다는 우려입니다.
  • 해법으로는 기관 간 데이터 공유 네트워크, 그리고 오픈소스화(open-sourcing) 가 강조됐습니다. 한 참여자는 개방형 파라미터 LLM과 하드웨어의 발전 덕에 이제 노트북에서도 모델을 돌릴 수 있다고 언급했어요. 기관 자체 보안 기준으로 관리할 수 있다는 뜻이죠. 오픈소스의 대상은 모델 파라미터만이 아니라 프롬프팅 전략, 파인튜닝 프로토콜까지 포함됩니다.
  • 그리고 마지막 한 문장이 의미심장합니다. 여러 기관의 이해를 묶은 중앙 AI 협력체가 개발사의 기업 이익에 맞서 의학교육의 우선순위(형평성, 편향 완화, 투명성, 타당도)를 대변할 수 있다는 것.


🎯 4. 저자들이 정리한 5대 우선과제

  1. AI 역량 강화(Enhancing AI competence) — 학습자용 AI 역량 프레임워크와 학부 교육과정 목록이 출발점. 교수진에게는 TPACK 기반 프레임워크가 유용할 수 있음
  2. 기초 의학역량의 정의(Defining foundational medical competencies) — CDS와 앰비언트 AI 스크라이브가 임상 현장의 일부가 될 미래에도 인간이 역량을 유지하도록 계획
  3. 윤리적이고 신뢰할 수 있는 AI 사용(Establishing ethical and trustworthy AI use) — 공정성, 투명성, 데이터 보안 가이드라인
  4. 공동생산과 협력(Fostering coproduction and collaboration) — 학습자, 교육자, 개발자, 이해관계자가 함께 최적화
  5. AI 영향의 모니터링과 평가(Monitoring and evaluating AI impact) — 특히 모니터링 피로를 줄이기 위해 AI가 스스로 불확실한 출력에 플래그를 달도록 설계·훈련

💬 읽고 나서

몇 가지 남는 생각을 적어둡니다.


  • 첫째, 이 논문의 미덕은 '합의'를 만들지 않았다는 점입니다. CDS를 언제 허용할지, AI를 얼마나 깊이 알아야 하는지에서 참여자들의 입장이 갈리는데, 저자들은 이를 봉합하지 않고 그대로 보여줍니다. 서론의 질문 - "우리는 먼저 혁신할 것인가, 먼저 검증할 것인가(Do we innovate first or do we validate first?)" - 은 여전히 열려 있습니다.
  • 둘째, 'AI 모니터링 피로'는 우리가 지금 당장 마주할 문제입니다. AI 기반 피드백이나 자동 채점을 도입할 때 우리는 습관적으로 "최종 확인은 교수가 한다"고 씁니다. 그런데 출력 규모가 커지면 그 안전장치는 형식적으로만 남습니다. 도입 설계 단계에서 검토 가능한 분량과 불확실성 플래그를 함께 설계하지 않으면 위임의 외양만 남게 되겠죠.
  • 셋째, 기관 간 격차 논의는 한국에서 다르게 읽힙니다. 미국 맥락의 '가진 기관 vs 못 가진 기관'은 우리에게도 그대로 적용되지만, 우리는 상대적으로 학회와 협의체 중심의 협력 기반이 있는 편입니다. 공통 프롬프트, 평가 문항, 파인튜닝 프로토콜을 대학 간에 공유하는 실험이 개별 대학의 자체 개발보다 현실적일 수 있습니다.
  • 넷째, '무엇을 가르칠 것인가'로 논의를 옮길 때입니다. Krebs 회로 예시가 상징적입니다. 이 논문은 AI 도입 방법론을 넘어 기초 역량의 재정의를 요구하고 있어요. 2028 교육과정 개편을 준비하는 입장에서, 이건 도구 도입 논의가 아니라 졸업성과 논의입니다.


의학교육 문헌에는 인공지능(artificial intelligence, AI)이 우리가 가르치고, 배우고, 진료하는 방식을 혁신할 것이라는 낙관론이 넘쳐난다. 그러나 AI의 위험에 대한 회의와 우려의 저류도 계속 표면화되고 있다. AI는 주로 자원집약적 과업(resource-intensive tasks)의 자동화를 통해 역량기반 의학교육(competency-based medical education, CBME)과 정밀교육(precision education)에서 오랫동안 추구해 온 목표를 달성할 잠재적 수단으로 환영받았지만, AI가 의학교육에 미칠 단기 및 장기 영향은 여전히 알려져 있지 않다.


생성형 AI(generative AI), 즉 다양한 영역에서 인간의 폭넓은 인지 및 추론 활동을 모방하는 기계의 새롭게 출현한 능력은 의학교육에서 AI 활용을 바라보는 교육자들의 인식에 패러다임 전환(paradigm shift)을 일으켰다.1–3 문헌은 의학교육자와 AI 응용기술 사이에서 이루어진 놀라운 공진화(coevolution)의 과정을 보여준다. 초기 연구들은 생성형 AI 모델의 하위 유형으로서 자연어로 응답을 처리하고 생성할 수 있는 대규모언어모델(large language models, LLMs)의 지식과 추론 능력의 한계를 탐색하였다.4 (AI 용어집은 http://links.lww.com/ACADMED/B730의 Supplemental Digital Appendix 1을 참조하라.) 이러한 연구가 임계 규모에 이르면서, LLM이 표준화시험 문항(예: United States Medical Licensing Examination 및 전문의 자격시험)에 평균적인 인간 수험자보다 더 정확하게 답하고, 그 답에 대한 설명도 제공할 수 있다는 사실이 확인되었다.5–8


이러한 개념증명(proof-of-concept)은 의학교육자들의 상상력을 사로잡았다. 이들은 AI가 “적절한 시점에 적절한 학습자에게 적절한 교육적 개입”을 제공하는 정밀교육을 가능하게 할 잠재력을 내다보았다.9,10 이 주장의 핵심은 AI를 학생의 학습 요구를 진단하고 지식 및 비판적 사고의 전달과 평가를 자동화할 수 있는 “가상 튜터(virtual tutor)” 또는 “코치(coach)”로 활용할 수 있다는 것이었다.11 이러한 낙관론은 AI의 정확성/타당화, 투명성, 정보 출처(편향을 확산시킬 가능성 포함)에 관한 우려로 완화되었다.12–15 이에 대응하여 여러 집단은 AI 역량, 리터러시, 윤리 및 신뢰성(trustworthiness)을 위한 프레임워크를 포함해 생성형 AI 사용에 관한 지침을 개발하고자 하였다.16–19


의학교육 문헌에 드러나듯, AI 통합의 약속은 아직 완전히 실현되지 않았다. 그 결과 정밀교육과 기타 목표를 향한 진전은 중대한 갈림길에 놓여 있으며, 핵심 질문에 관한 공동체의 집단적 결정에 따라 형성될 준비가 되어 있다.


  • 우리는(의학교육자 공동체로서) 먼저 혁신해야 하는가, 아니면 먼저 타당화해야 하는가?
  • 환자, 학습자, 교육자, 교육프로그램을 포함한 모든 이해관계자를 위해 AI 혁신의 형평성을 어떻게 보장할 것인가?
  • AI는 미래 의사와 환자의 지식 및 술기에 어떤 영향을 미칠 것인가?


Josiah Macy Jr. Foundation의 의뢰를 받아 작성된 2부 구성 혁신 보고서의 제2부를 통해, 우리는 의학교육 AI 혁신가의 관점에서 이러한 질문의 답을 찾고자 하였다. 우리는 혁신가를 의학교육 영역에서 AI 기반 기술을 개발하고, 적용하며, 활용하는 최전선에 있는 개인—개발자, 기관 리더 및 교육자, 학습자—으로 정의하였다. 구체적으로 우리는 AI가 의학교육에 미치는 영향, AI 통합이 제기하는 기회와 도전과제, 그리고 위험을 완화하거나 극복할 수 있는 방법에 관한 혁신가들의 인식을 포착하고자 하였다. 혁신가들이 공유한 비전은 혁신 보고서 제1부에 제시된 AI 환경 검토와 함께20 2024년 11월 Macy Foundation Conference on AI in Medical Education에서 이루어진 논의와 개발된 권고21의 맥락 및 토대를 형성하였다.

방법 (Method) 

혁신가 선정 (Selection of innovators) 

혁신가에는 학습자(n = 3), 교수 및 기관 리더(n = 15), AI 산업계 관계자(n = 7)가 포함되었으며, 문헌에 대한 기여 또는 의학교육이나 보건의료 AI의 핵심 이해관계자로 확인된 사실을 바탕으로 선정하였다. 우리는 30명에게 연락하였고, 25명이 참여에 동의하였다. (면담 참여자의 역할과 직함을 대표적으로 정리한 목록은 http://links.lww.com/ACADMED/B730의 Supplemental Digital Appendix 2를 참조하라.)

반구조화 면담 (Semistructured interviews) 

면담 가이드(http://links.lww.com/ACADMED/B730의 Supplemental Appendix 3 참조)는 연구 질문—AI가 의학교육에 미치는 영향에 대한 인식, AI 통합이 제기하는 기회와 도전과제, 위험 완화 전략—에 근거하여 연구팀원 2명(C.K.B., B.C.G.)이 개발하였다. 최초 가이드는 프로토콜과 질문의 명료성을 확보하기 위해 다른 연구팀원 2명(A.K., S.C.)이 검토하였다. 일부 면담 질문은 특정 참여자의 역할에 맞게 수정하고 조정하였다. 면담은 2024년 6월부터 2024년 8월까지 연구팀원 3명(C.K.B., B.C.G., A.K.)이 화상회의로 실시하였으며, 녹음, 전사, 비식별화하였다.

자료 분석 및 코딩 (Data analysis and coding) 

면담 자료를 분석하기 위해 주제분석(thematic analysis)을 사용하였다.22 먼저 면담 전사자료를 검토하며 메모하였다. 연구계획서와 면담 가이드를 사용하여 초기 코드를 개발하였다. 정기 회의와 코드북 검증을 반복하는 과정을 통해 코드북을 정교화하였다. 면담 수는 사전에 계획하였지만, 연구팀은 분석 과정 전반에 걸쳐 각 초점집단 내외에서 깊이(경험의 풍부성)와 폭(경험의 범위)이라는 측면의 주제적 충분성(thematic sufficiency)을 모두 고려하였고, 최종적으로 이 자료 세트가 분석적으로 충분하다고 판단하였다. 이 질적 연구의 엄밀성(rigor)을 강화하기 위해 확립된 질적 연구 보고 기준에 따라 보고서를 작성하였다.23 분석에는 Dedoose를 사용하였다.24

성찰성/입장성 (Reflexivity/positionality) 

분석팀은 의학(B.C.G., A.K.), 교육연구 방법론(B.C.G., C.K.B.), 사회학(K.L.)에 관한 학문적 훈련을 받았다. 자료 분석에 참여한 연구자 3명(C.K.B., B.C.G., K.L.) 모두 질적 자료를 분석한 경험이 있으며 질적 연구방법을 활용한 논문을 출판하였다.

결과 (Results) 

면담 전사자료를 사용하여 혁신가들로부터 수집한 정보를 두 가지 주요 주제로 종합하였다. (1) 의학교육에 AI를 통합함으로써 발생하는 영향과 함의, (2) 잠재적 위험, 우려 및 완화 전략이다.

의학교육에 대한 AI의 영향 (Impact of AI on medical education) 

참여자들은 AI가 의학교육에 미치는 영향을 주로 두 영역, 즉 교수·학습과 평가로 인식하였다(표 1).

교수와 학습 (Teaching and learning) 


  • 참여자들은 학습이 어떻게 이루어지는지, 그리고 무엇을 학습하는지라는 관점에서 AI가 학습과 교수에 미치는 영향을 설명하였다.
  • 학습자는 어떻게 학습하는가(How learners learn).
    • 참여자들은 LLM이 지식 자원의 역할을 하고 그 지식을 바탕으로 추론하는 능력이 새롭게 발전하고 있다는 점을 비롯하여, AI가 학습자의 지식 및 술기 습득에 도움이 될 수 있다고 생각하는 여러 방식을 설명하였다. 참여자들은 이러한 능력을 활용하여 AI가 가상 튜터와 가상 교사(virtual teacher)의 역할을 하도록 할 수 있다고 설명하였다.
    • 면담 참여자들은 AI를 활용해 중앙집중형 교수(centralized teaching)를 가능하게 하는 개념을 논의하면서, 원격지의 학습자들이 중앙집중형 교수에 접근할 수 있는 “허브 앤드 스포크(hub-and-spoke)” 모형을 설명하였다. 여러 참여자에 따르면, 이를 통해 학생들은 각 학문분야에서 가장 효과적이라고 평가된 교육자에게 배울 수 있다.
    • 교실과 학습 형식(classroom and learning formats)의 변화도 참여자들이 제기한 잠재적 영향이었다. 여러 참여자는 AI가 장차 전통적 강의 형식을 쓸모없게 만들고, 능동학습(active learning)을 더 강조하게 할 잠재력이 있다고 설명하였다. 일부는 소그룹 토의에서 AI가 동료의 역할을 대신하여 학습자가 인간 동료 대신 AI와 상호작용할 가능성을 설명하였다.
    • AI 도구가 시뮬레이션(simulation)을 보강할 잠재력도 강조되었다. 참여자들은 AI를 특정 임상 양상과 사례로 훈련할 수 있으며, 학습자의 면담 술기에 반응하여 대화 방식으로 질문에 답할 수 있다고 설명하였다.
  • 학습자는 무엇을 학습하는가(What learners learn).
    • 참여자들은 지식을 암기하는 데서 지식을 탐색하고 활용하는 방향으로 전환이 계속되고 있다고 설명하였다. 한 참여자는 AI가 Krebs cycle의 분자적 기전을 알고 있으므로, 학습자가 기전의 세부사항을 암기할 필요 없이 그것이 질병 과정과 약물에 어떻게 상호작용하는지에 집중할 수 있다고 설명하였다. 암기 과업을 AI에 “오프로딩(offloading)”한다는 발상은 여러 면담에서 나타났으며, 그 이점으로 학습자가 비판적 사고 술기와 고차원 인지 과업(higher-level cognitive tasks)의 학습에 집중할 수 있다는 점이 인식되었다.
    • “인지적 오프로딩(cognitive offloading)”25이라는 발상은 임상학습환경(clinical learning environment)의 맥락에서도 설명되었다. 참여자들은 AI를 활용해 학습자의 임상추론 능력(clinical reasoning capabilities)을 보강할 수 있다고 설명하였다. 이 발상에는 AI가 여러 출처를 활용하여 감별진단을 개발하거나 확장하고, 임상의사결정지원(clinical decision support, CDS) 도구로 기능하는 능력이 포함된다.26 그러나 참여자들은 CDS 도구를 학습자의 발달 궤적에 어떻게 통합할 것인지에 관해 의견이 나뉘었다. 일부는 학습자가 최소 역량 기준에 도달할 때까지 사용을 제한해야 한다고 주장한 반면, 다른 이들은 CDS 도구가 이미 임상실무에 스며들기 시작했고 결국 처음부터 진료의 표준(standard of practice)이 될 수 있다고 주장하였다.
    • 다수의 참여자는 학습자에게 AI 도구를 언제, 어떻게 효과적으로 사용할지, 그리고 AI 생성 산출물을 어떻게 비판적으로 평가(appraise)할지를 가르쳐야 한다는 믿음도 공유하였다. 그러나 학습자가 AI의 기술적 세부사항을 얼마나 알아야 하는지에 대해서는 의견이 일치하지 않았다.
      • 한 극단에서 어느 참여자는 의과대학생에게 PyTorch(신경망을 구현하기 위한 응용 프로그램 인터페이스, application programming interface, API)로 코딩하는 법을 가르쳐야 한다고 단언하였다.27
      • 다른 극단에서 일부는 AI 응용기술을 만들거나 코딩하는 법을 아는 것이 그것을 사용하거나 평가하는 데 필요하지 않으며, AI가 스스로를 지시하는 데 점점 더 능숙해지는 지점에 가까워지고 있다고 주장하였다.


평가 (Assessment) 


  • 혁신가들은 특정 시험의 채점 루브릭이나 보다 일반적인 마일스톤(milestones) 및 역량과 같은 확립된 기준에 비추어 학습자의 수행을 자동 채점하기 위해 AI 도구가 현재 사용되고 있다고 설명하였다. 향후 적용에서 특히 관심을 끈 것은 AI를 사용하여 객관구조화임상시험(objective structured clinical examinations, OSCEs)28과, 더 나아가 가상 표준화환자와의 학습자 상호작용을 채점할 가능성이었다.29,30 기존 평가에 AI를 적용할 또 다른 기회에는 AI를 사용해 대량의 다중양식 자료(multimodal data), 즉 서술형 평가와 수치 점수를 함께 해석하도록 돕는 것이 포함되었다.27 이러한 활용은 학습자의 서술형 평가를 요약하고 분류하는 AI의 능력을 이용할 수 있다.
  • 혁신가들은 수행 자료를 집계, 요약, 시각화함으로써 학습자의 강점과 약점을 파악하고 해석하는 데 AI를 활용한다고 설명하였다.
  • 혁신가들은 기존 평가를 향상시킬 AI의 잠재력에 더해, 학습자의 전자의무기록(electronic medical record, EMR) 사용, 환자(실제 및 모의 환자 모두)와의 의사소통, 다른 의료제공자와의 의사소통을 포함하는 “환자진료의 인공물(artifacts of patient care)”에서 파생된 추가적인 학생 수행 자료에 접근하기 위해 AI를 활용할 가능성을 논의하였다.31,32 예를 들어 한 참여자는 여러 당뇨병 환자를 진료하는 동안 전공의가 남긴 “디지털 발자국(digital footprints)”을 AI로 이해하면, 전공의가 표준 진료를 준수하거나 이탈한 양상을 모두 밝혀낼 수 있다고 논의하였다.33,34
  • 혁신가들은 학습자의 요구와 목표에 맞춘 피드백과 맞춤형 평가를 생성하기 위해 AI 도구를 사용하는 데 특히 큰 기대를 표했다.35 혁신가들은 AI 생성 기능이 학습자에게 성장을 촉진하는 저부담 평가(lower-stakes assessments)의 기회를 더 많이 제공할 수 있다고 예측하였다. 그들은 가상 튜터가 학습자에게 형성평가(formative assessment)와 피드백을 받을 수 있는 거의 무제한의 기회를 제공하는 “안전한 공간(safe space)”을 만들 것이라고 전망하였다.


표 1. 주제 1: 2024년 6월부터 2024년 8월까지 실시한 반구조화 면담 25건의 주제분석에 근거한 의학교육에 대한 AI의 영향 

영향 영역 핵심 내용 예시
교수와 학습
  • 핵심 하위영역: AI 튜터, 중앙집중형 학습, 진화하는 교실, 가상 환자, 인지적 오프로딩, AI로 강화된 임상추론.
  • 요약: AI는 교육이 제공되는 방식을 변혁하고, AI 튜터와 가상 환자를 통해 개별화 학습을 가능하게 하는 데 사용될 수 있다. 암기에서 지식 탐색으로 초점을 전환하고 시뮬레이션 충실도(simulation fidelity)를 높일 수 있다.
  • AI 튜터는 개별 요구에 맞게 조정된 맞춤형 학습을 제공하고, 사례연구와 연습평가를 즉석에서 생성할 수 있다.
  • “가상 환자” 개념은 AI를 사용해 환자 상호작용을 모의함으로써 학습자에게 많은 양의 현실적인 시뮬레이션을 제공할 수 있다.
  • AI 진단지원시스템은 근거기반 감별진단과 치료계획을 개발하도록 학습자를 지원함으로써 임상추론을 향상시킬 수 있다.
평가
  • 핵심 하위영역: 능력 예측과 분류, 새로운 평가 기회, 피드백 생성.
  • 요약: AI는 채점을 자동화하고, 개인화된 평가를 만들며, 맞춤형 피드백을 생성하는 데 사용될 수 있다. 학습자 발달 궤적을 예측하고 평가하여 정밀교육을 지원할 새로운 가능성을 제공한다.
  • AI는 임상술기시험 채점을 자동화하고, 학습자 수행을 추적하는 대시보드를 만들며, 개인의 발달 궤적에 근거하여 미래의 성취를 예측할 수 있다.
  • EMR 자료와 의사소통을 분석하는 AI의 능력은 진료 표준의 준수와 인간적 자질(humanistic qualities)을 드러내는 새로운 평가 기회를 제공할 수 있다.
  • 가상 표준화환자와 AI 강화 시뮬레이션의 실시간 피드백은 학습자가 임상 및 의사소통 술기를 연습하고 정교화하는 데 도움을 줄 수 있다.


약어: AI, 인공지능(artificial intelligence); EMR, 전자의무기록(electronic medical record).

AI 통합의 도전과제와 완화 전략 (AI integration challenges and mitigation strategies) 

참여자들은 의학교육에 AI를 통합할 때 예상되는 도전과제를 설명하였다. 이들은 AI의 일반적 도전과제(투명성, 타당도, 편향)와 의학교육 AI에 특수한 도전과제(교수/학습 및 형평성)를 모두 설명하였다(표 2). 또한 이러한 도전과제를 다루기 위한 완화 전략도 제시하였다.

AI의 일반적 도전과제: 투명성과 타당도 (General AI challenges: Transparency and validity) 


  • 참여자들은 인기 있는 AI 모델이 생성한 정보의 출처에 대한 인용이 부족하다는 점이 일차적 문제라고 성찰하였다. 이 때문에, 예를 들어 AI가 임상의사결정에 정보를 제공할 자료를 만드는 데 사용되거나 과목의 보충 학습자료를 제공하는 데 사용될 경우, 모델이 생성한 내용의 정확성과 신뢰도를 검증하기 어렵다. 또한 참여자들은 특정 교육 및 임상 맥락에서 AI 모델의 타당도를 측정하는 표준화된 방법이 부족하다고 지적하였다. 참여자들은 일부 모델이 일반 과업에서는 우수한 수행을 보이지만, 희귀질환의 진단이나 교육적 개입의 맞춤화와 같은 전문 영역에서의 효과는 대체로 타당화되지 않은 상태라는 우려를 공유하였다.4
  • 더 나아가 인간 감독자가 AI 산출물의 오류를 지속적으로 모니터링해야 하는 부담에 압도될 수 있는 “AI 모니터링 피로(AI monitoring fatigue)” 개념에 대한 우려가 제기되었다.36 참여자들은 AI 산출물의 방대한 규모가 교육자와 임상의가 AI 생성 산출물을 효과적으로 감독하고 타당화할 수 있는 역량을 초과할 수 있으므로, 인간 운영자가 작업흐름에 참여하여 AI 산출물을 지속적으로 평가하는 “인간 개입형(human in the loop)”37 모니터링 접근을 유지하기 어렵다고 설명하였다.
  • 투명성과 타당도에 대한 위협 완화(Mitigating threats to transparency and validity).
    • AI 사용의 투명성과 타당도를 확보하기 위해, 참여자들은 의학교육 AI 시스템의 신뢰도와 신뢰성(trustworthiness)을 높이기 위한 여러 전략을 제안하였다. 이러한 전략은 AI 산출물의 타당화, 신뢰할 수 있는 자료원을 확보하기 위한 파트너십 구축, 교육 및 임상 환경에 AI를 체계적으로 평가·통합하기 위한 프레임워크 개발에 초점을 두었다.18,19,38
    • 참여자들은 AI가 조작되거나 부정확한 정보를 제공하는 사례인 오류와 환각(hallucinations)39을 발견하고 교정하기 위해 AI 생성 내용을 타당화하는 것이 중요하다고 강조하였다.
    • AI 타당화를 보다 제도화하기 위해, 참여자들은 AI 평가 절차를 의학교육과 임상실무에서 사용되는 확립된 타당화 패러다임(validation paradigms)27과 일치시킬 것을 제안하였다.
    • 투명성을 높이기 위해 참여자들은 정확도, 편향(아래 참조), 훈련에 사용된 지식 출처 등의 지표를 포함하여 모델 수행에 관한 상세 정보를 제공하는 “AI 도구 성적표(AI tool report cards)”40를 만드는 방안을 논의하였다. 이러한 성적표는 사용자가 다양한 교육 및 임상 적용에서 서로 다른 AI 도구의 적합성에 관하여 더 충분한 정보를 바탕으로 결정하도록 할 수 있다. 이러한 투명성은 AI 개발자의 책무성(accountability)도 촉진하고, AI 산업과 의학교육 공동체 사이의 지속적인 피드백과 협업을 장려할 수 있다.


AI의 일반적 도전과제: 편향 (General AI challenges: Bias) 


  • 참여자들은 AI 모델에 내재된 다양한 형태의 편향에 우려를 표했다. 이러한 편향은 여러 출처에서 비롯될 수 있으며 의학교육과 임상실무 모두에 중대한 함의를 갖는다. 편향의 일차적 출처는 AI 모델 개발에 사용되는 훈련자료(training data)이다. LLM의 경우 이러한 자료의 상당 부분이 인터넷과 기타 공개 영역에서 유래하는데, 여기에는 편향된 정보, 허위정보, 유해한 관점, 특정 집단이나 관점의 과소대표가 포함될 수 있어 더 광범위하고 다양한 인구집단에 대한 적용 가능성을 제한한다.41,42 이는 특히 역사적으로 주변화되거나 과소대표된 인구집단이 관련된 사례에서 편향된 예측이나 권고를 낳을 수 있다. 또한 개발자가 윤리적 우려나 임상적 신뢰도보다 재정적 또는 시장적 고려를 우선시할 수 있으며, 그 결과 다양한 사용자 집단의 필요보다 개발자의 이익에 복무하고 기존의 불평등을 악화시키며 최초 훈련자료에 존재하는 편향을 확산시키는 모델이 만들어질 수 있다.
  • 편향 완화(Mitigating bias).
    • AI 모델의 편향 문제를 다루기 위해 참여자들은 훈련자료의 질과 투명성을 개선하고, 다양한 인구집단을 개발 과정에 적극적으로 참여시키며, 견고한 모니터링 및 평가 프레임워크를 실행하는 다면적 접근을 권고하였다. 이들은 자료의 대표성과 다양성을 평가하고, 자료에 부호화된 편향을 식별하며, 이러한 편향이 AI 산출물에 어떻게 영향을 미칠 수 있는지 이해할 것을 제안하였다.14,15,43 또한 고정관념과 부정확성의 확산을 줄이기 위해 동료심사를 거친 의학문헌이나 선별·관리된 임상 데이터베이스와 같이 정확성과 대표성을 검토받은 타당화된 자료원을 사용하여 AI 모델을 훈련하거나 보강할 것을 권고하였다.
    • 이들은 서비스가 부족한 지역사회와 주변화된 지역사회에 AI 도구를 배치하고, 이러한 인구집단으로부터 피드백을 구해 AI 모델의 잠재적 편향과 한계에 관한 실제 세계의 통찰(real-world insights)을 수집할 것을 제안하였다. 이러한 참여는 개발자가 모델을 정교화하고 다양한 인구집단의 요구와 맥락에 적용할 수 있도록 보장하는 데 도움을 줄 수 있다.
    • 참여자들은 실시간으로 편향을 탐지하고 다루기 위해 이차 AI 모델과 같은 추가적인 자동화 모니터링 층을 사용하는 방안을 언급하였다. 적대적 훈련(adversarial training)도 AI 모델 개발 중 편향을 식별하고 완화하기 위한 기법으로 권고되었다. (이 기법은 숨겨진 편향을 드러내도록 설계된 도전적인 시나리오에 AI 모델을 노출함으로써 모델을 더 견고하고 편향된 결과를 산출할 가능성이 낮게 만든다.)


의학교육 AI의 도전과제: 과도한 의존으로 인한 학습 감소와 탈숙련화 (Medical education AI challenges: Reduced learning and deskilling from over-reliance) 


  • 참여자들은 AI에 대한 과도한 의존의 위험이 학습자의 학습 감소와 탈숙련화(deskilling, 술기를 개발하거나 유지하지 못하는 것)로 이어질 수 있다고 설명하였다. 잠재적인 위험 완화 전략을 도출하기 위해, 이들은 처음에는 학습자 위험과 연관되었으나 교육자와 학습자가 궁극적으로 적응하고 혜택을 얻었다고 믿는 과거의 기술적 파괴(계산기, 검색엔진, Wikipedia 등)에 비유하였다.
  • 추론을 AI에 과도하게 의존하면 비판적 사고와 임상추론 술기가 감소할 수 있다. 참여자들은 추론 술기가 충분히 발달하지 못하는 것에 더해, 그러한 과업을 AI에 오프로딩할 수 있다면 학습자가 스스로 지식을 종합하려는 동기를 덜 갖게 될 수 있다고 우려하였다. AI가 “실패를 통한 학습(learning from failure)”이나 “생산적 고투(productive struggles)”를 저해할 수 있다는 발상도 나타났다.44 참여자들은 학습자가 AI의 도움을 구하기 전에 얼마나 오랫동안 스스로 문제를 해결하려고 노력해야 하는지 판단할 자기조절 규율(self-regulatory discipline)을 갖추지 못할 수 있다고 우려하였다.
  • 교육자들은 학습자가 평가에서 부정행위를 하기 위해 AI를 사용하는 것에도 우려를 표했다. 특히 교육자(또는 AI 자체)가 AI 생성 결과물과 인간이 만든 결과물을 신뢰할 만하게 구별할 수 없다는 점이 우려되었다. 참여자들은 학습자가 피드백과 지침을 AI에 과도하게 의존하면 잠재적인 AI 오류, 부정확성 또는 결함에 취약해질 수 있다는 우려도 표했다. 이처럼 “오도하는(misleading)” 피드백은 초기 학습자의 상대적 경험 부족과 결합할 경우, 교정되기 전에 초기 인지에 각인되어 중대한 도전과제를 초래할 수 있다. 마지막으로 AI 튜터/코치가 동료나 교원을 대체할 가능성은 학습자의 사회적 고립과 협력적 문제해결 또는 팀워크 술기를 적절히 발달시키지 못할 우려로 이어졌다.
  • 학습 위험 완화(Mitigating learning risks).
    • AI 과의존과 관련된 잠재적 위험을 다루기 위해, 참여자들은 학습자가 기초지식과 핵심 술기를 유지하도록 보장하는 명확한 지침과 프레임워크를 확립하는 것이 중요하다고 강조하였다. 한 가지 제안된 전략은 AI 지원의 이용 가능 여부와 관계없이 요구되는 최소한의 지식과 술기 수준인 “기초역량(foundational competencies)”을 정의하고 유지하는 것이었다. 이를 통해 학습자가 필수 영역에서 자율적으로 기능할 수 있도록 보장할 수 있다.
    • 또 다른 공통 권고는 특히 평가와 AI 지원 학습의 맥락에서 AI를 언제, 어떻게 사용할 수 있는지에 관한 명시적 지침을 정의하는 것이었다. 앞서와 마찬가지로 평가에서 AI 도구의 단계적 사용 접근이 제안되었다. 즉, 학습자는 더 복잡한 과업이나 문제해결에 AI 도구를 활용하도록 허용되기 전에 먼저 기본 개념을 숙달하고 핵심 영역에서 능숙함을 보여야 한다. 학생이 구구단과 산술의 기본 원리를 숙달한 뒤 계산기를 도입하는 비유가 제시되었다. 이와 유사하게 참여자들은 인터넷 검색엔진과 위키가 지식의 출처가 되었을 때 교육자들이 처음 우려했지만 학습자에게 중대한 부정적 영향이 없었다는 점도 언급하였다.
    • 타당화된 자원을 보장하는 것에 더해, 참여자들은 AI 산출물을 비판적으로 평가하고 감독하는 방법을 학습자에게 가르치는 것이 중요하다고 강조하였다.16,41 AI 평가 술기를 개발하면 학습자가 AI 시스템이 제공한 제안을 질문하고 검증할 역량을 갖게 되어, 인간 판단과 AI 지원 사이의 균형을 촉진할 수 있다.


의학교육 AI의 도전과제: AI 자원 격차의 확대 (Medical education AI challenges: Widening AI resource disparities) 


  • 참여자들은 혁신이 진전되면서 더 커질 수 있는, AI 자원을 가진 기관과 가지지 못한 기관(institutional “haves and have-nots”) 사이의 기존 분배 불균형을 설명하였다. 이러한 자원에는 자료의 이용 가능성, AI에 관한 기관 정책, 안전한 컴퓨팅 인프라, AI 지식과 전문성, 재정 지원이 포함된다.45
  • 불평등 완화(Mitigating inequity).
    • 참여자들은 AI 혁신에 대한 기관의 접근성 격차를 줄이기 위한 한 단계로서 AI 이해관계자 집단 사이의 협업을 강화할 것을 공통적으로 촉구하였다. 이러한 협업은 자료 공유를 촉진하고, 자료보안 정책을 중앙집중화하며, 컴퓨팅 자원의 격차를 줄이고, AI 개발자와의 관계를 육성할 수 있다. 혁신가들은 교육 관련 자료와 임상 자료 모두에 대한 접근을 촉진하기 위해 기관 간 자료공유 네트워크를 확립할 것을 촉구하였다. 일부는 확립된 임상 자료공유 프로그램46을 본떠 자료공유 노력을 설계하거나, 그러한 프로그램의 범위를 교육자료까지 확장할 것을 제안하였다.
    • 참여자들은 오픈소싱(open-sourcing), 즉 AI 도구와 그 기반 매개변수 및 코드를 자유롭게 이용할 수 있도록 하는 것을 혁신가와 기관 사이의 협업을 개선하는 전략으로 설명하였다. 한 참여자는 개방형 매개변수 LLM(open-parameter LLMs)과 컴퓨터 하드웨어의 발전 덕분에 노트북 컴퓨터처럼 흔한 장치에서도 그러한 모델을 로컬로 실행할 수 있게 되었다고 언급하였다. 이러한 개방형 매개변수 LLM은 무료로 내려받아 로컬 컴퓨팅 자원에서 실행할 수 있으며, 로컬 기관의 기준에 맞추어 보안을 확보할 수 있다. 오픈소싱의 발상은 AI 모델(즉, 신경망 매개변수)에 국한되지 않았으며, 프롬프팅 전략(prompting strategies), 미세조정 프로토콜(fine-tuning protocols), 기타 모델 보강 전략을 공동체에 공개하는 것도 포함할 수 있다.
    • 중앙집중형 AI 협력체(centralized AI collaborative)를 통해 여러 기관의 이해를 결합하는 것은 형평성, 편향 완화, 투명성, 타당도와 같은 의학교육의 우선과제를 옹호하고 개발자의 기업적 이해와 균형을 이루는 잠재적 수단으로 여겨졌다.


표 2. 주제 2: 2024년 6월부터 2024년 8월까지 실시한 반구조화 면담 25건의 주제분석에 근거한 의학교육 AI의 효과적 통합을 위한 도전과제와 완화 전략 

도전과제 설명 완화 전략
투명성, 타당도, 신뢰도
  • AI 모니터링 피로—“인간 개입형(human in the loop)” 패러다임의 불충분성
  • 지식재산권 보호와 투명성 사이의 긴장
  • AI 설계 목표로서의 투명성—불확실성과 출처를 보고하도록 모델을 훈련
  • 학계-산업계 파트너십—임상 환경을 위한 공동의 이해와 AI 수행 기준 개발
편향
  • 훈련자료의 알려진 편향과 알려지지 않은 편향
  • 보편적으로 편향되지 않은 입장을 찾기 어려움
  • 모델 “성적표”—모델 편향을 측정/보고하는 기제
  • 맥락 특수적 AI 사용—이해관계자 집단별 차등적 영향 평가
탈숙련화와 과도한 의존
  • 기초 술기의 약화, AI가 없을 때의 취약성
  • AI 평가에 대한 사용자의 책임
  • “기초 임상역량” 정의—AI 지원이 없을 때 의료제공자가 보유해야 하는 지식과 술기
  • 탈숙련화 방지를 위한 비판적 평가—AI를 감독하려면 AI 수행을 평가할 수 있는 임상 지식/술기를 유지해야 함
기관 간 불평등
  • 자원을 “가진” 기관과 “가지지 못한” 기관
  • 협업 부족, 학제 간 사일로(interdisciplinary silos)
  • 이해관계자 집단과 환자 인구집단을 주변화할 위험
다음을 포함하는 협업과 자원 공유:
  • 안전한 컴퓨팅 인프라
  • AI 전문성과 학습테크놀로지 팀
  • 재정 지원 기회와 다기관 연구비 제안서
  • 자료 공유
  • 오픈소스 개발
  • 전문직 간·다중 이해관계자 팀


약어: AI, 인공지능(artificial intelligence).

논의 및 권고 (Discussion and Recommendations) 

참여자들은 AI가 임상학습환경에서 학습자가 학습하는 방식과 학습하는 내용 모두를 변화시키는 다양한 방식을 설명하였다. 이들은 AI가 학습 방식(예: 가상 튜터 및 가상 환자)을 재정의하고, 기초 의학지식(예: Krebs cycle의 세부사항처럼 덜 자주 사용되는 정보를 암기할 필요를 줄임)을 재정의할 수 있는 방식을 강조하였다. 또한 AI를 활용하여 각 학생의 고유한 요구에 맞게 학습경험을 맞춤화하고 정밀교육의 목표를 가능하게 한다는 공통 목표를 되풀이하였다. 동시에 탈숙련화와 과도한 의존, 모니터링 피로, 편향의 확산을 포함하여 AI가 의학교육에 제기하는 위협도 설명하였다. 참여자들은 이러한 위협을 완화하기 위한 명확한 전략을 제안하였으며, 이를 의학교육에 AI를 통합하기 위한 참여자들의 최우선 영역으로 아래와 같이 종합하였다.

1. AI 역량 강화 (Enhancing AI competence)

  • 교육자와 학습자는 AI 도구 사용에 능숙해야 하며 AI 도구와 효과적으로 상호작용하는 전략을 개발해야 한다. 학습자의 경우, 제안된 AI 역량16,41,47과 기본의학교육(undergraduate medical education)의 AI 교육과정 목록48이 검토를 시작하기 위한 좋은 출발점이다. 교수자의 경우, 테크놀로지·교수법·내용 지식(technological, pedagogical, and content knowledge, TPACK)에 대한 AI 관련 영향에 초점을 둔 새로운 프레임워크49가 AI 교수역량(AI pedagogical competencies)의 윤곽을 제시하는 데 도움이 될 수 있다.

2. 의학 기초역량 정의 (Defining foundational medical competencies)

  • AI가 의학교육에 통합됨에 따라, 의료실무에 필요한 기초역량을 식별하고 유지하는 것이 매우 중요하다. 환자 결과를 개선할 잠재력이 있는 내장형 CDS 시스템(embedded CDS systems)과 주변형 AI 기록도구(ambient AI scribes)는 곧 임상 환경의 일부가 될 수 있다. 교육자들은 학습과 임상실무의 이러한 변화가 학습자가 의료를 실천하기 위해 알아야 하는 지식과 술기를 어떻게 바꿀 수 있는지 파악해야 하며, 동시에 AI의 지원이 있더라도 인간이 역량을 유지하는 미래를 계획해야 한다.

3. 윤리적이고 신뢰할 수 있는 AI 사용 확립 (Establishing ethical and trustworthy AI use)

  • 개인화된 학습경로(personalized learning pathways)에 AI를 통합하려면 공정성, 투명성, 자료보안을 보장하는 지침을 수립하는 것이 필수적이다. 엄격한 감독과 책무성을 유지함으로써 교육자는 AI 도구가 책임감 있게 사용되도록 보장하고, 교육자와 학습자 사이의 신뢰를 구축하며, 테크놀로지가 교육경험을 방해하는 대신 향상시키는 지원적 교육환경을 조성할 수 있다. 윤리17,18,50와 신뢰19,51에 기반한 프레임워크는 이러한 지침을 수립하고 실행하기 위한 잠재적 로드맵으로 제안되었다.

4. 공동생산과 협업 촉진 (Fostering coproduction and collaboration)

  • AI로 보강된 교육에 공동생산 모형(coproduction model)을 적용하면 학습자, 교육자, AI 개발자, 기타 이해관계자가 함께 학습과정을 최적화하는 협력적 접근을 촉진한다. 교육자, 기관, 산업계 파트너 사이의 협력 노력은 학습을 진정으로 개인화하는 데 효과적인 AI 도구를 개발하기 위해 매우 중요하다. 자료와 자원을 공유하고 오픈소스 이니셔티브(open-source initiatives)에 참여함으로써, 이해관계자는 의학교육의 변화하는 요구를 충족하도록 AI 응용기술을 지속적으로 정교화하고 조정하는 풍부한 생태계를 만들 수 있다.

5. AI의 영향 모니터링 및 평가 (Monitoring and evaluating AI impact)

  • AI 도구가 학습성과, 임상술기, 환자진료에 미치는 영향을 지속적으로 모니터링하고 평가하는 것이 필수적이다. 여기에는 실제 교육 환경에서 AI 응용기술의 효과를 평가하는 견고한 기제를 개발하고, 그것이 정밀교육 및 기초역량의 목표와 일치하도록 보장하는 일이 포함된다. 이를 위해 정확도와 편향 같은 AI 수행 지표를 교육 도구 및 CDS 시스템을 평가하는 기존 프레임워크에 통합할 수 있다. AI 모니터링 피로의 영향을 완화하기 위해, 확신도가 낮거나 교정적 주의가 필요할 가능성이 높은 산출물을 표시하도록 AI 도구를 설계하거나 훈련할 수 있다.

결론 (Conclusion) 

의학교육 AI 혁신가와의 면담에서 수집한 관점은 이러한 초기 단계 기술을 교수와 학습에 통합할 때의 우선과제와 도전과제에 관한 귀중한 통찰을 제공한다. 이들이 논의한 우선과제는 의학교육 AI 통합의 위협과 위험을 우회하는 로드맵을 제공하며, 정밀교육을 실현하고 핵심 의학역량을 유지하며 궁극적으로 미래 의료전문가의 준비를 향상시키는 달성 가능한 경로를 제시한다.

Acad Med. 2025 Sep 1;100(9S Suppl 1):S15-S21. doi: 10.1097/ACM.0000000000006107. Epub 2025 Jun 2.

Macy Foundation Innovation Report Part I: Current Landscape of Artificial Intelligence in Medical Education 

들어가며

AI 이야기는 이제 너무 흔해졌습니다. 그런데 막상 "그래서 의학교육에서 실제로 뭐가 되고 있는데?"라고 물으면 답이 잘 안 나오죠. 논의는 많은데 근거는 흩어져 있고, 기대와 과장(hype)을 구분하기가 어렵습니다.


이 보고서는 바로 그 지점을 겨냥합니다. Josiah Macy Jr. Foundation이 AI 학술대회를 준비하면서 위탁한 연구인데, 저자들 스스로 문제의식을 이렇게 정리해요. 지금까지의 논의는 AI의 가능성에 대한 사변적 이야기에 머물렀고, 근거에 기반한 유용성과 과장을 구분하면서 맥락별 한계를 짚어내는 포괄적 분석은 부족했다는 겁니다.

"…limited in delivering a comprehensive analysis to distinguish evidence-based utility from hype while identifying context-specific limitations."


2부작 중 1부는 문헌 리뷰를 통한 지형도 그리기이고, 2부는 이해관계자 인터뷰 연구입니다. 오늘은 1부를 정리해 봅니다. 📚


왜 하필 '정밀교육'인가

저자들이 출발점으로 삼는 개념이 정밀교육(precision education)입니다. 정의는 이렇게 인용됩니다.

"적절한 교육적 개입을, 적절한 학습자에게, 적절한 시점에 전달하는 것" —
"the right educational intervention to the right learner at the right time"


역량바탕의학교육(CBME)이 무엇을 성취해야 하는지를 명시적 역량 틀로 제시했다면, 정밀교육은 데이터 기반 개별화로 어떻게 거기에 도달할지를 다룹니다. 둘을 결합하면 획일적 교육과정을 넘어 학습자마다 동적으로 조정되는 학습 경로가 가능해진다는 거죠.

문제는 비용입니다. 그런 시스템은 지속적인 직접관찰, 피드백, 코칭을 전제하는데, 현재 임상학습환경은 극도로 단절되어 있고(highly discontinuous) 행정 부담도 큽니다. 저자들은 AI가 바로 이 실행 가능성의 병목을 풀어줄 후보라고 봅니다. 동시에 의학적 역량의 탈숙련화(deskilling) 위험을 관리하는 전략이 성패를 가른다고 못박습니다.


AI를 세 세대로 나눠 보기 🔍

용어 정리가 꽤 유용합니다. 저자들은 AI를 진화적으로 3단계로 구분합니다.

세대 성격 잘하는 일
AI 1.0 논리 기반 확률 모형(logic-based probabilistic models) 규칙이 명시된 좁은 과제
AI 2.0 과제특이적 딥러닝 분류 모형(task-specific deep learning classification) 분류(classification)
AI 3.0 범용 생성 모형(general-purpose generative models) 개방형 생성, 다음 단계 판단

여기서 중요한 대목. LLM은 "만능 재주꾼"에 가깝다는 표현이 나옵니다.

LLM은 개방형 프롬프트에 개방형 응답을 생성할 수 있는 범용 도구, 즉 "모든 분야의 재주꾼"입니다.
— LLMs are "jacks of all trades", general-purpose AI tools…


그런데 복잡도가 올라갈수록 투명성과 설명가능성은 반비례합니다. LLM의 '추론'은 단순한 AI 모형보다 덜 투명하고, 각 출력 뒤의 정보처리 과정을 설명하기 어렵습니다. 사고연쇄(chain-of-thought, CoT) 프롬프팅이 어느 정도 도움은 되지만, 예측가능성과 설명가능성이 중요한 상황에서는 전통적 머신러닝(ML)이 여전히 유효하다는 겁니다.


그래서 나오는 경고가 인상적입니다. 어떤 모형이(혹은 어떤 조합이) 그 용례에 맞는지 따지는 일이 여전히 핵심이라고요. "모든 걸 ChatGPT로 해결하려는" 유혹에도 불구하고 말이죠.

…despite the temptation to "use ChatGPT for everything."


이 한 문장, 요즘 우리 상황에도 꽤 아프게 들립니다. 😅


어떻게 지도를 그렸나

  • PubMed에서 'medical education', 'artificial intelligence', 'machine learning'과 동의어·MeSH 용어로 검색
  • 2024년 6월까지 등재된 논문 대상
  • 초록 2,327편 → 선별 → 501편 → 전문 검토 가능 455편 포함
  • 포함 기준: 의학교육에서 명확히 정의된 과제를 AI 도구로 수행한 실증연구

그다음이 이 보고서의 진짜 기여인데, 2차원 매핑입니다. 한 축은 의학교육 영역 5개, 다른 축은 AI 과제(AI task) 5개. 중복 분류를 허용했고, 범주 정의 자체를 인간-AI 협업으로 반복 정련했습니다.


  • 의학교육 영역 5: ① 입학전형(admissions) ② 강의실 기반 학습·교수 ③ 일터기반 학습·실무 ④ 평가·피드백·인증 ⑤ 프로그램 평가 및 연구
  • AI 과제 5: 지식 검색·상호작용 / 분류기 및 예측모형 / 요약기 / 가상 에이전트 / 기계시각 및 공간추론


한 장으로 보는 지형도 📊

Table 1의 논문 수를 옮기면 이렇습니다(중복 분류 허용이라 합이 455를 넘습니다).

영역 지식검색(LLM±RAG) 분류·예측 요약 가상에이전트 기계시각
입학전형 0 16 3 2 0
강의실 학습 82 73 2 10 18
일터기반 학습 41 84 5 12 41
평가·피드백·인증 133 165 9 16 33
프로그램 평가·연구 18 21 4 0 1

한눈에 보이죠. 무게중심이 평가·피드백 영역에 확 쏠려 있습니다. 반대로 프로그램 평가·연구 영역은 거의 비어 있고, 입학전형에서 지식검색·기계시각은 아예 0입니다. 지형도의 가치는 채워진 칸보다 빈 칸에 있다는 걸 잘 보여주는 표입니다.


영역별로 들여다보기

① 입학전형 (Admissions)

  • 지원자는 늘고 배경은 다양해지는데 총체적 평가(holistic review)를 하려니 자원이 감당이 안 됩니다. 세 갈래로 접근합니다.
    • 합격·매칭 예측: ML, 특히 신경망(NN)으로 예비 순위표를 만들고 교수진의 스크리닝 결과를 재현
    • 서류 체계적 검토: 자연어처리(NLP)로 에세이 내용분석, 추천서의 주체적(agentic)·공동체적(communal) 어휘 빈도 분석
    • 모집·소통 챗봇: 지원자 문의 응대 부담 경감
  • 인상적인 사례 하나. 지원자 171명의 추천서 611통을 NLP로 분석했더니, 여성 지원자 추천서에서 젠더화된 표현이 유의하게 더 많이 검출됐습니다. AI가 편향을 만들기도 하지만 탐지하는 데도 쓰인다는 양면성이죠.
  • 향후에는 다중미니면접(MMI)의 일관성·보정 문제, 특히 자원이 제한된 환경에서 LLM 기반 챗봇 면접관이 대안이 될 수 있다고 전망합니다.

② 강의실 기반 학습과 교수


  • 가장 활발히 논의되는 건 가상환자(virtual patient) 입니다. 저자들은 대본을 따라가는 방식이 아니라, 특정 질환에서 전형적으로 나타나는 병력 소견을 '대표'하도록 챗봇을 지시하는 접근을 소개합니다. 이런 챗봇을 표준화환자 역할을 하는 "에이전트 에뮬레이터(agent emulators)" 라고 부르는데, 대본이 아니니 연습 기회와 피드백이 늘어납니다.
  • 여기에 더해 임상추론 '튜터' 또는 '코치'로서의 기대, UpToDate·구글 같은 기존 검색을 넘어 맥락 안에서 정보를 검색하고 종합하는 생성형 AI의 역할이 언급됩니다. 근거바탕실무(EBP)의 핵심 요소를 강화한다는 관점이죠.
  • 교수자 입장에서는 강의·팟캐스트·영상의 녹취와 요약, 학습자 수준에 맞춘 핵심 정보 강조, 수업계획서·강의 개요 생성 등이 거론됩니다.


③ 일터기반 학습과 실무 🏥

  • 임상학습환경에서 환자안전과 학습의 균형은 전통적으로 지도전문의의 책임이었고, 학습자-지도자 간 신뢰 관계가 이를 뒷받침해 왔습니다. 그런데 여기에 AI가 들어옵니다.
    • 임상의사결정지원(CDS): 초기에는 의사결정나무 기반의 정해진 시나리오에 국한되었지만, 최신 CDS는 ML·LLM으로 영상을 포함한 복잡한 데이터를 해석. 회진 중 학습자에게 지식자원이자 피드백 도구로 기능
    • 앰비언트 AI 서기(ambient AI scribe): 문서화 부담 경감, 환자-의사 대면의 질 향상. 학습자에게는 진료 중·후 학습 시간 확보 효과
    • 기계시각 진단: 영상의학(단순촬영·CT·MRI), 심전도, 내시경, 안과, 초음파 실시간 가이드 등. 초심자 학습자의 수행을 능가하는 경우가 흔함
    • 학습경험 통합: 외래·입원·수술 경험을 역량 및 학습목표에 매핑, 증례기록(case log) 자동 생성
  • 여기서 저자들이 짚는 공백이 흥미롭습니다. 임상현장에서 AI 서기 도입은 빠르게 늘고 있지만, 정작 학습자 평가와 피드백 문서화에 활용된 사례는 아직 제한적이라는 점입니다. 자동으로 전사된 내용을 사전 정의된 템플릿이나 EHR에 넣어 교수 부담을 크게 줄일 잠재력이 있는데도요.

④ 평가, 피드백, 인증

  • 논문 수가 가장 많은 영역입니다. CBME의 발목을 잡아온 것이 실행의 편차, 자원 제약, 수행 데이터 관리·문서화의 행정 부담, 이미 여러 역할을 소화 중인 교수진의 헌신 요구였는데, AI가 이 지점들을 건드립니다.
    • 텍스트 응답 채점: 임상 요약문, 구술발표 전사본, 임상수행시험, 에세이. 한 연구에서는 전공의 임상기록의 질을 자동 채점해 점수를 대시보드에 자동 업로드, 임상추론 발달을 스스로 모니터링하게 함
    • 서술형 피드백 분석: 프로그램적 평가에서 서술 데이터는 늘 '분석이 어려워' 활용이 막혔는데, NLP·LLM으로 코멘트의 질 검토, 주제 도출, 편향 탐지가 가능. 한 연구는 NLP로 평가 코멘트를 분류한 뒤 지도학습 ML로 위험 전공의(at-risk residents) 예측모형을 구축
    • 임상역량위원회(CCC) 지원: 대량의 텍스트 데이터를 종합해야 하는 CCC의 부담 경감 가능성 (다만 현재는 '예상'되는 수준)
    • 가상환자 시뮬레이터(VPS)·지능형 튜터링 시스템(ITS): 수술 시뮬레이션 중 술기·의사결정·지침 준수에 즉각 피드백. 병력청취 평가에서 자원집약적 표준화환자 의존도를 낮추는 OSCE 대안으로도 사용
    • 예측분석에서 처방분석으로: 단순히 미래 수행을 예측하는 데 그치지 말고, LLM으로 복잡한 분석 결과를 해석 가능하고 실행 가능한 다음 단계로 번역해 학습자에게 직접 전달하자는 제안(prescriptive analytics)
  • 면허시험 성적도 정리되어 있는데, 편차가 큽니다. 국가·전문과목별 합격률이 프랑스 22%에서 사우디아라비아 89%까지 분포했고, 대부분은 합격선을 넘었습니다. GPT-4는 이스라엘 전문의시험 5개 과목 중 4개에서 합격점을 받았고, 정신과에서는 대다수 의사를 능가했습니다.

⑤ 프로그램 평가와 연구

  • CBME로 학습자 수행 데이터의 양과 종류가 폭증했지만, 상당수가 서술형이라 수작업 분석은 비현실적입니다. AI는 대규모 서술 데이터를 일관되게 질적으로 분석해 경향을 정량화할 수 있습니다.
    • 일반외과 전공의 프로그램 319곳의 다양성 성명서를 NLP로 분석 — 단어 수, clout 점수(전달되는 확신의 정도), 긍정적 어조 점수로 DEI 실천 의지를 가늠
    • LLM으로 학습자와 지도자가 임상적 신뢰(clinical trust) 판단에서 중요하게 보는 요인의 차이를 탐지
    • 교수 승진 승인 확률 예측, 사회인구학적·학업 이력 기반 학업 성공 예측, 역량바탕 vs 규준참조 평가체계에서의 번아웃 위험 비교
  • 이 영역은 사례 수가 적습니다. 뒤집어 말하면 가장 열려 있는 영역이기도 합니다.

그래서, 한계는? ⚠️

저자들은 한계를 기술 내재적인 것과 인간 요인에서 오는 것으로 나눕니다. 이 구분이 꽤 유용합니다.

기술적 한계: 정확성과 편향


  • 첫째, 투명성과 설명가능성입니다. AI 출력 뒤의 의사결정 과정이 불투명해서 정확성과 신뢰성 검증이 어렵습니다.
  • 둘째, 작화(confabulation). 틀리거나 지어낸 정보를 자신 있게 제시하는 문제죠. (저자들은 'hallucination'이 아니라 'confabulation'이라는 용어를 씁니다. 인용된 참고문헌 제목 자체가 챗봇의 작화는 환각이 아니라는 취지입니다.)
  • 셋째, 아첨(sycophancy). 사용자의 선호를 그대로 반영하거나 기대하는 답만 내놓는 경향이 출력의 정확성과 질을 떨어뜨립니다. 교육 맥락에서 이건 생각보다 심각한 문제입니다. 학습자가 듣고 싶은 말을 해주는 피드백 도구라니요.
  • 넷째, 학습 데이터에 스며든 체계적 편향과 진료 격차가 건강 불평등을 증폭시킬 수 있습니다. 그래서 저자들은 이렇게 정리합니다. 학습자가 AI를 일차 지식원(first-line source of knowledge)으로 쓰는 것은 권장하기 어렵고, AI 생성 권고의 진위와 적용가능성을 판단하는 능력 자체가 새로운 역량으로 부상하고 있다고요.
  • 다섯째, 표준화환자와 비교했을 때의 한계. 사람 표준화환자는 언어의 뉘앙스, 신체언어, 정서에 반응하는데 AI는 아직 이를 재현하지 못합니다.
  • 여섯째, 이게 특히 중요한데 — AI 지원으로 향상된 수행이 AI 없는 환경으로 전이되지 않는다는 연구들이 있습니다. 지식과 술기의 장기적 파지에 미치는 영향은 아직 불분명합니다.


인간·실행 측면의 한계: 과의존과 탈숙련화


  • AI는 초심자의 진단 수행을 측정 가능한 수준으로 향상시킵니다. 그런데 모델에 대한 비판적 평가 없는 과의존은 편향과 오류의 전파, 개인정보 문제, 타당하지 않은 정보, 교수자의 학습자 진전에 대한 감시 약화, 그리고 사회적 상호작용 감소로 이어질 수 있습니다.
  • 마지막 항목이 눈에 띕니다. 저자들은 동료·지도자·학습자 간 사회적 상호작용이 신뢰 형성, 학습자와 직무 만족, 그리고 술기 피드백을 넘어선 경력 멘토링 기회에 결정적이라고 강조합니다. AI가 대체하기 가장 어려운 것이 여기라는 거죠.


마무리: 다음 단계 🎯

저자들이 제시하는 방향은 간명합니다.

  • 학습자와 현직 임상의의 기초 지식·기술에 AI 리터러시, AI 산출물에 대한 비판적 평가, 효과적인 인간-AI 협업이 포함되도록 확장할 것
  • 학습자가 AI 도구를 환자진료에 유능하게 통합할 수 있도록 교육과정을 지속적으로 갱신할 것
  • AI가 의학교육에 미치는 영향을 지속적으로 모니터링하여 공백, 편향, 의도치 않은 결과를 확인할 것

읽고 나서 남는 생각 💭

세 가지가 남습니다.


  • 첫째, 지형도의 빈 칸. 논문 455편이 평가·피드백에 몰려 있다는 건, 그쪽이 가장 유망해서일 수도 있지만 측정하기 쉽고 논문 쓰기 좋아서일 수도 있습니다. 프로그램 평가와 연구 영역이 거의 비어 있다는 사실이 오히려 더 많은 걸 말해줍니다.
  • 둘째, "모든 걸 ChatGPT로" 하려는 유혹. 예측가능성과 설명가능성이 중요한 과제에는 전통적 ML이 더 낫다는 지적은, 우리 현장에서 새 도구를 도입할 때 되짚어야 할 기준점입니다. 도구 선택이 곧 설계 결정입니다.
  • 셋째, 전이의 문제. AI가 있을 때 잘하는 것과 AI 없이 잘하는 것은 다릅니다. 평가 설계에서 이걸 어떻게 다룰지는 아직 아무도 답을 못 냈습니다. 탈숙련화 논의가 추상적 걱정이 아니라 평가 타당도의 문제로 넘어오는 지점이죠.


Part II는 이해관계자 인터뷰를 통해 "hype에서 현실로" 넘어가는 과정의 위험과 우선순위를 다룹니다. 이어서 정리해 보겠습니다.


의료 실무에 인공지능(AI)을 통합하는 것은 진단 정확도 향상, 개인맞춤형 치료 계획(personalized treatment plans), 운영 효율성 개선을 통해 환자 진료를 혁신하고, 임상의가 정밀의료(precision medicine)의 약속을 실현하도록 도울 것으로 기대된다. 이와 유사하게 의학교육을 변혁할 AI의 잠재력도 주목받고 있으며, “적절한 학습자에게 적절한 시점에 적절한 교육적 개입을 제공하는 것”으로 설명되는 정밀교육(precision education)을 실현할 전례 없는 기회를 제시한다.1 역량바탕 의학교육(competency-based medical education, CBME)의 명시적 역량 체계와 정밀교육의 데이터 기반 개인맞춤화(data-driven personalization)를 통합하면, 의학교육은 모든 학습자에게 동일하게 적용되는 교육과정(one-size-fits-all curricula)을 넘어 각 학습자의 필요에 역동적으로 적응하는 개별화 학습경로(individualized learning pathways)로 나아갈 수 있다. 교육의 “정밀성(precision)”을 구현하려면 교육자가 학습자 데이터를 수집하고 평가하며, 학습자의 역량에 대한 통찰을 도출하고, 학습자에게 표적화된 개입(targeted interventions)을 조기에 제공해야 한다.2 현재와 같이 학습 경험의 연속성이 매우 낮은 교육환경에서 이러한 평가체계는 학습자에 대한 지속적·직접적 관찰과 피드백 및 코칭에 의존하며, 상당한 행정 업무와 부담을 수반한다. AI는 역량바탕 정밀교육(competency-based precision education)의 실행에 따르는 이러한 과제를 잠재적으로 해결할 수 있다. 의학 역량의 탈숙련화(deskilling) 위험을 완화하면서 AI의 안전한 사용을 촉진하는 전략이 성공적 실행의 핵심이 될 것이다.


AI 기술은 빠르게 발전하고 있으며, 의학교육자가 신중하게 분석하고 충분한 정보에 근거해 의사결정해야 하는 기회와 과제를 동시에 제시한다. 이 중대한 필요에 대응하기 위해 Josiah Macy Jr. Foundation은 의학교육에서 AI의 현재 지형과 그것이 미래에 미칠 함의를 조사하도록 저자들에게 의뢰하였다. 이 위탁 연구의 결과는 AI의 윤리적이고 효과적인 통합을 보장하기 위한 권고안3 개발에 초점을 둔 재단의 ‘의학교육과 AI 학술대회(Conference on AI and Medical Education)’ 논의의 틀을 마련하는 데 기여하였다. 이 2부 구성 위탁 연구 보고서의 제1부에서, 저자들은 교수·학습·평가에 미칠 잠재적 영향을 이해하기 위해 광범위한 문헌고찰을 기술하고 의학교육에서 AI의 현재 지형을 개관한다. 또한 의학교육의 AI 혁신과 관련된 새로운 동향에 대한 비판적 통찰을 제공하고, 공백을 확인하며, 효과적 통합을 위한 권고안을 제시한다. 이 정보는 다음 3개 절로 제시된다.


  • (1) AI 모형과 의학교육 AI 지형 매핑 과정의 배경,
  • (2) 의학교육 AI 지형에서 매핑된 영역에 대한 설명,
  • (3) 현재 AI 도구의 한계와 의학교육의 향후 과제에 대한 논의.


이 부록에 함께 수록된 보고서 제2부, “메이시 재단 혁신 보고서 제2부: 과장에서 현실로—의학교육에서 AI 통합의 과제를 헤쳐 나가기 위한 혁신가들의 전망(Macy Foundation Innovation Report Part II: From Hype to Reality: Innovators’ Visions for Navigating the Challenges and Risks of Integrating AI in Medical Education)”4은 구조화 면담 연구(structured interview study)의 결과를 논의한다. 이 연구는 의학교육 공동체가 주목해야 할 잠재적 이점, 위험, 우선순위 영역에 관한 이해관계자의 관점을 수집하였다. 혁신 보고서의 두 부분은 함께 윤리 및 실행상의 우려를 포함하여 의학교육 AI의 현재 상태에 대한 핵심 통찰을 제공하며, 이는 Macy 학술대회 권고안3을 마련하는 데 기여하였다.

AI 모형과 지형 매핑 과정 (AI Models and the Landscape Mapping Process) 

AI는 진화 과정에 따라 다음 3가지 유형으로 구분할 수 있다.


  • 논리 기반 확률 모형(logic-based probabilistic models, AI 1.0),
  • 과업 특이적 딥러닝 분류 모형(task-specific, deep learning classification models, AI 2.0), 그리고
  • 오늘날의 보다 범용적인 생성 모형(general-purpose generative models, AI 3.0)이다.5

AI 1.0과 2.0 모형은 특히 분류(classification), 즉 기계학습(machine learning, ML)을 사용하여 텍스트·이미지·기타 데이터를 미리 정의되었거나 발견 가능한 유형으로 나누는 협소한 과업에 적합하다. 시간이 지나 컴퓨터 처리 능력이 향상되면서 ML은 AI 3.0 모형이 인간의 입력을 바탕으로 새로운 데이터 또는 산출물을 생성하고, 그 데이터를 즉시 활용하여 그다음의 “차선의 최적 단계(next best step)”를 결정할 수 있게 하였다. (AI 용어집은 디지털 보충 부록 1, http://links.lww.com/ACADMED/B727 참조.)

acadmed_2025_05_28_boscardin_acadmed-d-25-00787_sdc1.pdf
0.24MB

가장 널리 사용되는 AI 3.0 모형 중 하나는 대규모 언어 모델(large language model, LLM)이다. LLM은 방대한 텍스트 데이터 말뭉치(corpus)를 학습하여 가장 적합한 텍스트 배열을 예측하고 인간 언어를 모방하며, 모든 인간 경험 지식을 군집화한 것에 대한 보조 수단으로도 생각할 수 있다. 따라서 LLM은 개방형 프롬프트(open-ended prompts)에 개방형 응답을 생성할 수 있는 범용 AI 도구, 즉 “만능 재주꾼(jacks of all trades)”이다. 혁신적인 그래픽 사용자 인터페이스(graphical user interfaces)는 LLM(예: Generative Pre-trained Transformer, GPT)을 복잡한 인간 대화를 모방하는 챗봇이나 자율 에이전트(autonomous agents)(예: ChatGPT)로 구현한다. LLM의 학습 데이터는 특정 시점까지의 지식을 포착한 스냅숏처럼 시간적으로 고정되어 있지만, 일부 챗봇은 인터넷을 포함한 외부 데이터베이스 및/또는 사용자가 제공한 자료를 검색하여 최신 결과를 생성할 수 있다. 이러한 유연성 덕분에 LLM은 다양한 활용 사례(use cases)에 고려될 수 있다.


그럼에도 이러한 인간 사고의 모사물(simulacra)은 컨파뷸레이션(confabulation, 정보의 허위 재구성)6을 일으키거나 학습 데이터에 존재하는 편향된 인공물(biased artifacts)을 표현할 수 있으며, 이는 감독 없이 사용할 때 중대한 함의를 지닌다.7 또한 AI의 복잡성은 투명성(transparency) 및 설명가능성(explainability)과 역의 상관관계를 보인다. LLM의 “추론(reasoning)”은 더 단순한 AI 모형보다 덜 투명한 것으로 여겨지므로, 각 산출물의 배후에서 이루어진 정보처리를 설명하기 어렵다. “소리 내어 생각하기(think out loud)”를 요구하는 사고사슬(chain-of-thought, CoT) 프롬프팅이 LLM의 문제해결 능력을 증폭하고 투명성과 해석가능성(interpretability)을 높일 수 있지만, 전통적 ML과 다른 AI 모형은 더 높은 예측가능성(predictability)과 설명가능성을 지니므로 여전히 필수적이다. 따라서 “모든 것에 ChatGPT를 사용”하고 싶은 유혹에도 불구하고, 주어진 활용 사례에 어떤 AI 모형 또는 모형의 조합이 가장 적합한지를 숙고하는 일은 여전히 중요하다.


AI 지형이 빠르게 진화하고 있음에도, 현재 지형을 개관하고 공백을 드러내며 의학교육 내부의 개별 과제에 대한 잠재적 AI 해결책과 그 한계를 파악하려면 문헌고찰이 필요하다. 저자들은 출판된 연구를 검토하고 선행 주제범위 문헌고찰(scoping review)8을 토대로, 의학교육에서 AI의 지형을 탐색하고 AI 적용을 교육 관련 활동에 매핑하였다. AI가 의학교육에 어떻게 적용될 수 있는지를 이해하기 위해 문헌을 매핑한 과정은 다음과 같았다. PubMed에서 “medical education”, “artificial intelligence”, “machine learning” 및 그 동의어(그리고 관련 Medical Subject Heading 용어)를 검색하여 의학교육 문헌을 탐색하였다. 검색에는 2024년 6월까지 PubMed에 등재된 모든 원고가 포함되었다. 검색 결과 초록 2,327편이 확인되었고, 이 가운데 의학교육에서 명확히 정의된 과업을 수행하기 위해 AI 도구를 사용한 실증 연구(empirical studies)만 포함하도록 추가 선별하였다. 이 선별을 통해 501편의 원고가 남았으며, 그중 전문(full text)이 적격한 455편을 이 문헌고찰에 포함하였다. 또한 AI 도구가 의학교육에서 해결하려 했던 명시적·암묵적 목적과 표방된 문제를 함께 탐색하였다.


AI가 의학교육 활동을 지원하고 향상할 잠재력을 더 잘 이해하기 위해, 저자들은 현재의 AI 지형을 5개의 주요 의학교육 영역, 즉


  • (1) 입학·선발,
  • (2) 교실 기반 학습과 교수,
  • (3) 일터 기반 학습과 교수,
  • (4) 평가·피드백·인증,
  • (5) 프로그램 평가와 연구


...에 걸쳐 매핑하면서 다양한 AI 모형이 수행하는 과업을 부각하였다(표 1 및 디지털 보충 부록 2, http://links.lww.com/ACADMED/B728 참조). AI 과업은 특정한 인간의 문제해결 과업을 증강(augmenting)하는 활용 사례를 뜻하며, 다양한 AI 모형이 사용될 수 있다. 이러한 AI 과업에는


  • 지식 검색(knowledge retrieval),
  • 의사결정 지원을 위한 분류기와 예측 모형(classifiers and predictive models),
  • 요약기(summarizers),
  • 가상 에이전트(virtual agents),
  • 기계시각 도구(machine vision tools)가 포함된다.


이어서 검토한 모든 원고에서 AI 과업과 관련 의학교육 활동을 추출하고, 인간-AI 협업(human-AI collaboration)을 통해 각 범주를 정의하였다. 이 협업은 예상 범주 집합을 전체 전문 원고 데이터베이스에 여러 차례 반복 적용하고, 매 반복 후 해당 범주와 정의를 정련하는 방식으로 이루어졌다. 각 원고를 확인된 AI 과업과 관련 의학교육 활동에 따라 분류하여 2차원 매핑(two-dimensional mapping)을 수행하였고, 범주 간 중복을 허용하였다. 매핑에서 확인된 범주화 원고, 즉 표 1의 각 셀에 해당하는 원고를 수작업으로 검토한 결과를 바탕으로 연구 결과를 작성하였다. 포괄적이지는 않지만, AI 과업 범주는 의학교육 문헌에서 보고된 가장 일반적인 AI 활용 사례를 나타낸다. 

표 1. 교육 관련 활동과 이를 지원하는 AI 과업 (Education-Related Activities and the AI Tasks That Support Them) 

영역
(Domain)
지식 검색과 상호작용
(LLM ± RAG)
분류기와 예측기
(LLM, NN, 전통적 ML)
요약기
(LLM, 음성 인식)
가상 에이전트
(LLM)
기계시각과 공간추론
(NN, LLM, 확산모형)
입학·선발
(Admissions)
N = 0 N = 16
•  추천서와 자기소개서의 주제 및 편향 식별
•  지원서 선별·순위화
N = 3
•  추천서와 자기소개서 생성
N = 2
•  정보 제공용 챗봇
N = 0
교실 기반 학습과 교수
(Classroom-based learning and teaching)
N = 82
•  지식 참조
•  학습 사례 생성
•  임상추론 지원
•  개인맞춤형 교육과정
N = 73
•  학습 요구 식별
•  추가 읽기자료 제안
N = 2
•  학습보조자료·플래시카드 생성
N = 10
•  의사소통 시뮬레이션·가상 환자
•  가상 튜터
N = 18
•  술기 시뮬레이션
•  신체 소견 이미지 생성
일터 기반 학습과 실무
(Workplace-based learning and practice)
N = 41
•  지식 참조
•  CDS·DDS
•  문서화에 대한 피드백
N = 84
•  문서화 피드백
•  환자 진료 분석
N = 5
•  AI 서기(받아쓰기·문서화)
•  사례 통합 및 기록, 임상경험 추적
N = 12
•  임상 의사결정을 위한 가상 코치
N = 41
•  영상의학·병리학·심장학·피부과 해석
•  술기 안내(로봇수술 포함)
평가·피드백·인증
(Assessment, feedback, and certification)
N = 133
•  평가 내용과 정답 생성: MCQ·OEQ·사례
•  개인맞춤형 시험 피드백 생성
N = 165
•  자동 채점
•  수행 예측
•  역량 범주화
•  서술형 피드백 주제
N = 9
•  서술형 평가와 피드백 요약
•  수행 대시보드
•  학생 자기평가의 평가
N = 16
•  OSCE와 기타 평가를 위한 가상 표준화환자
N = 33
•  술기 수행 평가
•  시선추적 분석
프로그램 평가와 연구
(Program evaluation and research)
N = 18
•  교육과정·과목·임상실습 평가·감사
•  문헌 탐색
N = 21
•  코딩과 주제분석
•  편향 식별
•  번아웃 위험 예측
•  진로 경향 예측
N = 4
•  교육과정 내용 평가 및 매핑
N = 0 N = 1
•  교육자료의 환자 다양성 평가

약어: AI, 인공지능(artificial intelligence); CDS, 임상 의사결정 지원(clinical decision support); DDS, 진단 지원(diagnostic support); LLM, 대규모 언어 모델(large language model); LOR, 추천서(letter of recommendation); MCQ, 선다형 문항(multiple choice question); NN, 신경망(neural network); OEQ, 개방형 문항(open-ended question); OSCE, 객관구조화진료시험(objective structured clinical examination); RAG, 검색증강생성(retrieval-augmented generation); Trad ML, 전통적 기계학습(traditional machine learning).

주 a: N은 글머리표로 제시된 활동과 관련된 검토 논문의 수를 의미한다.


저자들은 대표적인 AI 활용 사례를 괄호 안의 논문 식별번호(article identification number)와 함께 제시하고, 현재 도구의 한계와 추가 개발 및 탐색이 필요한 영역을 강조한다. 아래에서는 5개 의학교육 영역의 현재 AI 지형을 기술한다.

AI와 의학교육 영역 (AI and Medical Education Domains) 

입학·선발 (Admissions) 

현재 의과대학과 전공의 수련프로그램의 입학·선발 과정은 서로 다른 특성, 배경, 경험을 지닌 다양한 지원자가 점점 늘어나는 상황에서 총체적 검토(holistic review)를 시행하는 데 상당한 어려움과 많은 자원이 요구된다. 이러한 과제에 대응하기 위해 사용된 AI 적용은 다음과 같다.


  • (1) 성공적인 입학과 매칭을 예측하는 모델링에 ML 사용,
  • (2) 자연어 처리(natural language processing, NLP)를 사용한 추천서와 지원서의 체계적 검토,
  • (3) 의사소통 및 모집을 위한 챗봇 에이전트.


입학·선발 결과 예측(Predict admissions outcomes).


  • ML 알고리듬은 순위에 오르거나, 입학하거나, 매칭되거나, 면접 초대를 받을 가능성이 높은 지원자를 식별하기 위해 사용되어 왔으며, 그 성공 정도는 다양하였다. 이러한 알고리듬은 표준화 평가를 포함한 인구통계학적 자료와 기타 입학·선발 자료 기준을 활용하여 선발 선별(selection screening)을 자동화하고 프로그램의 부담을 줄이는 데 도움을 준다(A-ID 19, 20, 51, 245, 428). 많은 연구에서 ML은 지원자 표현형(applicant phenotypes)의 복잡한 패턴을 효율적으로 탐지하고, 정확도를 높이며, 전통적 입학·선발 업무흐름으로는 처리하기 어려운 대규모 데이터세트를 활용해 예측 과정을 자동화하도록 최적화되었다. 특히 신경망(neural networks, NNs)을 활용한 ML은 여러 연구에서 예비 순위명단을 만들고 교수자의 선별 결과를 재현하는 데 사용되었다(A-ID 95, 96, 103, 113, 137, 200, 205).


추천서의 체계적 검토(Systematic review of letters).


  • NLP는 입학 예정자의 지원서에서 특정 텍스트 구절을 추출하고 주석을 다는 데(A-ID 19), 지원 에세이의 내용분석(content analysis)을 수행하는 데(A-ID 43, 84, 230), 추천서에서 주도성(agentic) 및 공동체성(communal)을 나타내는 단어의 빈도를 파악하기 위한 의미 분석(semantic analysis)을 수행하는 데(A-ID 212, 221), 그리고 입학·선발 기준에 부합하는 지원 에세이의 특정 단어를 선별하는 데 사용되고 있다(A-ID 245, 474). 이러한 AI 활용 사례는 NLP와 LLM의 효율성을 활용하여 대량의 서사 및 텍스트 데이터를 분석하고, 패턴을 식별하고, 자료를 요약하며, 지원자를 분류를 위한 특정 집단으로 군집화한다(A-ID 26, 197, 455). 서사 데이터의 패턴을 탐지하는 AI의 가치는 NLP를 사용하여 지원자 171명의 추천서 611편 이상을 분석한 한 연구에 잘 나타난다. 이 연구는 성별화된 언어(gendered language)에 유의한 차이가 있으며, AI가 여성 지원자의 추천서에서 성별화된 표현을 더 많이 탐지했음을 확인하였다.9


모집(Recruitment).


  • 여러 산업에서 지원자를 선별하기 위해 챗봇 도구가 점점 더 많이 사용되고 있다.10 한 펠로십 프로그램 연구는 잠재적 지원자와 양방향 교류와 의사소통을 수행하는 챗봇을 사용함으로써 질문에 응대하는 직원의 부담이 어떻게 감소했는지를 기술하였다(A-ID 301). 선발 과정의 일부로 흔히 사용되는 다중미니면접(multiple mini-interviews, MMIs)은 자원 집약적일 수 있으며, 여러 면접자 사이에 일관성과 보정(calibration)을 확보하기가 어려울 수 있다. 향후 인간 면접자를 모방할 수 있는 LLM 기반 챗봇은 특히 자원이 제한된 환경에서 MMI 시행의 일부 과제를 해결할 가능성이 있다.


교실 기반 학습과 교수 (Classroom-Based Learning and Teaching) 

표준화환자(standardized patients), 모의 사례(simulated cases), 실제 환자를 활용하여 교실 기반 교육내용과 경험학습(experiential learning)을 연계하면 임상추론과 기타 술기의 발달을 향상할 수 있다(A-ID 225). 그러나 의학교육의 초기 단계에서 교실 기반 학습을 경험학습으로 보강하려면 많은 시간과 자원이 필요하다. 학습자는 임상추론을 뒷받침하기 위해 끊임없이 확대되는 지식체계를 탐색해야 하는 것과 같은 추가적 과제에도 직면한다. AI는 가상 환자를 제공하고, 교육과정 설계를 지원하며, 지식을 검색·종합·습득하는 새로운 방식을 제공함으로써 이러한 문제를 해결할 가능성을 제시한다.


가상 병상 곁의 가상 코치(Virtual coach at the virtual bedside).


  • 환자 사례를 재현하도록 학습된 AI 챗봇은 제한된 환자 가용성, 접할 수 있는 질병과 환자 양상 범위의 공백, 자원의 제약, 환자 진료의 확률성(stochasticity)에 대응할 기회를 제공한다. 표준화환자 역할을 하는 “에이전트 에뮬레이터(agent emulators)”로 학습된 AI 챗봇을 활용하겠다는 전망은 여러 연구팀에 의해 현실화되었다(A-ID 12, 61, 93, 107, 172, 243, 255, 315, 423, 470, 490). AI 챗봇이 인간의 의사소통을 모방하고 개방형 질문에 답할 수 있다는 점을 활용하면, 의학교육자는 정해진 대본을 따르게 하는 대신 환자 상태의 전형적 병력 소견을 재현하도록 챗봇을 지시할 수 있어 더 많은 연습 기회와 피드백을 제공할 수 있다. 이러한 가상 환자와 더불어, 교육자들은 학생의 학습 요구를 평가하고 평가·학습 사례·시뮬레이션에서 지향성 있는 내용을 제공할 수 있는 가상 임상추론 “튜터(tutor)” 또는 “코치(coach)”로 AI를 사용하는 데 낙관적 기대를 표해 왔다.
  • 또한 학습자와 교육자는 이미 기존 검색 도구(예: UpToDate, Google)를 사용해 의학 내용을 찾고 있지만, LLM을 이용하는 생성형 AI 도구는 특정 맥락, 즉 특정 질문이나 사례 시나리오에서 정보를 검색하고 종합하는 능력을 추가함으로써 이러한 기술을 향상할 수 있고, 이를 통해 근거 기반 실무(evidence-based practice)의 핵심 구성요소를 강화할 수 있다(A-ID 97, 295). 아울러 학생의 응답에 피드백을 제공하는 LLM의 역량도 잠재적 교수 방법(teaching modality)으로 탐색되고 있다(A-ID 470, 292).


음성 인식과 요약을 위한 LLM(LLMs for speech recognition and summarization).


  • 이러한 AI 적용은 강의·팟캐스트·비디오를 녹음하고 요약함으로써 다중양식 학습 접근(multimodal learning approaches)을 지원하고 학습을 최적화할 수 있으며, 여기에는 학습자 수준에 맞는 중요 정보를 강조하는 기능도 포함된다(A-ID 42). 교수자는 LLM의 요약 능력을 활용해 수업계획, 프레젠테이션 및 강의 개요를 생성하고 최신 문헌을 검토할 수도 있다. 의학교육 이외의 한 연구11에서는 LLM과 이미지 생성기를 결합하여 텍스트-텍스트 요약(text-to-text summary), 텍스트-이미지(text-to-image), 텍스트-비디오(text-to-video) 생성을 포함한 여러 대안적 콘텐츠 전달 양식을 교수자에게 제공함으로써 학습자를 위한 개인맞춤형 학습 기회를 촉진하였다.


일터 기반 학습과 실무 (Workplace-Based Learning and Practice) 

임상학습환경(clinical learning environment)에서 환자 안전과 수련생 학습 사이의 균형은 전통적으로 지도 전문의(supervising attending)의 주된 책임이었으며, 학습자와 지도자 사이에 형성된 신뢰 관계가 이를 뒷받침해 왔다.12 그러나 AI는 데이터 해석과 진단, 치료 계획 수립, 문서화 자동화를 포함한 임상 의사결정을 지원하는 데 점점 더 많이 사용되고 있다.


임상 의사결정 지원(Clinical decision support).


  • 문헌은 학습자에게 영향을 미치는 임상실무 AI 사용이 다음 두 가지로 증가하고 있음을 기술한다. 임상 의사결정 지원 시스템(clinical decision support systems, CDS)은 임상의에게 진단·치료·예후 지원을 제공하는 자동화 절차를 포괄적으로 지칭한다. 초기 CDS는 임상 알고리듬에 따라 입력과 출력이 정의된 의사결정나무(decision trees)로 임상 의사결정을 표현하는 전문가 시스템(expert systems, AI 1.0)에 기반했기 때문에 미리 정의된 시나리오로 범위가 제한되었다. 최근의 CDS13는 ML과 LLM을 점점 더 많이 사용하여 이미지를 포함한 복잡한 데이터를 해석하며, 임상실무와 교수에서 역할을 확대해 왔다. 여기에는 입원 회진 중 학습자에게 지식 자원과 피드백 도구로 기능하는 것도 포함된다(A-ID 295).
  • 대화에 ML을 적용하여, 즉 오디오 파일을 분석하여 실시간으로 서기(scribe)와 같은 기능을 수행하는 주변형 AI 서기(ambient AI scribes)는 문서화 부담을 줄이고, 의사-환자 만남을 향상하며, 임상의의 역량을 보강할 가능성이 있는 것으로 점점 더 인식되고 있다.12,14,15 학습자에게 AI 서기는 임상실무에 대한 숙고된 참여(deliberate engagement)와 환자 진료 중·후의 학습 시간을 늘릴 수 있다.16 AI 서기는 전사된 정보를 미리 정의된 템플릿이나 전자의무기록(electronic health records, EHRs)에 자동으로 정리·입력하여 필요한 모든 세부사항을 일관되고 효율적으로 포착함으로써, 학습자 평가와 피드백을 문서화하는 교수자의 부담을 현저히 줄일 가능성이 있다. 그러나 임상환경에서 도입이 증가하고 있음에도, 피드백과 평가 문서화에 AI 서기를 사용하는 것은 아직 제한적이다.


기계시각 보조 진단(Machine vision-assisted diagnostics).


  • 영상의학 판독, 심전도(electrocardiogram, ECG) 해석, 시술 중 진단(예: 안과, 내시경)과 같은 시각적 진단 과업을 수행하는 AI의 역량은 초보 학습자의 능력을 능가하는 경우가 많다.15 예를 들어 영상의학에서는 단순 방사선영상, 컴퓨터단층촬영(computed tomography, CT), 자기공명영상(magnetic resonance imaging, MRI)의 해석을 지원하고, 초음파 기법 수행을 실시간으로 안내하는 데 AI가 사용되어 왔다(A-ID 7, 116). 한 영상의학과 수련프로그램에서는 전공의가 AI 도구와 상호작용한 내용을 바탕으로 자동 피드백과 교육자료 링크를 CDS에 추가하였으며, 자동 피드백이 포함된 CDS로 시뮬레이션 사례를 보강하는 것이 교육적 가치를 더할 가능성이 있다고 제안하였다(A-ID 7). 수술 중 환경에서 AI는 내시경 영상 피드를 해석하고, 신장 종괴를 식별하며, 망막 병리를 인식하는 데 사용되어 왔다. 심장학에서는 심초음파 수행 안내, ECG 해석, 심장 관류 스캔 평가에 사용되었다(A-ID 119, 447, 156, 148, 189, 280).


학습의 통합(Consolidate learning).


  • 외래 방문, 입원, 수술 사례를 포함하여 여러 환자 만남에 걸친 학습 경험을 통합하는 일은 일관성을 유지하는 데 중요하며 학습자 발달에 필수적이다. AI 도구는 학습자의 환자 경험을 통합하여 역량 및 학습목표와 매핑하고(A-ID 52, 198, 47), 사례기록(case logs) 생성을 자동화하는 데 사용되어 왔다(A-ID 55). 학습자의 임상기록과 EHR 상호작용에 피드백을 제공할 수 있는 AI 도구는 개인맞춤형 학습자료와 통합 학습의 기회를 제공하도록 개발되고 있다(A-ID 44, 50).


평가·피드백·인증 (Assessment, Feedback, and Certification) 


  • 개별화된 학습 궤적(tailored learning trajectories), 지속적인 데이터 기반 평가(continuous data-driven assessment), 개인맞춤형 피드백과 코칭을 통해 CBME와 정밀교육 원리를 통합하면 임상역량의 표적화된 발달을 향상하고, 학습자 진전의 종단적 모니터링(longitudinal monitoring)을 가능하게 하며, 각 학습자의 고유한 필요에 맞춘 개별화 지원을 보장할 수 있다. 그러나 CBME의 성공은 실행의 변이(implementation variability), 자원의 제약, 수행 데이터를 관리하고 문서화하는 교수자와 직원의 행정 부담, 이미 여러 책무를 조율하고 있는 교수자에게 상당한 노력과 헌신을 요구한다는 점을 포함한 여러 과제로 인해 제한되어 왔다.
  • 평가 과업에 AI를 적용하면 현재의 일부 과제를 완화할 수 있다. 여기에는
    • (1) ML과 생성형 AI를 사용하여 에세이·환자기록·단답형 문항의 채점을 자동화하고, 술기 수행을 포함하여 학습자에게 피드백을 제공하는 것(A-ID 84, 341, 342),
    • (2) NLP와 생성형 AI를 사용하여 서술형 논평과 피드백을 분석하는 것(A-ID 53, 455, 478),
    • (3) 가상현실(virtual reality)과 생성형 AI를 사용하여 시뮬레이션 및 가상 환자 경험에서 나타난 학습자의 임상술기를 평가하는 것(A-ID 12, 56, 217, 315, 490),
    • (4) ML과 예측분석(predictive analytics)을 사용하여 표적화된 개입을 위해 학습자의 잠재적 수행 및 지식 격차를 조기에 식별하는 것(A-ID 497)이 포함된다.


텍스트 기반 응답 채점(Grading text-based responses).


  • 여러 연구에서 ML 도구는 임상 사례 요약(A-ID 7, 62, 84, 342), 구두 발표 전사본(A-ID 456)을 포함한 텍스트 기반 응답을 채점하고, 임상술기시험과 에세이에 점수를 부여하는 데 사용되었다(A-ID 225). 한 적용 사례(A-ID 503)에서는 전공의 임상문서의 질을 자동으로 채점하기 위해 ML을 사용하였다. 이후 점수가 전공의의 대시보드에 자동으로 업로드되어 진전에 대한 피드백을 제공하고 임상추론 능력의 발달을 모니터링하도록 도왔다.


서술형 피드백의 텍스트 분석(Text analysis of narrative feedback).


  • 프로그램화 평가(programmatic assessment)에서 서술형 평가자료를 체계적으로 활용하는 일은 방대한 텍스트 데이터 말뭉치에서 패턴을 종합하고 식별하기 어렵기 때문에 난제로 남아 있었다. 그러나 NLP와, 더 최근에는 LLM 같은 AI 도구를 활용하면 서사 데이터를 효율적으로 분석하여 논평의 질을 검토하고, 특정 주제(예: 개선 영역)를 식별하고, 편향을 탐지하고, 채점을 자동화할 수 있다. 한 연구에서는 먼저 NLP를 사용하여 서술형 평가 논평을 자동 분석하고 분류하였다(A-ID 155). 이어서 이 평가 논평에 지도학습 ML 분석(supervised ML analysis)을 적용하여 위험 전공의(at-risk residents)를 식별하는 예측 모형을 생성하였다. 임상역량위원회(clinical competency committees, CCCs)를 성공적으로 운영하는 데 따르는 과제 중 하나는 텍스트 자료를 포함한 대량의 데이터를 관리하고 종합해야 한다는 점이다. NLP와 LLM의 현재 활용을 확장해 보면, 텍스트 분석과 예측 모형을 위한 AI의 최적화가 향후 CCC의 효율성을 높이고 자원 부담을 줄일 수 있을 것으로 저자들은 예상한다.
  • 또한 AI 기반 가상 환자 시뮬레이터(virtual patient simulators, VPS)와 지능형 튜터링 시스템(intelligent tutoring systems, ITS)은 임상술기시험의 진정성(authenticity)을 높이고 실시간 피드백을 제공하여 임상추론과 의사결정 능력의 평가를 개선한다. 예를 들어 VPS는 모의 수술 중 학습자의 행동을 추적하고 술기, 의사결정, 임상지침 준수에 관해 즉각적인 피드백을 제공할 수 있다(A-ID 470, 490). VPS는 자원 집약적인 표준화환자에 대한 의존을 줄이면서 전통적인 객관구조화진료시험(objective structured clinical examinations, OSCEs)의 대안으로 학생의 병력청취 수행을 평가하는 데도 사용되었다(A-ID 217).


예측분석(Predictive analytics).


  • 전통적으로 의학교육은 과거 및 실시간 데이터를 분석하여 미래 수행 결과를 예측하기 위해 ML 모형과 알고리듬을 사용해 왔다. 최근 한 연구는 예측분석을 넘어 처방분석(prescriptive analytics)을 포함할 것을 권고하였다. 처방분석은 LLM을 활용해 복잡한 분석 산출물을 해석 가능하고 실행 가능한 다음 단계로 변환하여 학습자에게 직접 전달함으로써, 학습자와 의사결정자에게 실행 가능하고 근거에 기반한 조언을 제공할 수 있다.17 한 연구에서 NLP 모형은 대량의 서술형 피드백을 신속하게 피드백 요약으로 정리하였다. 학습자들은 이 요약을 활용하여 자신의 강점을 살리고 성장 영역을 확인하는 개별화 학습계획(individualized learning plans)을 수립하였고, 이는 현재의 학습분석(learning analytics) 접근을 보강하였다(A-ID 25). LLM과 고급 ML 같은 새로운 AI 도구를 활용함에 따라 예측분석은 계속 향상될 것이며, 개인맞춤형 교육을 실제로 구현하고 위험 학습자를 조기에 식별하여 개입하는 데 중요해질 것이다.


전문의시험형 문항(Board-style exam questions).


  • 여러 국가와 전문과목(산부인과, 내과, 이비인후과, 영상의학과, 마취통증의학과, 외과, 신경과, 피부과, 정형외과 포함)의 의사면허시험에서 ChatGPT 같은 생성형 AI 도구의 수행은 매우 다양하였다. 대부분의 AI 도구는 합격 기준을 넘었다고 보고되었으며, 합격률은 최저 22%(프랑스)에서 최고 89%(사우디아라비아)까지 분포하였다. 또 다른 연구에서 GPT-4는 정신의학에서 대다수 의사보다 높은 성과를 보였고, 일반외과와 내과에서는 중위 수준 의사와 유사하게 수행했으며, 이스라엘 전공의 전문의시험 5개 전문과목 중 4개에서 합격 점수를 달성하였다.18 생성형 AI 도구가 현재 지닌 역량과 정확도가 계속 향상됨을 고려하면, 이 도구들은 연습문항과 모의시험을 생성하고 학습자의 지식에 관해 즉각적인 피드백을 제공하여 실제 시험을 더 효과적으로 준비하도록 돕는 데 점점 더 많이 활용될 것이다.


프로그램 평가와 연구 (Program Evaluation and Research) 

CBME의 출현으로 학습자 수행자료의 양과 다양성이 증가하였다. 이러한 자료는 개별 학습자를 평가할 기회를 제공할 뿐 아니라, 학습자의 성장 궤적, 진로 결과, 학습환경의 다양성 및 포용성 지표처럼 프로그램과 교육과정의 영향을 파악하는 데 중요한 정보를 제공한다. 그러나 이러한 자료의 상당 부분은 서사 형식이며, 이 다중양식 자료(multimodal data)를 수작업으로 분석하려면 막대한 인적 자원이 필요하고 자원이 제한된 프로그램과 대학에 추가 부담을 초래하므로, 자료를 체계적으로 활용하기 어렵다. 이 영역에서의 적용은 제한적이지만, 저자들은 이러한 과제에 대응할 수 있는 새로운 AI 활용 사례를 강조한다.


텍스트 데이터 분석(Text data analysis).


  • AI를 사용하면 대규모 서사 데이터세트를 일관되게 질적으로 분석하여 경향을 정량적으로 파악할 수 있다. 예를 들어 NLP를 사용해 일반외과 전공의 수련프로그램 319개의 다양성 진술문(diversity statements)을 검토하고, 단어 수, 영향력 점수(clout scores, 전달되는 확신의 정도를 나타내는 척도), 긍정 어조 점수(positive tone scores)를 정량화함으로써 다양성·형평성·포용성(diversity, equity, and inclusion)에 대한 프로그램 차원의 헌신 수준을 측정하였다(A-ID 179). 또 다른 사례에서는 임상적 신뢰(clinical trust)를 판단할 때 학습자와 지도자가 중요하게 여기는 요인의 차이를 탐지하는 데 LLM을 사용하였다(A-ID 494).


예측 모델링(Predictive modeling).


  • 행정과 프로그램 평가를 위해 전통적 ML 모형이 예측 모델링과 알고리듬에 사용되었다. 여기에는 교수자의 학업 수행자료를 바탕으로 승진 승인 가능성을 예측하는 것(A-ID 501), 그리고 사회인구학적 자료와 학업 이력을 바탕으로 의과대학생의 학업 성공을 예측·모니터링하는 학습분석(A-ID 108, 501)이 포함되었다. 또한 예측 모델링은 학습자의 번아웃 위험을 평가하고, 역량바탕 평가체계와 규준바탕 평가체계(norm-based evaluative systems)에서 그 위험을 비교하는 데 사용되고 있다(A-ID 384).


현재 AI의 한계와 의학교육의 향후 과제 (Current AI Limitations and Next Steps for Medical Education) 

저자들이 문헌을 탐색한 결과, 의학교육에 AI를 통합하는 일은 기존 상태(status quo)를 변화시키기 시작했다. 그러나 효과성·안전성·형평성을 보장하는 실행 체계(implementation framework)를 개발하려면 AI의 한계와 위험을 반드시 고려해야 한다. 한계는 크게 기술 자체에 내재한 것과 적용 과정의 인적 요인에 관련된 것으로 구분할 수 있다.

기술적 한계: 정확도와 편향 (Technological Limitations: Accuracy and Bias) 

AI와 관련한 가장 두드러진 우려 중 하나는 특히 LLM에서 나타나는 투명성과 설명가능성의 문제이다. AI 산출물의 배후에 있는 의사결정 과정은 흔히 불투명하여 제공된 정보의 정확성과 신뢰성을 검증하기 어렵다. 이 문제는 LLM의 “컨파뷸레이션(confabulation)” 위험, 즉 부정확하거나 조작된 정보가 확신에 찬 방식으로 제시될 수 있다는 점으로 인해 악화된다. 사용자의 선호를 반영하거나 단순히 사용자가 기대하는 것을 제공하는 AI의 아첨 성향(sycophancy) 역시 산출물의 정확도와 질을 저해할 수 있다.19 또한 AI가 물려받은 편향은 과거 데이터에 존재하는 체계적 편향과 의료 격차를 나타내며, 건강 불평등(health inequities)을 악화할 가능성이 있다. 따라서 학습자가 AI 도구를 일차적인 지식 출처(first-line source of knowledge)로 사용하는 것은 바람직하지 않을 수 있으며, AI 생성 권고의 진실성과 적용가능성을 판단하는 능력이 새로운 역량으로 부상하고 있다.20


더욱이 입학·선발 및 평가 과정에서 AI 생성 내용이 지니는 윤리적 함의에 관한 우려가 있다. 인간이 만든 내용과 구별할 수 없는 에세이, 자기소개서, 피드백을 생성하는 AI의 역량은 진정성과 공정성에 관한 의문을 제기한다. AI 시스템의 학습 데이터세트에 내재한 편향은 기존 불평등을 전파하고 증폭할 수 있으며, 특히 입학·선발이나 역량평가와 같은 고부담 영역(high-stakes areas)에서 그러하다. AI가 생성한 산출물이 적절히 맥락화되고 의도하지 않은 편향에서 벗어나도록 보장하기 위해 지속적인 인간의 감독(continuous human oversight)이 필수적이다.


또한 환자 진료의 정서적·상호작용적 요소를 재현하는 것과 같은 특정 교육 과업에서 AI의 수행은 여전히 제한적이다. 전통적 표준화환자는 AI가 재현하지 못할 수 있는 인간 언어, 신체언어, 감정의 미묘한 차이에 반응한다(A-ID 74, 84, 373). 현재 이러한 단점은 실제 임상 만남을 시뮬레이션하는 AI의 효과성을 제한하지만, 기술 발전이 그 한계를 완화할 수 있다. AI 지원이 학습자의 지식과 술기 보유(retention)에 미치는 장기적 영향은 여전히 불분명하며, 여러 연구에서 AI 지원을 통해 향상된 수행이 AI 도구를 이용할 수 없는 환경으로 전이되지 않을 수 있음이 나타났다.

인간 및 실행 관련 한계: 과도한 의존과 탈숙련화 (Human and Implementation-Related Limitations: Over-Reliance and Deskilling) 

임상 의사결정을 안내하는 AI의 역량은 초보 학습자의 진단 수행을 측정 가능하게 향상할 수 있다. 그러나 모형을 비판적으로 평가하지 않은 채 AI 도구에 과도하게 의존하면 편향과 오류의 전파, 데이터 프라이버시 문제, 타당한 정보의 부족, 학습자 진전에 대한 교사의 관찰 감소, 사회적 상호작용 감소를 초래할 수 있다. 영상의학 분야의 논의에서 제안된 바와 같이, 당분간은 환자와 진료환경의 고유한 맥락 안에서 AI 생성 산출물을 해석하는 데 비판적 사고(critical thinking)와 기초 지식(foundational knowledge)이 계속 핵심 역할을 해야 한다.21 동료, 지도자, 학습자를 포함한 사회적 상호작용은 신뢰를 구축하고 학습자 만족도와 직무 만족도를 높이며, 술기 발달에 관한 피드백을 넘어 진로 멘토링 기회를 제공하는 데 중요하다.22,23

의학교육의 향후 과제 (Next Steps for Medical Education) 

여기에 기술한 문헌고찰과 이 연구 보고서 제2부에 기술한 면담 연구는 함께 의학교육에서 AI의 잠재적 이점, 활용 사례, 현재의 한계를 개관하고, 추가 탐색이 필요한 잠재적 영역을 알려준다. AI가 의료 실무와 의학교육을 점점 더 보강함에 따라, 학습자와 현업 임상의가 갖추어야 할 기초 지식과 능력은 AI 리터러시(AI literacy), AI 주도 산출물에 대한 비판적 평가(critical appraisal), 효과적인 인간-AI 협업(effective human-AI collaboration)을 포함하도록 진화해야 한다. 학습자가 AI 도구를 환자 진료에 능숙하게 통합할 수 있도록 의학교육과정을 지속적으로 갱신하는 일이 필수적이 될 것이다. AI가 의학교육에 미치는 영향을 지속적으로 모니터링하는 것은 공백, 편향, 의도하지 않은 결과를 식별하고 교육, 환자 안전, 형평한 진료를 향상할 기회를 찾는 데 매우 중요할 것이다.

NPJ Digit Med. 2026 May 16;9(1):595. doi: 10.1038/s41746-026-02768-2.

AI-PACE: a framework for integrating AI into medical education 


왜 지금 이 이야기인가

요즘 AI 관련 교육과정 이야기를 안 하는 의과대학이 없죠. 그런데 막상 들여다보면 대부분 한 학기짜리 선택과목이거나 며칠짜리 특강입니다. 이 논문은 바로 그 지점을 문제 삼습니다.


저자들이 짚는 배경이 인상적이에요. 환자들이 이미 의료계보다 앞서 가고 있다는 겁니다. 2026년 1월 기준으로 주당 2억 3천만 명이 ChatGPT에 건강 관련 질문을 하고 있고, 진료 중에 환자가 AI 음성 비서를 켜서 의사의 권고를 실시간으로 해석시키는 상황도 가능해졌습니다. 저자들은 이걸 이렇게 표현합니다.

우리는 임상의가 반드시 헤쳐 나갈 준비를 해야 하는 '그림자' 보건의료 시스템(shadow health system)을 마주하고 있다. "a 'shadow' health system that clinicians must be prepared to navigate"


공식 교육이 준비를 시켜줬든 아니든 상관없이 이미 벌어지고 있는 일이라는 거죠. 그런데 미국 의사의 44%는 새로운 기술에 대해 준비가 부족하다고 답합니다.

어떻게 만든 프레임워크인가

방법론은 통합적 문헌고찰(integrative review)입니다. Whittemore와 Knafl(2005)의 방법을 따랐는데, 경험연구와 개념연구를 함께 종합해서 새로운 이론적 틀을 만드는 데 적합한 방법이라 선택했다고 밝히고 있어요.

  • 검색: PubMed, MEDLINE, ERIC (2016~2025년), 초기 643편
  • 포함기준 6가지 적용 후 최종 23편
  • 블룸 분류체계(Bloom's Taxonomy)의 세 영역으로 역량을 조직화
  • 교육과정 개발 단계는 Harden(1986)과 Thomas 등(2022)의 틀에 매핑

한 가지 눈여겨볼 점은 논문 선정을 저자 한 명(S.P.M.)이 단독으로 했다는 것입니다. 저자들도 이걸 제한점으로 명시해요. 체계적 문헌고찰이 아니라 프레임워크 개발이 목적이었다는 설명입니다.

🔍 기존 프레임워크의 세 가지 구조적 공백

1. 단발성 개입과 지식 감퇴 


  • 지금의 AI 교육은 대체로 부트캠프(bootcamp)나 선택 워크숍 형태입니다. 예를 들어 van Kooten 등(2024)의 3일짜리 영상의학과 전공의 AI 교육과정은 단기적으로 자신감과 자가보고 지식을 유의하게 향상시켰습니다. 그런데 이런 집중형 모듈은 강화(reinforcement) 없이는 지식 감퇴(knowledge decay) 위험이 크고, 무엇보다 실제 의사결정이 일어나는 일상 임상 워크플로우 안으로 AI 리터러시를 통합시키지 못합니다.
  • Levingston 등(2024)의 의예과 1학년 AI 리터러시 과정, Hopson 등(2025)의 4주 사전-사후 설계 연구처럼 측정 가능한 성과를 보인 사례들도 나오고 있지만, 둘 다 단일기관이고 종단적 추적이 없다는 한계가 있습니다.


2. 술기 중심 전문과목 편중과 '일반의 공백' 


  • 기존 프레임워크는 영상 중심 전문과목(image-centric specialties)에 심하게 치우쳐 있습니다. 안과, 영상의학과 위주죠. 저자들이 말하는 '일반의 공백(Generalist Gap)'은 이렇습니다.


AI 기반 의사결정지원에 점점 더 의존하게 될 비술기 계열 또는 일차의료 의사들을 위한 포괄적 모델에 대한 합의가 없다는 점. "a lack of consensus on a comprehensive model for non-procedural or primary care physicians"


  • 전문과목별 모델은 특정 영역 안에서의 깊이를 다루지만, AI-PACE는 전이 가능성(transferability) 문제를 겨냥합니다. 여러 진료과에 걸쳐 AI 의사결정지원을 평가할 수 있는 일반의를 길러내겠다는 것이죠.


3. 정의적 영역의 부재, '인간적 공백' 


  • Singla 등(2024)의 델파이 연구는 무엇을 가르칠지에 대해 강한 합의를 만들어냈지만, 초점은 주로 지식과 술기였습니다. 남는 것이 정의적 영역(Affective Domain)입니다. 신뢰의 보정(calibration of trust), 자동화 편향(automation bias)의 인식, 그리고 AI가 매개하는 진료 상황에서 공감의 보존. 이 세 가지가 계속 빠져 있다는 겁니다.


🏛️ AI-PACE의 네 기둥

이름 그대로 Psychomotor, Affective, Cognitive, Embedded입니다. 앞의 세 개는 블룸 분류체계의 영역이고, 네 번째 Embedded는 종단적 통합을 보장하기 위해 저자들이 추가한 구조적 차원이에요.

인지적 영역(Cognitive): 알아야 할 것 

  • AI 기초: 개념과 용어, 머신러닝(ML)과 딥러닝의 구분, 특히 ML 모델이 경직된 규칙이 아니라 패턴에 기반한 확률적 예측을 생성한다는 이해
  • 보건데이터과학: 생물통계, 빅데이터 원리, 데이터 거버넌스
  • 강점과 한계: 오류의 원천, 임상적 관련성
  • 윤리적·법적 고려: 환자 프라이버시, 알고리즘 편향, 규제 체계

여기서 저자들이 흥미로운 지적을 합니다. 회의론도 업데이트가 필요하다는 거예요. 2022년경의 '확률적 앵무새(stochastic parrots)' 비판은 현재 모델의 능력을 더 이상 반영하지 못한다고 봅니다. 추론과 에이전트 기능이 상당히 발전했으니까요.

교육과정은 회의론을 실제 기술적 한계에 근거해야 한다.
"Curricula should ground skepticism in actual technical limitations."


막연한 불신도, 막연한 낙관도 교육 내용이 될 수 없다는 이야기로 읽힙니다.

심동적 영역(Psychomotor): 할 수 있어야 할 것 

  • 운영 기술: 임상 워크플로우에서 AI 도구 다루기, 데이터 입력, 결과 검색
  • 비판적 평가(critical appraisal): 알고리즘의 임상적 타당도와 편향 평가. 민감도, 특이도, AUC 같은 지표를 직접 계산하지는 못해도 해석은 할 수 있어야 함
  • 데이터 분석: AI 출력을 임상 의사결정에 통합
  • 의사소통: AI가 낸 권고를 환자가 이해할 수 있는 언어로 설명

정의적 영역(Affective): 신뢰의 보정 


  • 저자들은 '신뢰(trust)'라는 말로 프레이밍하는 것 자체가 임상 훈련이 실제로 요구하는 바를 과소평가한다고 말합니다.


임상의는 후배 동료의 작업을 평가하듯 AI 출력을 평가하는 법을 배워야 한다.
"Clinicians must learn to assess AI outputs as they would a junior colleague's work."


  • 즉 AI 역량은 신뢰하느냐 마느냐의 이분법적 결정이 아니라, 이 도구가 어디서 실패하는지의 경계를 아는 문제라는 겁니다. 예컨대 LLM은 요약은 잘하지만 환자 서사에서 질적 의미를 추출하는 데는 취약하죠.
  • 여기에 신뢰의 이중성(duality)이 있습니다.


  1. 임상의는 AI 출력의 신뢰성을 평가해야 한다 (AI에 대한 신뢰) 
  2. 동시에 교육자는 그 학습자가 그런 평가를 신뢰성 있게 해낼 만한 임상적 판단력을 갖췄는지 평가해야 한다 (학습자 역량에 대한 신뢰)


  • Gin 등(2025)이 제안한 대로 위임가능 전문직무(EPA) 틀을 AI 자체에 적용해서, 학습자를 평가하듯 AI를 능력(ability), 진실성(integrity), 선의(benevolence) 축으로 평가하자는 접근이 이 양면을 함께 다루는 방법으로 소개됩니다.
  • 이 영역의 세부 역량은 자동화 편향과 알고리즘 혐오(algorithm aversion) 사이의 균형, 환자 중심 가치, 데이터 과학자와의 협업, 지속적 학습입니다.


임베디드(Embedded): 종단적 통합 


  • 네 번째 기둥이 이 프레임워크의 차별점입니다. Harden의 통합 사다리(integration ladder) 상위 단계에 해당하는 접근이에요.


AI를 고립된 선택과목이나 독립적인 'AI 주간'으로 다루는 대신
"Rather than treating AI as an isolated elective or a standalone 'AI week'"


  • 기존 임상실습 전후 교육과정의 직물 안으로 AI 리터러시를 짜 넣자는 것입니다. 구체적으로는 이렇게 배치됩니다.


단계 초점 통합 지점
UME(임상실습 전) 기초 개념, 기본적 윤리 인식 역학, 생물통계, 보건의료시스템과학
UME(임상실습) 지표 해석, 규제 환경, 환자 설명 내과·영상의학과 등 임상실습
GME(전공의) 전문과목별 응용, 인간 개입 검증(human-in-the-loop) 모닝리포트, 그랜드라운드, QI 프로젝트
CME(진료 현장) AI 도구 선정과 실행, 리더십, 감독 표적 워크숍, 적시학습


  • 여기서 저자들이 놓치지 않는 문제가 교수 개발(faculty development)입니다. AI 리터러시에 관심 있는 신진 교수일수록 학생이 자기를 앞지를 수 있는 수업에 들어가기를 주저한다는 지적이에요. 새 도구를 통합하기에 가장 좋은 위치에 있는 교수가 동시에 학생과 함께 배우는 모습이 어떻게 비칠지 가장 신경 쓰는 사람이라는 것이죠.


신진 교수를 위한 병행 역량 강화 경로가 필수적이다.
"parallel upskilling pathways for junior faculty are essential"


  • 이게 없으면 교육과정이 가르치려는 비판적 평가와 위임 행동을 교수가 모델링할 수 없다고 못박습니다.


⚖️ 통합이냐 추가냐

가장 현실적인 장벽은 '포화된 교육과정(crowded curriculum)'이죠. 저자들의 답은 명확합니다. 새 과목을 만들지 말고 기존 과목 안에 넣으라는 것입니다.

  • 결정론적 알고리즘과 확률적 머신러닝의 인지적 구분은 임상실습 전 근거중심의학(EBM) 시간에 함께
  • 인간 개입 검증이라는 심동적 술기는 기존 임상실습 중에 연습
  • 정의적 역량은 이미 존재하는 기록과 감독 구조 안에서

이 통합 모델은 EBM 자체가 한때는 새로운 추가물이었던 과정을 그대로 닮았다.
"This integration model mirrors how EBM itself was once a novel addition"


지금은 임상추론의 일부가 되어버린 EBM처럼 AI 리터러시도 같은 경로를 갈 수 있다는 비유입니다. 실제 사례로 UC Davis 의대가 I-Explore 교육과정 개편에서 보건의료시스템과학(Health System Science)을 독립 학점이 아니라 기존 과목에 접어 넣는 방식으로 종단적 축을 만든 경험을 듭니다.


실행은 Harden과 Thomas의 모델을 바탕으로 한 6단계 순환으로 제시됩니다. 목적과 요구 정의 → 학습목표 수립 → 내용 설계 → 내용 계열화 → 교수전략 실행 → 평가와 개선. 여기서 6단계 평가는 종결점이 아니라 연속적이어야 한다고 강조합니다. 기술이 그만큼 빨리 바뀌니까요.

💰 자원 문제: 세 가지 투자

  1. 교수 개발: 구조화된 역량 강화 경로, 임상정보학 전문가 영입, 공대 교육과정과의 파트너십
  2. 학제간 인프라: 컴퓨터과학, 정보학, 의학 사이의 사일로 허물기
  3. 기술 접근권: 이건 정말 실무적인 지적인데, 학생은 임상 직원이 쓰는 AI 도구에 대한 동등한 라이선스 접근권이 없는 경우가 많습니다. 라이선스 비용과 IT 컴플라이언스 지원이 보통 피교육자가 아니라 직원 기준으로 편성되기 때문이죠. 의대 행정과 병원 IT 거버넌스 사이의 선제적 조율이 필요하다고 말합니다.

📊 평가와 검증, 그리고 인증


  • 저자들은 자가보고 자신감(Kirkpatrick 1수준)을 넘어서야 한다고 봅니다. 행동 변화(3수준)와 환자 결과(4수준)를 측정해야 한다는 거죠. "AI 리터러시를 갖춘 전공의는 진단지원도구를 쓸 때 더 안전한 결정을 내리는가?" 같은 질문에 답하려면 다기관 데이터가 필요하고, 그러려면 교육 모델의 표준화가 선행되어야 한다는 논리입니다.
  • 효율을 위해 GenAI에 의존하는 것이 술기 형성의 비용을 치를 수 있다는 증거도 언급됩니다. 탈숙련(deskilling), 오숙련(mis-skilling), 미숙련(never-skilling) 개념이 함께 등장해요. 인지적 과업을 AI에 넘길수록 커지는 문제입니다.
  • 현재 저자들은 UC Davis에서 4주 선택과목으로 AI-PACE를 파일럿 중이고, MAIRS-MS(Medical Artificial Intelligence Readiness Scale for Medical Students)로 사전-사후 준비도를 측정하고 있다고 합니다.
  • 인증(accreditation) 측면도 짚어둘 만합니다. LCME도 ACGME도 아직 AI 관련 구속력 있는 기준은 없습니다. 다만 2025년 Josiah Macy Jr. Foundation 학술대회(AAMC, ACGME 공동주최)가 AI 교육과정과 역량의 도입, 그리고 AI를 반영한 인증 절차 수정을 명시적으로 권고했습니다. AI-PACE는 규범적 요건이 나오기를 기다리지 말고 미리 대비하라는 포지셔닝입니다.


🚧 한계

저자들이 스스로 밝힌 제한점이 셋입니다.

  1. 단일 검토자 선별에 따른 선택 편향 가능성
  2. 미국 프로그램으로 한정한 탓에 국제적 일반화 가능성 제약. 국제적 적용에는 델파이 같은 합의 방법론이 필요할 것이라고 봄
  3. 최신 모델 성능을 기술할 때 동료심사 문헌과 함께 프론티어 AI 기업의 시스템 카드, 모델 카드를 인용. 9~12개월의 동료심사 주기 때문에 경험적 평가가 항상 한두 세대 뒤처진 모델을 다룬다는 구조적 한계 때문

🇰🇷 우리 맥락에서 생각해볼 지점

읽으면서 몇 가지가 걸렸습니다.


  • 첫째, 우리도 'AI 주간'이나 특강 형태가 대부분이라는 점. Embedded 기둥의 문제 제기는 그대로 적용됩니다. 통합 사다리 위쪽으로 올라가려면 결국 기존 과목 담당 교수가 자기 시간 안에서 AI를 다뤄야 하는데, 그 준비가 되어 있는지는 별개의 문제죠.
  • 둘째, 정의적 영역입니다. 신뢰 보정과 자동화 편향은 사실 전문직 정체성 형성(PIF)이나 프로페셔널리즘 교육과 맞닿아 있습니다. AI 역량을 기술 교육으로만 다루면 이 부분이 통째로 빠집니다.
  • 셋째, 학생의 도구 접근권 문제는 국내에서도 똑같이 발생하는 실무 이슈입니다. 이건 교육과정 설계 이전에 행정과 IT 거버넌스의 문제예요.
  • 넷째, 이 프레임워크가 미국 UME-GME-CME 구조에 맞춰져 있다는 점은 그대로 가져다 쓰기 어려운 이유이기도 합니다. 저자들도 국제적 적용에는 별도의 합의 과정이 필요하다고 인정하고 있고요.


마무리

논문의 마지막 경고 문장이 오래 남습니다.

의사들이 AI 출력의 수동적 소비자가 될 위험이 있다.
"physicians risk becoming passive consumers of AI outputs"


준비 없이는 평가하고 적용하는 전문직이 아니라 받아 쓰는 소비자가 된다는 것이죠. AI-PACE가 완결된 답이라기보다, 무엇을 가르칠 것인가에서 어떻게 배치할 것인가로 논의를 옮긴 출발점으로 읽으면 좋을 것 같습니다.


의료에서 인공지능(artificial intelligence, AI)의 역할은 빠르게 변화하고 있다. 과거에는 간헐적으로 도움을 주는 보조자에 가까웠지만, 이제는 진단영상부터 행정 업무흐름(administrative workflow)의 최적화에 이르기까지 능동적인 임상 참여자(active clinical participant)가 되었다. 생성형 인공지능(generative AI, GenAI)이 소비자에게 확산된 놀라운 속도는 이러한 교육의 시급성을 더욱 높인다. 2022년 11월 출시된 ChatGPT는 TikTok과 Instagram 같은 종전의 기록 보유 서비스를 제치고 가장 빠르게 성장한 사용자 기반이라는 기록을 세웠다.1 GenAI와 관련하여 환자들은 임상의가 움직이기를 기다리지 않고, 보건의료 조직의 도입보다 앞서 나가고 있다.2,3 이들은 이미 OpenAI, Google 및 Anthropic의 최신 모델에 자신의 의학적 상태를 질문하고 있다.


OpenAI는 2026년 1월 기준으로 매주 2억 3천만 명의 고객이 ChatGPT에 건강과 웰니스(health and wellness)에 관한 질문을 한다고 밝혔다.4 OpenAI와 Anthropic은 이러한 시장 수요에 대응하여 각각 건강에 초점을 둔 제품인 Claude for Healthcare5와 ChatGPT Health6를 출시했다. 이제 의사는 진료 도중 환자가 AI 음성 비서를 작동시켜 의사의 권고를 실시간으로 해석하게 하는 상황을 마주할 수 있다. 따라서 공식적인 훈련이 임상의에게 준비를 제공했는지와 무관하게, 우리는 임상의가 헤쳐 나갈 준비를 해야 하는 ‘그림자 보건의료체계(shadow health system)’에 직면하고 있다.


그러나 현재의 교육 모형은 정보화 시대가 요구하는 지식 큐레이션(knowledge curation)과, 깊이 있는 생의학적 역량(deep biomedical competence)에 대한 의료전문직의 지속적인 필요 사이의 간극을 메우지 못하고 있다.7,8 의사의 44%가 새로운 기술에 충분히 준비되어 있지 않다고 느낀다고 보고하지만,9 교육기관은 선택과목과 단기 시범사업을 넘어서는 데 어려움을 겪어 왔다. 기존의 시도는 대체로 파편화된 전문과목별 시범사업으로서 단기적인 향상을 보여주지만, 지식의 소실(knowledge decay) 위험이 있다. 종단적 강화(longitudinal reinforcement)가 없으면,10 역량 프레임워크는 무엇을 가르쳐야 하는지는 제시하지만 훈련 과정 전반에 걸쳐 기술이 어떻게 발달해야 하는지는 설명하지 못하며,11 대부분의 훈련 접근은 여전히 영상의학이나 안과학 같은 술기·절차 중심 전문과목에 기반을 두고 있다.12 그 결과, AI 도구를 평가하고 검증하고 감독할 기초 소양(foundational literacy)을 갖추지 못한 인력이 AI 도구와 협력해야 하는 상황이 되었다.


이로 인해 ‘일반진료의의 공백(Generalist Gap)’, 즉 앞으로 AI 기반 의사결정지원(AI-driven decision support)에 점점 더 의존하게 될 비술기·비절차 분야 또는 일차의료 의사를 위한 포괄적 모형에 합의가 부재한 상황이 발생한다. 이 논문은 바로 이 구조적 공백을 다룬다. 우리는 AI를 왜 가르쳐야 하는가라는 질문에서 한 걸음 더 나아가, 어떻게 가르칠 것인가라는 실천적 과제에 초점을 맞춘다. 이를 위해 먼저 문헌에서 흔히 혼용되는 몇 가지 용어를 명확히 구분한다.


  • 인공지능(AI)은 일반적으로 인간의 인지가 필요한 과업을 수행하도록 설계된 계산 시스템을 말한다.
  • 머신러닝(machine learning, ML)은 명시적으로 프로그래밍된 규칙을 따르는 대신 데이터에서 패턴을 학습하는 AI의 하위 분야이다.
  • 생성형 인공지능(GenAI)은 대규모 언어모델(large language model, LLM)을 포함하여 새로운 텍스트, 이미지 또는 기타 산출물을 생성할 수 있는 ML 모델의 한 부류를 뜻한다.
  • 대규모 언어모델(LLM)은 방대한 텍스트 말뭉치(text corpus)로 훈련되어 자연어를 생성하고 해석하는 특정한 GenAI 아키텍처이다.


이러한 구분은 교육과정 설계에서 중요하다. 진단영상 알고리즘을 사용하는 데 필요한 역량은 LLM이 생성한 임상 요약을 평가하는 데 필요한 역량과 의미 있게 다르기 때문이다.


우리는 기존 모형을 비교하고 현재의 모범실천(best practices)을 종합하여 AI-PACE 프레임워크(Psychomotor, Affective, Cognitive, Embedded)를 제시한다. 이 모형은 종단적으로 운영되며, 의과대학 1학년 때 AI 리터러시(AI literacy)를 도입하여 실제 진료까지 이어 간다. 미국 의과대학의 79%가 조기 역량 형성을 위해 임상실습 전 단계(pre-clerkship phase)의 첫 두 달 이내에 신체진찰 교육을 시작한다는 점을 생각해 보라.13 동일한 논리가 여기에 적용된다. AI 개념에 대한 조기·반복 노출은 학습자가 훈련 단계가 높아짐에 따라 이러한 도구와 효과적으로 일하는 데 필요한 토대를 형성한다. 이러한 준비가 없다면 의사는 AI 산출물을 적절히 평가하고 적용할 수 있는 전문가가 아니라, AI 산출물을 수동적으로 소비하는 사람이 될 위험이 있다.

본문 (Main text)

의학교육에서 AI를 다루는 포괄적 프레임워크를 개발하기 위해 우리는 통합적 문헌고찰을 수행하였다. Whittemore와 Knafl14이 정의한 통합적 문헌고찰은 새로운 이론적 프레임워크를 구축하기 위해 실증적 연구와 개념적 연구를 포함한 다양한 방법론적 접근을 종합하도록 특별히 설계된 방법이다. 이 방법론을 선택한 이유는 우리의 일차 목적이 기존 교육과정의 효과를 평가하는 것이 아니라, 기존 AI 역량 프레임워크를 지도화(mapping)하고 새로운 모형이 다룰 수 있는 구조적 공백을 확인하는 데 있었기 때문이다.

검색 전략 (Search strategy)

우리는 다음 검색식을 사용하여 PubMed, MEDLINE 및 ERIC을 검색하였다.


  • ("artificial intelligence," "machine learning," "AI," "data science," "deep learning"), medical education terms ("medical education," "medical student*," "residency," "physician education," "continuing medical education"), and curriculum/competency terms ("curriculum," "curricula," "competenc*," "training program," "educational program")


AI의 보건의료 적용과 이에 대응하는 교육적 반응이 빠르게 진화해 온 양상을 포착하기 위해 검색 대상은 2016년부터 2025년까지 출판된 문헌으로 제한하였다. 또한 초기 검색에서 누락되었을 가능성이 있는 논문을 확인하기 위해 Asta15에도 질의하였다.

데이터베이스는 임상 교수학습(clinical pedagogy)과 보건의료전문직 교육(health professions education) 문헌을 우선하도록 선정하였다. 연구의 초점이 기술적 AI 개발이 아니라 임상 및 교육 현장에서의 실행에 있었으므로 Scopus, Web of Science 및 IEEE Xplore는 포함하지 않았다.

연구 선정 (Study selection)

초기 검색에서는 643개의 문헌이 확인되었다. 다음 여섯 가지 포함 기준을 적용하였다. (1) AI 교육과정 또는 역량 프레임워크를 다룰 것, (2) 의학교육 환경을 대상으로 할 것, (3) 2016년부터 2025년 사이에 출판되었을 것, (4) 영어로 작성되었을 것, (5) 동료심사를 거쳤을 것, (6) 미국 의학교육 프로그램을 다룰 것. 미국 프로그램에 초점을 맞춘 결정은 실용적인 이유에서 이루어졌다. AI-PACE는 미국 의과대학생을 위한 시범 교과목을 구축하려는 명시적 목적에서 개발되었고, 역량을 미국 훈련체계의 구조적 단계인 학부의학교육(undergraduate medical education, UME), 졸업후의학교육(graduate medical education, GME), 평생의학교육(continuing medical education, CME)에 대응시키는 작업이 그러한 적용에 필수적이었기 때문이다. 전문이 없는 학술대회 초록, 교육보다 환자 진료에 초점을 둔 연구, 교육적 요소가 없는 순수 기술적 AI 논문은 제외하였다. 논문 선별은 한 명의 검토자(S.P.M.)가 수행하였다. 이는 본 연구의 한계이며 한계 절에서 다룬다. 전문 검토 결과 23편이 모든 포함 기준을 충족하였다.

자료 분석 (Data analysis)

반복적으로 나타나는 역량과 교육과정 구조를 확인하기 위해 23편의 논문을 주제분석(thematic analysis)하였다. AI 역량, 교육과정 프레임워크, 교육적 접근 및 실행상의 과제에 걸쳐 나타나는 주제를 중심으로 문서를 분석하였다. 역량은 Charow et al.16에 따라 Bloom 분류학의 세 영역으로 조직하였다. 교육과정 개발 단계는 확립된 의학교육 프레임워크에 대응시켰다.17,18

표 1에 요약된 이 분석을 통해 기존 모형의 구체적 공백, 즉 훈련이 고립된 워크숍으로 파편화되어 있다는 점과 정의적 영역이 충분히 대표되지 않는다는 점이 드러났다. AI-PACE 프레임워크는 이러한 역량을 Bloom 분류학의 심동적(Psychomotor), 정의적(Affective), 인지적(Cognitive) 영역에 기반하여 조작화(operationalize)하는 동시에,19 종단적 제공을 보장하기 위한 구조적 축으로 ‘내재화(Embedded)’를 추가한다.

표 1. 기존 프레임워크의 비교 분석 (Comparative Analysis of Existing Frameworks) 

연구/프레임워크 대상 및 범위 방법론 종단적 통합 여부 다룬 영역 확인된 공백
Valikodath et al.12 안과학(UME부터 펠로우십까지) 관점 논문/태스크포스 권고 예(의과대학부터 펠로우십까지의 발달 과정 제안) 기초, 수술 시뮬레이션, 인간화(humanization) 전문과목 특이적이며 일반진료의를 위한 모형이 없음
van Kooten et al.10 영상의학과(레지던트 수련) 시범연구/실행 아니요(3일간의 ‘패스트트랙’ 집중과정) 기초, 알고리즘 구축, 집단 윤리(group ethics) 단기적이고 전문과목 특이적이며 종단적 강화가 없음
Singla et al.11 UME(일반 의과대학생) 델파이 연구(전문가 합의) 제안됨(기존 교육과정에 통합할 것을 권고) 이론, 윤리, 법, 적용, 의사소통 무엇을 가르칠지는 정의하지만 교육 연속체에서의 발달을 다루지 않음
Turner et al.25 호흡기 및 중환자의학(PCCM) 관점 논문/개념적 연구 부분적(‘확장 가능한 감독[Scalable Oversight]’을 언급) 윤리, 견고성(robustness), 인간-AI 협력 안전한 통합 원칙이며 교육과정 설계 프레임워크는 아님
Masters26 일반(행정가 및 교육자) 개념적 프레임워크 개념적(교육과정 지도화를 논의) AI 리터러시, 교육과정 설계 행정가 중심이며 학습자 대상 지침이 제한적임
AI-PACE 프레임워크 일반의학(UME, GME, CME) 통합적 문헌고찰 및 Bloom 분류학 예(전체 교육 연속체를 아우르는 나선형 교육과정) 심동적(업무흐름), 정의적(신뢰), 인지적(지식), 내재화(종단성) 공백에 대응: 일반진료의 대상, 교육 연속체 전체를 포괄하며 정의적 영역을 명시적으로 포함

AI 교육의 현황 (Current state of AI education) 

임상현장에서 AI 기술이 급증하고 있음에도, 우리의 분석은 이에 상응하는 의학교육 프레임워크의 진화가 상당히 뒤처져 있음을 보여준다. 최근의 시도들이 필요한 역량을 정의하기 시작했지만 이 분야는 여전히 파편화되어 있다. Tolentino20의 범위 문헌고찰(scoping review)은 의학에서 AI를 다루는 포괄적 교육과정 프레임워크를 설명한 논문을 단 두 편만 확인했으며, 그중 한 편은 안과학에 특화되어 있었다. Rincón21의 최근 범위 문헌고찰도 이러한 결과를 재확인하여, 표준화된 AI 교육과정 프레임워크의 부족과 실행에서 나타나는 뚜렷한 국가 간 격차를 보여주었다.

파편화된 실행과 지식의 소실 (Fragmented implementation and knowledge decay)


  • 현재의 AI 교육은 단기간의 집중적인 ‘부트캠프(bootcamp)’ 또는 선택형 워크숍에 흔히 의존한다. 예를 들어 van Kooten10은 영상의학과 전공의를 대상으로 한 3일간의 AI 교육과정이 단기적으로 자신감과 자기보고 지식을 성공적으로 향상시켰음을 입증하였다. 그러나 이렇게 교육 모듈을 단기간에 집중 제공하면 강화가 없을 경우 지식이 소실될 위험이 있다. 또한 의사결정이 실제로 이루어지는 일상적 임상 업무흐름에 AI 리터러시를 통합하지 못할 수 있다. 교육적 개입의 대다수는 통합된 프로그램이 아니라 고립된 교과목, 워크숍 또는 강의로 이루어져 있다.16,22
  • 최근의 개입들은 측정 가능한 향상을 입증하기 시작했다. Levingston et al.23은 기초 개념, 실제 도구 사용 및 윤리를 통합한 의과대학 1학년 대상 AI 리터러시 과정을 개발하였다. Hopson et al.24은 사전-사후 설계를 사용하여 구조화된 4주간의 의예과 AI 교육과정을 평가했고, AI 지식 점수가 유의하게 향상되었음을 확인하였다. 이러한 결과는 고무적이지만 두 개입 모두 단일 기관에서 이루어졌고 종단적 추적관찰이 없으므로, 통합적이며 교육 연속체 전체를 아우르는 접근이 필요함을 다시 한번 뒷받침한다.


전문과목 간 불균형과 일반진료의의 공백 (Specialty imbalance and the generalist gap)


  • 기존 프레임워크는 영상 중심 전문과목에 크게 편중되어 있다. AI 교육이 존재하는 경우에도 주로 이들 분야에 초점을 맞춘다.20 앞에서 안과학 분야의 시도를 논의하였고, 호흡기 및 중환자의학에서도 중요한 원칙들이 제시된 바 있다.25 전문과목 특이적 모형은 특정 영역 안에서의 깊이를 다룬다. AI-PACE는 전이 가능성의 공백(transferability gap)에 대응하도록 설계되었으며, 일반진료의가 단일 분야 안에서만이 아니라 여러 전문과목에 걸쳐 AI 기반 의사결정지원을 평가할 수 있도록 준비시킨다.


‘인간’의 공백: 정의적 역량 (The “human” gap: affective competencies)


  • 현재의 모형은 인간-AI 상호작용에서 인간적 요소를 충분히 다루지 않는 경향도 있다. 델파이 접근은 무엇을 가르쳐야 하는지에 관한 강력한 합의를 제공하여11 윤리, 이론 및 적용 역량을 타당화했지만, 해당 프레임워크는 주로 지식과 기술에 초점을 맞춘다. 여전히 충분히 다루어지지 않은 것은 정의적 영역(Affective Domain), 즉 신뢰의 보정(calibration of trust), 자동화 편향(automation bias)의 인식, AI가 매개하는 환자 진료에서 공감의 보존이다. Rincón은 AI를 독립된 교과목이 아니라 실용적 도구로 통합할 수 있도록 윤리적 인식과 같은 횡단적 기술(transversal skills)을 강화해야 한다는 새로운 교육적 요구를 강조하였다.21


AI-PACE 프레임워크 (The AI-PACE framework) 

우리의 결과를 종합하고 현행 의학교육의 구조적 공백에 대응하기 위해 AI-PACE 프레임워크를 개발하였다. 이 모형은 내용을 Bloom 분류학의 확립된 영역인 심동적·정의적·인지적 영역에 기반한 네 개의 축으로 조직하며, 의학 훈련 연속체 전반의 종단적 통합을 보장하기 위해 네 번째 구조적 차원인 내재화(Embedded)를 도입한다(그림 1).

먼저 Bloom 분류학과의 대응을 살펴본 다음, 내재화 접근으로 넘어간다.

그림 1. 의료 AI 역량을 위한 AI-PACE 분류학적 프레임워크 (The AI-PACE Taxonomic Framework for Medical AI Competencies) 

AI 역량을 위한 Bloom 분류학의 영역(Bloom’s Taxonomy Domains for AI Competencies)

인지적 영역(Cognitive Domain): 습득할 지식 심동적 영역(Psychomotor Domain): 개발할 기술 정의적 영역(Affective Domain): 개발할 태도
AI의 기초(Fundamentals of AI)
• 기본 AI 개념과 용어
• 머신러닝과 딥러닝
• 데이터 획득과 알고리즘 훈련
비판적 평가(Critical Appraisal)
• AI 알고리즘 평가
• 임상적 타당성 평가
• AI 시스템의 편향 식별
적절한 신뢰(Appropriate Trust)
• AI 역량에 대한 균형 잡힌 관점
• 과도한 의존 또는 회의주의 피하기
• 적절한 경계 유지
보건 데이터과학(Health Data Science)
• 생물통계학과 빅데이터 원리
• 데이터의 질과 거버넌스
• 보건의료 맥락에서의 데이터 분석
자료 분석(Data Analysis)
• AI 산출물 해석
• 결과를 임상 맥락과 통합
• 데이터 패턴 인식
지속적 학습(Continuous Learning)
• 계속교육에 대한 헌신
• 진화하는 기술에 대한 적응성
• 새로운 AI 발전에 대한 관심
강점과 한계(Strengths and Limitations)
• AI의 능력과 제약
• 오류와 편향의 원천
• 임상적 관련성과 한계
운용 기술(Operational Skills)
• AI 도구 탐색과 사용
• 효과적인 데이터 입력
• 임상 업무흐름에 AI 통합
환자중심 가치(Patient-Centered Values)
• 인간적인 진료 유지
• AI 사용 시 공감과 연민 유지
• 기술보다 환자의 필요를 우선
윤리적·법적 고려(Ethical and Legal Considerations)
• 환자 개인정보 보호와 데이터 보안
• 규제 프레임워크
• 법적 책임과 지식재산권
의사소통(Communication)
• AI 기반 권고 설명
• 기술적 개념의 번역
• 환자와 AI의 한계 논의
학제 간 협력(Interdisciplinary Collaboration)
• 팀 접근의 가치 인정
• 데이터과학자의 전문성 존중
• 분야를 넘나들며 협력하려는 의지

이 프레임워크는 Bloom 분류학의 세 영역, 즉 인지적 영역(지식), 심동적 영역(기술), 정의적 영역(태도)에 걸쳐 의료 AI 역량을 조직하고 각 영역에 구체적 역량을 대응시킨다. Charow et al.16, Grunhut et al.22, Masters26 및 Li et al.29을 바탕으로 수정하였다.

심동적 영역: 기술과 업무흐름 (Psychomotor domain: skills & workflow)

심동적 영역은 이론적 지식에서 임상적 유용성으로의 전환에 초점을 맞추며, 도구를 다루고 확률적 산출물을 해석하고 이러한 결과를 환자에게 설명하는 ‘직접 수행(hands-on)’ 능력을 강조한다.

  • 운용 기술(Operational Skills): 임상 업무흐름 안에서 AI 도구를 다루고, 데이터를 효과적으로 입력하며, 의미 있는 결과를 도출한다.20
  • 비판적 평가(Critical Appraisal): AI 알고리즘의 임상적 타당성, 편향 및 특정 환자집단에 대한 적용 가능성을 평가한다.16 여기에는 주요 성능 지표인 민감도(sensitivity), 특이도(specificity), 곡선하면적(area under the curve, AUC)을 반드시 직접 계산하지는 않더라도 해석하는 것이 포함된다.
  • 자료 분석(Data Analysis): AI 시스템의 산출물을 해석하고 임상적 의사결정에 통합한다.16
  • 의사소통(Communication): AI 기반 권고를 환자가 이해할 수 있는 용어로 설명하고 기술적 개념을 풀어서 전달한다.26

정의적 영역: 적절한 위탁과 신뢰 보정 (Affective domain: appropriate entrustment & trust calibration)

정의적 영역은 인간-AI 파트너십에 필요한 태도, 가치 및 감성지능(emotional intelligence)을 포괄한다. 이 영역은 분석에서 확인된 ‘인간의 공백’에 대응하는 핵심이다. 그러나 이를 단지 ‘신뢰’로 표현하면 실제 임상 훈련이 요구하는 바를 축소하게 된다. 임상의는 후배 동료의 업무를 평가하듯 AI 산출물을 평가하는 법을 배워야 한다. 이는 도구가 어디에서 실패할 수 있는지를 이해한다는 뜻이다. 예를 들어 LLM은 요약은 효과적으로 수행하지만 환자의 서사에서 질적 의미를 추출하는 데에는 어려움을 겪는다. 따라서 교육과정은 AI 역량을 신뢰 여부의 이분법적 결정으로 다루지 말고 이러한 경계를 명시적으로 다루어야 한다.


이 맥락에서 신뢰 보정(trust calibration)은 교육과정이 인정해야 할 이중성을 갖는다. 임상의는 AI 산출물의 신뢰할 만함을 평가하는 법, 즉 AI에 대한 신뢰(trust in the AI)를 배워야 한다. 동시에 교육자는 훈련생이 그러한 평가를 신뢰성 있게 수행할 만큼 충분한 임상 판단을 발달시켰는지, 즉 훈련생의 역량에 대한 신뢰(trust in a trainee’s competencies)를 평가해야 한다. Gin et al.은 AI 도구를 수탁자(trustee)로 간주하여 위탁가능 전문활동(Entrustable Professional Activity, EPA) 프레임워크를 적용할 것을 제안한다. 이는 훈련생을 평가하는 방식과 마찬가지로 AI의 능력(ability), 진실성(integrity), 선의(benevolence)를 평가함으로써 이 신뢰 관계의 양 측면을 조작화하는 구조화된 접근이다.27

  • 적절한 신뢰 보정(Appropriate Trust Calibration): ‘자동화 편향(automation bias)’인 과도한 의존과 ‘알고리즘 회피(algorithm aversion)’인 근거 없는 회의주의를 모두 피하기 위해 AI의 능력에 관한 균형 잡힌 관점을 개발한다.28
  • 환자중심 가치(Patient-Centered Values): 기술적 도구를 활용하면서도 인간적인 진료에 계속 초점을 맞춘다.29 AI는 공감과 연민을 대체하는 것이 아니라 증강해야 한다.
  • 협력(Collaboration): 데이터과학자 및 엔지니어와의 학제 간 팀워크를 가치 있게 여긴다.16
  • 지속적 학습(Continuous Learning): AI 기술이 진화함에 따라 계속 학습하려는 헌신을 촉진한다.30

인지적 영역: 지식 (Cognitive domain: knowledge)

인지적 영역은 AI를 도구로 이해하는 데 필요한 기초 지식 기반을 확립한다.

  • AI의 기초(Fundamentals of AI): 기본 개념과 용어인 머신러닝과 딥러닝을 이해하고, ML 모델이 고정된 규칙이 아니라 패턴에 기반하여 확률적 예측을 생성한다는 점을 안다.26,31 기초 훈련은 시대에 뒤처진 회의주의도 갱신해야 한다. AI를 확률적으로 단어를 반복하는 ‘확률적 앵무새(stochastic parrots)’로 보는 2022년 무렵의 비판은 더 이상 현재 모델의 능력을 반영하지 않는다.32–35 추론 및 에이전트 기능(agentic functions)은 크게 발전하였다. 교육과정은 실제 기술적 한계에 근거하여 회의적 태도를 형성해야 한다.
  • 보건 데이터과학(Health Data Science): 생물통계학, 빅데이터 원리 및 데이터 거버넌스를 이해한다.16
  • 강점과 한계(Strengths and Limitations): 오류의 원천과 임상적 관련성을 포함하여 AI 시스템의 능력과 제약을 인식한다.22
  • 윤리적·법적 고려(Ethical and Legal Considerations): 환자 개인정보 보호, 알고리즘 편향, 보건의료 AI를 규율하는 규제 프레임워크를 이해한다.26,36

내재화: 종단적 통합 (Embedded: longitudinal integration)

‘내재화(Embedded)’ 축은 AI 역량을 의학 훈련 연속체 전체에 분산하여 파편화된 부트캠프 모형의 구조적 한계에 대응하며, 이는 Harden의 ‘통합 사다리(integration ladder)’에서 높은 수준에 해당한다.37 이 접근은 AI를 고립된 선택과목이나 독립된 ‘AI 주간’으로 취급하지 않고, AI 리터러시를 임상실습 전 및 임상실습 교육의 기존 구조 안에 엮어 넣는다는 점에서 Han의 연구38와 일치한다. 이 종단적 모형은 훈련 초기에 기초적인 인지적·정의적 역량을 확립하고 이를 레지던트 수련과 독립 진료 단계의 전문화된 심동적 기술로 분화시킴으로써 ‘일반진료의의 공백’을 직접 연결한다.


실행은 교수자의 공백(faculty gap)도 다루어야 한다. 경력 초기 교수는 흔히 AI 리터러시에 큰 관심이 있지만, 학생이 자신보다 앞서 나갈 수 있는 수업에 들어가기를 주저할 수 있다. 이는 새로운 도구를 통합하기에 가장 적합한 교수자가 오히려 학생과 함께 학습하는 모습이 어떻게 비칠지를 가장 우려하는 사람일 수 있다는 단절을 만든다. 따라서 신진 교원을 위한 병행 역량향상 경로(parallel upskilling pathway)가 필수적이다. 이러한 경로가 없다면 교수자가 교육과정이 가르치려는 비판적 평가와 위탁의 행동을 모범으로 보여주기를 기대할 수 없다.

  • 학부의학교육(Undergraduate Medical Education, UME):
    • 기초 개념과 기본적인 윤리적 인식에 초점을 맞춘다.
    • AI 특이적 내용은 기존 모듈에 통합한다. 예를 들어 결정론적 알고리즘(deterministic algorithm)과 확률적 머신러닝의 인지적 차이를 근거기반의학(Evidence-Based Medicine, EBM) 및 생물통계학과 함께 가르친다.
  • 졸업후의학교육(Graduate Medical Education, GME):
    • 전문과목 특이적 적용과 업무흐름 통합으로 이동한다.
    • 전공의는 이론에서 임상적 유용성으로 나아가며, 내과 또는 영상의학과 임상실습 같은 전문과목 순환교육에서 직접 수행하는 사례기반학습을 통해 ‘인간 참여형(human-in-the-loop)’ 검증을 연습한다.
  • 평생의학교육(Continuing Medical Education, CME):
    • 실제 진료에 통합하는 전략, 새롭게 등장하는 기술 및 기관 리더십을 강조한다.
    • 표적화된 워크숍과 자기주도학습을 통해 현직 의사의 변화하는 요구에 대응하며, 실제 업무흐름 안에서 AI 도구를 선택·실행·감독하는 데 초점을 맞춘다.

이 접근을 조작화하기 위해 표 2는 AI-PACE 영역을 의학교육 연속체의 구체적 이정표 및 기존 교육과정 내 통합 지점과 정렬한 교육과정 지도를 제시한다. 이 지도는 학부 단계의 기초 이론에서 계속 진료 단계의 고급 임상 감독 및 리더십으로 이행한다.

이는 인지적·심동적·정의적 영역을 훈련의 구체적 이정표에 대응시킴으로써 AI-PACE의 내재화(종단적) 축을 구체적으로 보여준다.

표 2. AI-PACE 교육과정 지도 및 통합 전략 (AI-PACE Curriculum Map and Integration Strategy) 

훈련 단계 주된 초점 인지적 영역(지식) 심동적 영역(기술/업무흐름) 정의적 영역(태도/신뢰) 통합 지점 및 학습 접근
학부 기초 단계(UME–임상실습 전) 기초(Foundations) AI 용어와 개념, ML 대 결정론적 논리, AI의 확률적 속성 학습 보조를 위한 기본 프롬프트 엔지니어링, 문헌검색 수행 자동화 편향 인식, 데이터 개인정보 보호의 가치 인정, ‘블랙박스’에 대한 회의적 태도 역학, 생물통계학 및 보건의료체계과학(Health Systems Science)의 입문과정과 통합 모듈
학부 단계(UME–임상) 노출(Exposure) AI 지표(AUC, 민감도) 해석, 규제 환경(FDA), 데이터과학의 기초 회진 중 AI 도구의 비판적 평가, 감별진단을 위한 AI 사용, 환자에게 결과 설명 신뢰 보정, AI 매개 환자 진료에서의 공감 통합 모듈과 임상 노출을 통한 임상실습(예: 내과, 영상의학과)
졸업후 단계(GME–레지던트 수련) 적용(Application) 전문과목 특이적 AI 적용, 패혈증 예측기, 영상 분류 알고리즘 임상 통합과 의사결정, ‘인간 참여형’ 검증, 전자의무기록(EHR) 문서화, 오류 보고 전문직업적 책무성, 데이터과학 팀과의 협력 아침 집담회(Morning Report), 그랜드 라운드 및 질향상(QI) 프로젝트에서의 직접 적용과 사례기반학습
계속 단계(CME–진료) 숙달 및 리더십(Mastery & Leadership) 새롭게 등장하는 LLM 역량, 질 및 성능 평가, 법적 책임에 관한 최신 정보 업무흐름 최적화, AI 도구의 선정·실행, AI 실행 리더십 안전 문화 조성, 후배 직원에게 AI 감독을 멘토링 표적화된 워크숍, 적시훈련(just-in-time training), 기관 리더십 역할

통합적 교수학습 방법 (Integrated pedagogical methods)

  • 사례기반학습(Case-Based Learning): 전문과목별 ‘AI 실패(AI-Fail)’ 사례연구를 활용하여 신뢰 보정과 검증을 가르친다.
  • 시뮬레이션 객관구조화진료시험(Simulation Objective Structured Clinical Examinations, OSCEs): AI가 생성한 진단과 알고리즘의 한계를 표준화환자에게 설명하는 연습을 한다.
  • 질향상 프로젝트(Quality Improvement Projects): GME/CME 학습자가 실제 임상 업무흐름 안에서 AI 도구의 성능과 안전성을 평가하도록 장려한다.

실행 전략 (Implementation Strategy)

AI-PACE 프레임워크를 성공적으로 적용하려면 급격한 기술 변화의 속도를 따라갈 수 있는 구조화된 교육과정 개발 접근이 필요하다. Harden17과 Thomas18의 확립된 모형을 바탕으로, 임상 AI의 역동적 속성에 맞추어 특별히 수정한 6단계 순환을 제안한다(그림 2).

  1. 목적과 필요 정의(Define Purpose and Need): 현행 교육의 공백을 확인하고 미래 진료와의 관련성을 명시한다.
  2. 학습목표 수립(Establish Learning Objectives): AI-PACE에서 제시한 바와 같이 인지적·심동적·정의적 영역에 걸쳐 구체적인 성과를 정의한다.
  3. 교과 내용 설계(Design Course Content): 이론적 토대와 실제 적용의 균형을 맞추고 교육 단계(UME 대 GME)에 맞게 내용을 조정한다.
  4. 내용의 발달 순서 조직(Organize Content Progression): 기초 개념에서 고급 개념으로 발전하는 논리적 순서를 만들고 기존 교육과정 안에서 통합할 지점을 확인한다.
  5. 교수전략 실행(Implement Teaching Strategies): 적절한 방법(강의, 사례기반학습, 프로젝트)을 선정하고 교수자의 역량을 개발한다.
  6. 평가와 개선(Evaluate and Refine): 체계적인 피드백을 수집하고 성과를 측정한다. 결정적으로, 기술이 발전함에 따라 내용을 갱신할 수 있도록 이 단계는 지속적으로 이루어져야 한다.

그림 2. AI 교육과정 개발을 위한 6단계 실행 순환 (A Six-Step Implementation Cycle for AI Curriculum Development) 

AI 교육과정 실행 순환(AI Curriculum Implementation Cycle)

1.           목적과 필요 정의(Define Purpose and Need)

–             현행 교육의 공백 확인

–             실제 진료와의 관련성 명시

–             이해관계자의 필요 분석

–             기관의 사명과 정렬

2.           학습목표 수립(Establish Learning Objectives)

–             인지적 영역의 목표 정의

–             심동적 영역의 목표 정의

–             정의적 영역의 목표 정의

–             역량 프레임워크와 정렬

3.           교과 내용 설계(Design Course Content)

–             이론과 적용의 균형

–             기술적 기초 포함

–             윤리적 고려사항 다루기

–             교육 수준에 맞추어 조정

–             전문과목 특이적 내용 포함

4.           내용의 발달 순서 조직(Organize Content Progression)

–             논리적 순서 구성

–             통합 지점 확인

–             나선형 복잡성 증가 계획

–             종단적 주제 지도화

5.           교수전략 실행(Implement Teaching Strategies)

–             적절한 방법 선정

–             교수자 역량 개발

–             평가 접근 개발

–             학제 간 전문성 활용

–             학습환경 준비

6.           평가와 개선(Evaluate and Refine)

–             체계적 피드백 수집

–             여러 수준에서 성과 측정

–             기술 발전에 따라 내용 갱신

–             Kirkpatrick 평가 적용


각 단계는 목적 정의, 목표 수립, 내용의 설계 및 조직, 교수전략, 평가의 순서로 진행된다. 평가 단계는 종결 단계가 아니라 지속적 단계이며, 이는 AI의 능력과 임상 적용이 빠르게 발전하는 속도를 반영한다.

논의 (Discussion)

의료에서 AI가 빠르게 발전하는 속도는 포괄적 교육 프레임워크의 개발을 앞질렀으며, 이 기술을 임상현장에 안전하게 통합하는 일을 위협하는 ‘준비도 공백(preparedness gap)’을 만들었다. AI-PACE 프레임워크는 학습자와 함께 발전하는 나선형 교육과정(spiral curriculum) 모형을 통해 이러한 한계에 대응하도록 설계되었다.

‘통합 대 추가’ 논쟁 (The “integration vs. addition” debate) 

AI 교육의 주요 장벽은 ‘과밀한 교육과정(crowded curriculum)’ 문제이다. 의과대학과 레지던트 수련 일정은 이미 포화되어 있다.7 새로운 교과목을 만드는 대신 AI 개념을 기존 교과목에 통합하면 이 문제에 대응하는 데 도움이 될 수 있다.28

  • 예를 들어 결정론적 알고리즘과 확률적 머신러닝의 인지적 차이는 임상실습 전 단계의 EBM과 함께 가르쳐야 한다.
  • 마찬가지로 ‘인간 참여형’ 검증이라는 심동적 기술은 기존 임상실습에서 연습해야 하며, 기술을 일상적 임상 업무흐름과 분리하는 ‘파편화된 부트캠프’ 모형은 명시적으로 피해야 한다.
  • 이러한 통합 모형은 한때 새로운 추가 요소였지만 이제는 임상추론의 구조 안에 엮여 들어간 EBM의 발전과정을 그대로 반영한다.

캘리포니아대학교 데이비스 의과대학에서는 I-Explore 교육과정 개편을 통해 보건의료체계과학(Health System Science)을 독립된 학점으로 추가하지 않고 기존 교과목에 접어 넣는 방식으로 새로운 종단적 축을 도입하였다.39 AI 리터러시도 같은 경로를 따를 수 있다. 즉 인지적 토대는 생물통계학과 EBM 교과목에 내재화하고, 심동적 기술은 기존 임상실습에서 연습하며, 정의적 역량은 임상 훈련에 이미 존재하는 문서화 및 감독 구조를 통해 다룰 수 있다. GME 수준에서 Preiksaitis는 별도의 교육과정 시간을 요구하지 않고 구조화된 프롬프트를 활용하여 전공의의 AI 사용에 대한 감독을 기존 증례 발표와 임상 회진에 내재화할 수 있음을 보여준다.40

자원의 과제: 교수자와 재정 (The resource challenge: faculty and funding)

AI-PACE를 실행하려면 세 범주의 기관 투자가 필요하다.

  • 첫째는 교수개발이다. 많은 의학교육자가 AI와 데이터과학에 관한 전문성이 부족하며,28,41 이는 구조화된 역량향상 경로, 임상정보학자(clinician-informatician)의 채용, 공학교육과정과의 파트너십을 통해 해결할 수 있다.42
  • 둘째는 학제 간 인프라이다. AI의 역량이 빠르게 발전함에 따라 교육 내용을 최신 상태로 유지하려면 컴퓨터과학, 정보학 및 의학 사이의 칸막이를 허물어야 한다.16,26 기존에 보건정보학 대학원 프로그램을 운영하는 기관이라면 이러한 기반을 일부 갖추고 있을 수 있다.
  • 셋째는 기술 접근성이다. 라이선스 비용과 정보기술(IT) 규정준수 지원 예산은 일반적으로 훈련생이 아니라 직원을 대상으로 편성되므로, 학생은 임상 직원이 이용할 수 있는 AI 도구에 동일한 라이선스로 접근하지 못하는 경우가 많다. 이 격차를 해소하려면 의과대학 행정과 의료체계 IT 거버넌스 사이의 선제적인 조정이 필요하다.

타당화와 향후 방향 (Validation and future directions)

의학교육이 AI 교육과정을 도입함에 따라 그 영향을 엄격하게 타당화해야 한다. 향후 연구는 자기보고 자신감(Kirkpatrick 1수준)을 넘어 행동 변화(3수준)와 환자 결과(4수준)를 측정해야 한다.43,44 AI 리터러시를 갖춘 전공의는 진단지원 도구를 사용할 때 더 안전한 결정을 내리는가? AI-PACE를 통해 교육 모형을 표준화함으로써 이와 같은 질문에 답하는 데 필요한 다기관 자료를 생성하기 시작할 수 있다. 효율성을 위해 GenAI에 의존하면 기술 형성이 희생될 수 있다는 근거가 새롭게 등장하고 있다는 점에서도 이 연구는 시의적절하다.45 의사가 인지적 과업을 점점 더 AI 도구에 넘김에 따라 탈숙련(deskilling), 오숙련(mis-skilling), 미숙련(never-skilling)에 대한 우려가 커지고 있다는 점에서 특히 중요하다.46,47


프레임워크를 근거로 전환하기 위해 현재 캘리포니아대학교 데이비스에서 의과대학생을 위한 4주 선택과목을 통해 AI-PACE를 시범 운영하고 있다. 개입 전후의 AI 준비도는 이러한 목적을 위해 개발되고 타당화된 도구인 의과대학생용 의료 인공지능 준비도 척도(Medical Artificial Intelligence Readiness Scale for Medical Students, MAIRS-MS)를 사용하여 측정할 예정이다.48 이 시범 운영의 결과는 본 논문의 후속 사례연구로 발표할 계획이다. 미국의 맥락을 넘어 AI-PACE를 국제적으로 수정·적용하는 것은 중요한 다음 단계이다. 이를 위해서는 보건의료체계에 따라 훈련 구조와 인증 요건이 달라지는 점을 고려할 수 있도록 델파이 연구 같은 더 폭넓은 합의 방법론이 필요할 것이다.


의학교육합동위원회(Liaison Committee on Medical Education, LCME)와 졸업후의학교육인증위원회(Accreditation Council for Graduate Medical Education, ACGME)는 현재 구속력 있는 AI 특이적 기준을 마련하지 않았지만, 이 분야는 그 방향으로 나아가고 있다. AAMC와 ACGME가 공동 후원한 2025년 Josiah Macy Jr. Foundation 학술대회는 AI 교육과정과 역량을 실행하고, AI를 고려하도록 인증 절차를 수정할 것을 명시적으로 권고하였다.49 AI-PACE는 이러한 변화의 궤적에 맞도록 설계되었으며, 아직 존재하지 않는 규범적 요구사항을 기다리는 대신 기관이 새롭게 등장하는 인증 기대에 대응할 수 있는 구조화된 프레임워크를 제공한다.

한계 (Limitations)

이 연구에는 몇 가지 한계가 있다.

  • 첫째, 논문 선별을 한 명의 검토자(S.P.M.)가 수행했으므로 선택 편향(selection bias)의 가능성이 있다. 눈가림된 다수 검토자가 선별하는 정식 체계적 문헌고찰은 이 프레임워크 개발 연구의 범위를 벗어났다.
  • 둘째, 이 문헌고찰은 본 연구를 촉발한 즉각적이고 실용적인 필요, 즉 미국 의과대학생을 위한 시범 교과목 개발을 반영하여 의도적으로 미국 의학 훈련 프로그램에 한정하였다. 미국 중심의 초점은 훈련 구조, 인증 요건 및 교수학습 접근이 상당히 다를 수 있는 국제적 맥락에 AI-PACE를 일반화하는 데 한계가 된다. 이 프레임워크는 델파이 연구 같은 합의 방법론을 통해 국제적으로 수정·적용할 가능성이 있다.
  • 셋째, 이 원고는 현재 모델의 역량을 기술할 때 동료심사 문헌과 함께 최첨단 AI 연구소(frontier AI laboratory)의 공식 기술보고서 및 모델 카드(model card)를 인용한다. 이는 이 분야의 구조적 한계를 반영한다. 9–12개월이 걸리는 동료심사 출판 주기로 인해 LLM 성능의 실증적 평가는 흔히 현재 임상에서 사용되는 모델보다 한두 세대 뒤처진 모델을 평가하기 때문이다. 시스템 카드와 모델 카드는 동료심사를 거치지는 않았지만, 최근 출시된 모델의 역량 경계와 안전성 평가를 가장 시의성 있게 기록한 자료이다. 우리는 이를 방법론적 제약으로 인정하며 독자가 이러한 출처에 그에 맞는 비중을 두어 판단할 것을 권한다.

결론 (Conclusion) 

AI를 보건의료에 통합하려면 의학교육도 그에 맞게 변화해야 한다. 우리의 문헌 분석은 임상현장에서 AI가 빠르게 도입되는 속도와 의사가 이러한 기술을 효과적으로 사용할 준비 사이에 상당한 간극이 있음을 보여준다. 제한적인 수의 교육적 시도는 존재하지만, 포괄적 교육과정 프레임워크는 대체로 부재하거나 파편화되어 있다. 우리는 의료전문직의 AI 교육을 이끌어야 할 인지적·심동적·정의적 영역의 역량을 확인하였다. 효과적인 교육과정은 기술적 지식과 임상 적용 및 윤리적 고려의 균형을 맞추고, 의학 훈련 전반에 종단적으로 통합되며, 학제 간 협력을 포함해야 한다.


이 논문에서 제시한 AI-PACE 프레임워크는 AI 교육과정을 개발하려는 의학교육자에게 출발점을 제공한다. 향후 연구는 이러한 교육과정의 실행과 평가, 전문과목 특이적 교육 접근의 개발, AI 교육을 지원하는 교수개발 프로그램의 구축에 초점을 맞추어야 한다. AI가 보건의료를 계속 변화시키는 가운데, 인간적이고 환자중심적인 진료를 유지하면서 의사가 이러한 기술을 활용할 수 있도록 충분히 준비시키는 일은 의학교육이 직면한 가장 시급한 과제 중 하나이다.


Med Educ. 2026 Aug;60(8):865-872. doi: 10.1111/medu.70142. Epub 2025 Dec 23.

How can I help at this moment? Outlining three generations of coaching for health professions educators 


🤔 "코칭 하세요"라는 말이 왜 이렇게 애매할까

요즘 보건의료전문직교육(health professions education, HPE)에서 코칭(coaching)이라는 말을 정말 많이 씁니다. 학습도, 웰빙도, 수행능력도 코칭으로 좋아진다는 연구들이 계속 나오고 있죠. 그런데 막상 "우리 과에도 코칭을 도입합시다"라는 말이 나오면, 회의실에 있는 사람들이 서로 다른 그림을 떠올립니다. 누군가는 술기 피드백을 생각하고, 누군가는 진로 상담을, 또 누군가는 번아웃 예방 프로그램을 떠올려요.


Jensen, Price, Eva 세 저자는 바로 이 지점을 짚습니다. 코칭이 하나의 단일 개념(unitary construct)인 것처럼 다루어지면서 오해와 어설픈 개입이 생긴다는 거예요. 그래서 이들은 스포츠심리학과 조직개발 문헌에서 잘 정리된 코칭의 세 세대(three generations of coaching) 프레임워크를 HPE로 가져옵니다. Grant와 Stelter의 작업이 그 뼈대입니다.


여기서 중요한 건, 이게 "3세대가 제일 좋다"는 이야기가 아니라는 점이에요. 저자들의 표현을 빌리면 이렇습니다.

"어느 하나가 다른 것보다 반드시 더 낫다고 할 수는 없다. 오히려 서로 다른 모델이 서로 다른 맥락이나 서로 다른 시점에 적절할 수 있다."

"It is not necessarily the case that one is better than the other; rather, different models may be appropriate in different contexts or at different moments in time."


📌 먼저, 코칭은 무엇이 아닌가

세 세대로 들어가기 전에 개념 정리부터 합니다. 직장 내 코칭(workplace coaching)은 업무 맥락에서, 주로 상급자나 관리자가, 학습자나 직원이 업무 관련 목표에 도달하도록 돕는 노력을 말합니다. 그런데 이게 비슷한 개념들과 자주 헷갈려요.

  • 교수(teaching)와 다르다: 지식을 전달한다는 의미의 교육은 아니지만, 구조화된 세션부터 일상 업무 중의 즉흥적 대화까지 폭이 넓습니다.
  • 피드백(feedback)과 다르다: 수행의 어떤 부분을 개선해야 하는지 판단을 내리는 것이 본질은 아니지만, 자발적 대화부터 교정적 개입까지 걸쳐 있습니다.
  • 멘토링(mentoring)과의 경계가 가장 모호하다: 저자들은 세 가지 구분을 제시합니다.
    • ① 멘토에게는 해당 분야의 지식과 경험, 지혜가 기대되지만 코치에게는 반드시 그렇지 않다,
    • ② 멘토링의 종착점은 대체로 "멘토처럼 되는 것"인 반면 코칭은 "자기 자신의 더 나은 버전이 되는 것"을 돕는다,
    • ③ 코칭은 특정한 필요를 해결하려는 멘토링보다 경력 개발에 대한 장기적 초점을 갖는 경우가 많다.

저자들은 코칭의 보편적 정의를 만들려는 시도는 하지 않겠다고 분명히 밝힙니다. 대신 언제, 어떻게, 어디서 남을 돕느냐에 따라 이 용어가 어떻게 다르게 쓰이는지를 보여주는 데 집중합니다.


📊 세 세대 한눈에 보기 

차원 (Dimension) 1세대 2세대 3세대
초점 (Focus) 수행관리, 약점 교정, 술기 개발 개인 발달, 모두의 강점 활용, 생각과 감정 의미 만들기/웰빙, 성찰적 대화, 가치와 우선순위
핵심 목표 코치이 외부에 있는 기준을 충족하도록 특정 문제 해결 코치이가 자신의 자산을 활용해 스스로 원하는 변화를 만들도록 코치이가 자신의 가치/핵심 신념을 사회적 맥락과 정렬시키도록
대표 모델 GROW model Appreciative inquiry (AI) Narrative-collaborative practice
통제 소재 (Locus of control) 코치 코치이의 강점 코치이의 가치와 우선순위
동기 유발 요인 전문직으로서의 기대 개인의 경력 목표 광범위한 문제를 시사하는 상황
주요 데이터원 코치이 관찰 코치와 코치이 간 대화 저수행 또는 불만족의 징후
핵심 활동 학습목표 설정 실행계획 구조화 협력적 대화
필요 역량 해당 술기 수행 능력/통찰 제공 성찰 촉진 능력 신뢰와 심리적 안전 구축 능력
임상교육 예시 술기 후 디브리핑 능력 향상 교육 리더가 되기 위한 지도 역량 향상 낮은 교수 평가 극복
비판점 (Critique) 지표 쫓기, 두려움/불안 문화, 관계와 가치 경시 현장 적합성 부족, 전문용어 남발, 진전이 안 보이면 탈동기화 구체적 필요와의 괴리, 심리적 장벽, 코치이를 '타자화'할 위험

저자들은 이 표에 중요한 단서를 붙입니다. 실제 현장에서는 세대 간 상당한 중첩(considerable overlap)이 존재한다는 것, 그리고 '세대'라는 단어가 주는 인상만큼 시간적으로 뚜렷이 구분되지는 않는다는 것이죠.


1️⃣ 1세대: 수행관리로서의 코칭

1980년대 후반부터 1990년대까지의 코칭입니다. 목표는 명확해요. 문제를 찾아내고, 관리자가 그것을 극복하도록 돕는 것.

Sir John Whitmore의 Coaching for Performance에서 나온 GROW 모델이 이 세대의 상징입니다. 코치가 코치이와 함께 문제(Goal)를 정하고, 현재 상황(Reality)을 성찰하게 하고, 개선 방안(Options)을 브레인스토밍한 뒤, 무엇을 실행할지(Will) 약속하게 하죠. 우리에게 익숙한 SMART 목표(Specific, Measurable, Accepted, Realistic, Time-based)도 여기서 나왔습니다.

1세대를 이해하는 열쇠는 통제 소재(locus of control)입니다. Grant의 진단이 꽤 직설적이에요.

"이 시기의 직장 코칭 문헌은 거의 예외 없이 저수행을 관리하는 일과 결부되어 있었다."

"the workplace coaching literature at this point in time was almost invariably associated with managing poor performances"


즉 코치는 '어려운' 직원을 식별하고 그들을 문제 극복 쪽으로 관리해내는 사람이었습니다. GROW 모델에서 코치이가 능동적 역할을 하긴 하지만, 코칭을 시작하고 문제를 정의하는 쪽은 대체로 코치였어요.


⚠️ 그래서 비판도 만만치 않았습니다. 목표 달성 압박이 오히려 수행을 부풀려 보고하는 등 비윤리적 방법을 부추길 수 있다는 지적이 있었고, 두려움과 불안의 문화가 번아웃으로 이어지기도 했습니다. 다만 저자들은 균형을 잡습니다. GROW 같은 목표중심 접근은 지금도 유용하고 널리 쓰이며, 다만 요즘은 정해진 답으로 밀어붙이기보다 코치이의 강점을 활용하고 스스로 목표를 찾게 하는 방향으로 쓰인다는 것이죠. 바로 2세대로 넘어가는 길목입니다.


2️⃣ 2세대: 인재관리로서의 코칭

21세기, 지식경제 시대가 열리면서 조직들은 숙련된 인재를 유치하고 붙잡는 경쟁에 놓입니다. 이제 초점이 바뀌어요. 소수의 약점을 고치는 것이 아니라, 모든 구성원의 강점을 키우는 것.


긍정심리학 코칭과 감사탐구 코칭(appreciative inquiry coaching, AIC)이 대표적입니다. AIC는 문제 자체를 파고들기보다 성공과 강점의 영역을 렌즈 삼아 해결책을 바라보게 합니다.


여기서 오해하기 쉬운 지점을 저자들이 친절하게 짚어줍니다. Bushe의 표현대로, AIC를 쓸 때 '긍정적인 것'에 눈이 멀면 안 된다는 거예요. AIC의 목적은 기분 좋은 분위기(enchantment)를 만드는 게 아니라, 더 나은 미래를 향한 자발적 행동을 가능하게 하는 것입니다. 긍정에 초점을 두는 건 목적이 아니라 수단이라는 이야기죠. Bushe와 Kassam의 메타분석은 AIC가 변혁적이려면


  • ① 사람들이 무엇을 하는지보다 어떻게 생각하는지를 바꾸는 데 쓰이고
  • ② 새로운 아이디어에서 흘러나오는 변화 과정을 지원하는 데 쓰여야 한다고 정리합니다.


1세대와의 차이를 한 줄로 요약하면 이렇습니다. 1세대는 코치이에게 없는 것(결핍)에서 출발하고, 2세대는 코치이가 가진 것(강점)에서 출발합니다.


⚠️ 물론 한계도 있었습니다. 임원 코칭에는 잘 맞았지만 현장의 많은 업무에는 적합성이 떨어졌고, 전문용어가 난무하면서 사람들이 '전도사적 열정'을 가진 내집단과 냉소적인 외집단으로 갈리기도 했습니다. 그리고 가장 근본적으로, 1세대와 2세대 모두 현재 시스템 안에서의 개인적 목표 달성에 머물러 있었어요. 조직을 바꾸려면 코칭이 문화에 어떤 영향을 주는지를 생각해야 했고, 그래서 3세대가 등장합니다.


3️⃣ 3세대: 문화 변화로서의 코칭

3세대는 개인의 수행에 더해 웰빙과 의미 만들기(meaning-making)를 우선합니다. 목표를 아예 안 다루는 게 아니라, 훨씬 더 깊은 층위에서 출발하는 거예요. "당신에게 의미 있는 삶은 어떤 모습인가"를 탐색하는 것이 목표 설정과 의사결정의 출발점이 됩니다.

Stelter의 정의가 이 세대의 핵심을 잘 보여줍니다.

"의미 만들기는 우리가 우리의 경험, 행위, 타인과의 상호작용, 그리고 개인적·전문직업적 상황에 어떤 가치를 부여할 때 일어난다."

"… making meaning occurs when we attribute certain values to our experiences, actions, interactions with others and our personal and professional circumstances"


그래서 좋은 코칭이란 특정 모델을 채택하는 문제라기보다 행위주체성(agency), 의도성(intentionality), 민첩성(agility), 유연성(flexibility)의 문제라고 저자들은 말합니다. 코치와 코치이 사이의 관계성(relatedness)이 결정적으로 중요해지죠. 자기 가치와 맞는 변화를 고민해보고 싶은 마음이 들어야 하니까요.


Stelter와 Law의 내러티브-협력적 실천(narrative-collaborative practice)은 코치와 코치이 모두를 각자의 영역에서 전문가로 대우합니다. 코치이는 자신에게 의미 있고 자기 가치를 반영하는 열망과 목적의식을 가져오고, 코치의 역할은 그 자기이해와 목표 추구를 정련하도록 돕는 것입니다.


⚠️ 여기에도 한계는 있습니다. 당장 구체적 문제를 풀고 싶은 코치이에게 전인적 접근은 답답할 수 있고, 3세대를 설명하는 데 필요한 개념 뭉치가 다시 전문용어 문제를 반복할 수 있으며, 신뢰가 형성되지 않으면 코치이가 '타자화'되었다고 느낄 위험이 있습니다.


🏥 그래서 HPE 문헌은 어디쯤 와 있나

이 부분이 개인적으로 가장 흥미로웠습니다. 저자들은 Lovell의 리뷰를 사례로 듭니다. 이 리뷰는 코칭의 근거가 술기(technical skills) 교육에서 가장 강하고, 비술기 영역이나 웰빙/회복탄력성 코칭에서는 약하다고 결론 내렸어요.


그런데 저자들의 재해석이 날카롭습니다. Lovell이 사용한 코칭의 정의가 행동 관찰과 피드백, 그리고 해당 맥락에 전문성을 가진 코치를 전제했다는 것, 즉 1세대 관점이었다는 겁니다. 그러니 포함 기준 자체가 행동 중심 코칭으로 한정되었고, 실제로 검토된 21편 중 관계 중심이나 가치 기반 상호작용에 초점을 둔 논문은 한 편도 없었습니다.

근거가 약해 보였던 게 아니라, 애초에 그런 근거를 찾을 수 있는 렌즈가 아니었던 셈이죠.


다른 사례들도 이 프레임에 깔끔하게 배치됩니다.

  • Bonrath 등: 복강경 수술에서 좋은 예와 나쁜 예를 제시하는 행동 모델링으로 수술 수행을 향상시킨 RCT → 전형적인 1세대
  • Palamara 등: 내과 인턴을 긍정심리학 훈련을 받은 교수와 짝지어 4회 코칭 세션을 제공, 번아웃 감소와 웰니스 향상 보고 → 2세대
  • R2C2 모델:
    • Relationship 구축 → 수행 데이터에 대한 Reaction 탐색 → 데이터 Content 이해 → 변화를 위한 Coach.
      • 저자들은 이 모델이 학습목표 개발을 강조한다는 점에서 1세대로 볼 수도 있지만,
      • 강점 기반 실행계획으로 가면 2세대에,
      • 협력적 대화와 성찰적 실천을 통해 자기인식과 의미 만들기 능력을 기르는 요소는 3세대에 걸쳐 있다고 봅니다.
    • 한 모델이 세 세대를 관통할 수 있다는 좋은 예입니다.

Armson 등은 R2C2 실행 연구에서 과정 중심(process-oriented) 코칭 기술과 내용 중심(content-oriented) 코칭 기술을 구분하면서, 자기주도성 장려와 역량 보장 사이에 근본적 긴장이 있고 둘을 동시에 달성하기는 어렵다고 보고합니다. "코칭 대화(coaching dialogue)"와 "가르치는 독백(teaching monologue)" 사이에서 균형을 잡는 일이죠.


🔍 그럼 어떻게 고르지? — 한 외과의사의 사례

저자들은 "지도전문의 역량을 키우고 싶은 외과의사"라는 하나의 인물로 세 세대를 모두 보여줍니다.


  • ① 전공의 술기 후 디브리핑 능력을 키우고 싶다 → 1세대
    • 코치가 디브리핑 장면을 관찰하고, 문제와 관련될 만한 지점을 기록해 두었다가, 이후 코칭 세션에서 관찰 내용을 공유합니다. 외과의사가 의도한 것과 코치가 관찰한 것 사이의 정렬을 탐색하는 거죠. 여기서는 관계가 상대적으로 덜 중요합니다. 목표가 명확히 정의되므로 논쟁거리는 "거기까지 가는 최선의 방법"뿐이니까요. 다만 관계적·가치적 역동을 놓치기 쉽고, 지적된 문제가 실은 더 깊은 문제의 표면적 증상일 때 한계가 드러납니다.
  • ② 교육 리더가 되고 싶어서 지도 역량을 키우고 싶다 → 2세대
    • 자신과 동료들에게 잘 통했던 경험, 지도할 때 에너지가 났던 순간에 주의를 돌립니다. 여기서 코치는 그 술기를 직접 수행하거나 평가할 능력이 없어도 됩니다. 성찰을 촉진하는 게 역할이니까요. "한 가지 옳은 방법"이 있다고 보지 않고, 다양한 형태의 강점이 목표로 이어질 수 있다는 데 초점을 둡니다. 대신 큰 그림 목표라 진전이 눈에 잘 안 보이면 코치이가 흥미와 인내심을 잃을 수 있습니다.
  • ③ 교수 평가 점수가 나빠서 개선이 필요하다 → 3세대
    • 가장 까다로운 상황입니다. 낮은 평가가 만들어낸 위협을 완화하면서, 전문직 정체성 갈등(professional identity conflicts) 같은 개인적 장벽을 넘어서야 하거든요. 코치는 강한 관계적 토대와 안전하고 신뢰할 수 있는 개방적 환경을 만드는 데 상당한 노력을 들여야 합니다. 그래야 그 외과의사가 자기 어려움을 편안하게 꺼내놓죠. 신뢰가 없으면 오히려 심리적 장벽만 쌓이고 방어적 반응이나 피상적 해결에 머무릅니다.


Armson 등의 결론이 이 대목을 잘 요약합니다.

"지도전문의에 의한 효과적인 코칭은 개인의 필요에 따라 선택되는 구체적인 과정 기술과 내용 기술의 조합을 요구한다."

"effective coaching by supervisors requires a combination of specific process and content skills that are chosen depending on the needs of the individual"


💡 그리고 여기서 저자들이 던지는 질문이 논문 제목이기도 합니다.


  • "지금 이 순간, 나는 어떻게 도울 수 있을까?(How can I help at this moment?)"
  • 그런데 저자들은 한 걸음 더 나갑니다. "지금 이 순간, 도와야 할 사람이 내가 맞는가?(Am I the right person to help at this moment?)"
  • 유능한 코치는 자신의 접근을 조정할 수도 있어야 하지만, 더 적합한 사람에게 코치이를 의뢰할 줄도 알아야 한다는 것이죠.


🛠️ 실행 단계에서 달라지는 것들

세대별로 실제 운영 방식이 어떻게 달라지는지도 정리해 줍니다.


  • 1세대라면, 코치는 코치이가 아직 갖지 못한 통찰을 줄 수 있어야 합니다.
    • 그러려면 바꾸고자 하는 행동에 대한 통찰이 필요하고, 관찰과 피드백 사이클이 뒤따릅니다.
    • 초점이 코치이의 전문직업적 레퍼토리 안에 있는 것이므로 강한 관계 형성 여부는 성패에 큰 영향을 주지 않습니다.
  • 2세대라면, 코치이의 핵심 질문은 "내 강점을 어떻게 활용해서 이 변화를 만들 수 있을까?"가 됩니다.
    • 술기 연습이 아니라 강점 확인과 장애물 제거가 초점이에요. 코치는 표면적으로 드러난 문제와 더 근본적으로 발목을 잡는 개념화를 구분하도록 도와야 합니다. 앞의 예시로 돌아가면, 그 외과의사가 교육 리더가 못 되는 이유는 교육자로서의 역량 부족이 아니라 그 전환에 무엇이 필요한지에 대한 오해일 수 있죠.
    • 이슈가 덜 노골적이고 해법도 덜 명확하므로 더 길고 깊은 대화가 필요합니다.
  • 3세대라면, 질문 자체가 달라집니다.
    • "내 가치와 우선순위는 무엇인가?", "어떻게 그에 부합하게 살 수 있을까?", "내 일에서 어떻게 의미를 만들 수 있을까?", "잘 산 삶은 나에게 어떤 모습인가?"
    • 여기서 특정 문제는 더 넓은 이슈의 지표일 뿐이라는 인식이 필요합니다.


그리고 3세대에서 유독 강조되는 지점이 있습니다. 1세대와 2세대에서는 원하는 변화가 전문직에 의해 정해졌거나 코치이 스스로 원한 것이라 코치와 코치이의 이해가 암묵적으로 정렬됩니다. 그런데 3세대의 목표는 코치가 속한 바로 그 시스템 안에서 코치이가 힘들어하는 상황에서 나오는 경우가 많습니다. 코치가 아무리 지지적이어도 '시스템 안에 있다'는 사실 자체가 코치이의 위협감을 풀지 못하게 만들 수 있어요. Godskesen과 Kobayashi가 외부 코치(external coach)의 가치를 주장한 이유입니다. 보복 걱정 없이 민감한 사안과 의구심, 약점을 드러낼 수 있는 공간이 되니까요.


✍️ 읽고 나서

이 논문의 미덕은 새로운 모델을 하나 더 얹지 않았다는 데 있습니다. 대신 우리가 이미 쓰고 있는 것들에 좌표를 부여했어요. 저 자신이 하고 있는 코칭이 몇 세대인지 이름 붙일 수 있다는 것만으로도, "이 상황에 이 접근이 맞나"를 물을 수 있게 됩니다.

한국 의학교육 맥락에서 몇 가지가 특히 걸립니다.

  • 우리가 "코칭"이라 부르며 도입한 것들 상당수가 실은 1세대 수행관리에 가깝지 않은지. 그러면서 3세대적 결과(웰빙, 전문직 정체성)를 기대하고 있지는 않은지.
  • 지도전문의 워크숍에서 가르치는 코칭 기술이 어느 세대를 전제하는지. 세대를 명시하지 않으면 참여자마다 다른 것을 배워 갑니다.
  • 그리고 가장 뼈아픈 지점. 평가자이면서 동시에 코치인 구조에서 3세대 코칭이 가능한가. 저자들의 답은 "가능하지만 상당한 위험이 있다"이고, 그 대안이 외부 코치입니다. 우리 수련 환경에서 이건 상당히 실질적인 설계 문제입니다.

연구자 입장에서 마지막 문장도 새겨둘 만합니다. 코칭 중재를 포함하는 HPE 연구는 어떤 유형의 코칭을 쓰고 있는지 의도적으로 밝혀야 원하는 결과와 연구 설계가 정렬된다는 것. 지금까지 "코칭의 효과"를 묻는 수많은 연구가 사실은 서로 다른 것을 재고 있었을 수 있으니까요.

저자들의 마무리는 이렇습니다.

"세 세대의 코칭 모두가 보건의료전문직교육에서 자리를 갖는다."

"all three generations of coaching have a place in health professional education."


1. 서론 (INTRODUCTION) 

최근 몇 년간 보건의료전문직교육에서 코칭 연구가 급증했으며, 여기에는 타당한 이유가 있다. 여러 출판물에서 코칭이 보건의료전문가(health care professionals)의 학습, 웰빙, 수행을 촉진할 수 있음을 보여주었다.1–3 그러나 이전의 모든 유사한 연구 확산에서 그러했듯,4 이 용어가 다양하게 사용되고, 그 결과 의사소통 오류(miscommunication)와 명료성이 확보되지 않을 경우 최적에 미치지 못하는 개입(suboptimal intervention)이 발생할 위험에 대한 우려가 제기된다. 실제로 매우 다양한 코칭 모형이 제안되어 왔으며, 각각은 서로 다른 목적, 논리, 이론적 틀(theoretical framing), 강조점을 가진다. 반드시 어느 하나가 다른 것보다 더 낫다고 할 수는 없으며, 오히려 서로 다른 모형이 서로 다른 맥락이나 서로 다른 시점에 적합할 수 있다. 안타깝게도 보건의료전문직교육에서는 모형 간 차이와 그 함의가 명시적으로 상세히 다루어지지 않았다. 이 분야 횡단의 최전선 논문에서 우리는 스포츠심리학과 비즈니스 문헌을 바탕으로 코칭의 세 세대를 개관하고, 보건의료전문직 교육자와 수련생이 자신의 직장 기반 학습목표(workplace-based learning goals)에 어떤 세대가 가장 적합할 가능성이 높은지, 무엇을 달성할 수 있으리라 기대할지, 각 세대를 뒷받침하는 패러다임에는 어떤 한계가 내재하는지를 더욱 구체적으로 명시할 수 있는 수단을 제공한다. 이를 위해 코칭의 진화를 기록하는 데 특히 두드러진 역할을 해 온 Grant5와 Stelter6의 연구를 상세히 살펴본다. 이어서 코칭 연구의 뿌리와 그것이 보건의료전문직교육의 연구 및 실무 맥락에서 적용되어 온 방식을 연결한다. 그러나 이러한 세부사항을 논하기에 앞서 몇 가지 정의상의 토대(definitional foundations)를 마련해야 한다. 


표 1. Grant5와 Stelter6가 확인한 세 세대별 코칭의 특성(실제 실천에서는 상당한 중첩이 존재한다는 단서를 전제로 함).

차원 (Dimension) 1세대 (First generation) 2세대 (Second generation) 3세대 (Third generation)
초점 (Focus) ·   수행관리(performance management)
·   낮은 수행의 교정
·   술기 발달(skill development)
·   개인발달(personal development)
·   모든 사람의 강점 활용
·   사고와 감정
·   의미 만들기·웰빙
·   성찰적 대화(reflective dialogue)
·   가치와 우선순위
포괄적 목적 (Overarching aim) ·   피코치 외부의 기준을 충족하기 위해 특정 문제를 해결 ·   피코치가 자신의 자산을 활용하여 스스로 원하는 변화를 이루도록 함 ·   피코치가 자신의 가치·핵심 신념을 정렬하여 사회적 맥락에 부합하는 변화를 이루도록 함
예시 (Example) ·   GROW 모형¹² ·   강점탐구(appreciative inquiry)¹⁴ ·   서사적-협력적 실천(narrative-collaborative practice)²¹
통제소재 (Locus of control) ·   코치 ·   피코치의 강점 ·   피코치의 가치와 우선순위
동기요인 (Motivator) ·   전문직의 기대 ·   개인의 경력목표 ·   광범위한 문제를 시사하는 상황
전형적 자료원 (Typical data source) ·   피코치 관찰 ·   코치와 피코치 간 대화 ·   낮은 수행 또는 불만족의 징후
핵심 활동 (Key activity) ·   학습목표 개발 ·   실행계획 구조화 ·   협력적 대화
필요 자산 (Required asset) ·   원하는 술기를 수행하거나 통찰을 제공할 수 있는 능력 ·   성찰을 촉진할 수 있는 능력 ·   신뢰와 심리적 안전(psychological safety)을 구축할 수 있는 능력
특별한 용도 (Particular use) ·   구체적·가시적 문제를 중심으로 한 술기 발달(흔히 옳고 그른 답이 있음) ·   경력 방향과 관련된 더 복잡한 문제(흔히 덜 구체적임) ·   피코치의 수용성 유도(흔히 권력 불균형과 관련됨)
임상교육 사례 (Clinical education example) ·   임상술기 후 디브리핑 기술 향상 ·   교육 리더가 되기 위한 감독 능력 향상 ·   낮은 교수평가 점수 극복
비판 (Critique) ·   지표 추종(metric chasing)
·   두려움·불안의 문화
·   관계와 가치의 중요성 간과
·   직장과의 관련성 부족
·   전문용어화된 언어
·   진전이 인식되지 않을 때 동기 저하
·   구체적 요구와의 단절
·   심리적 장벽을 구축할 위험
·   피코치를 ‘타자화(othering)’할 위험


2. 코칭의 토대 (FOUNDATIONS OF COACHING) 

‘직장 코칭(workplace coaching)’(이하 간단히 코칭이라고 함)은 직장 맥락에서 흔히 감독자(supervisor)나 관리자가 학습자 또는 직원을 업무 관련 목표의 달성으로 이끌기 위해 기울이는 노력을 뜻한다. 이 용어가 포괄하는 활동의 범위가 넓다는 점을 고려하면, 코칭이 관련 구성개념들과 자주 혼동되는 이유를 쉽게 이해할 수 있다.


  • 코칭은 지식을 전달한다는 의미에서의 ‘교수(teaching)’는 아니지만, 그 활동은 교수활동이 포함될 수도 있는 공식적이고 구조화된 세션부터 일상 업무 상호작용에 통합되는 비공식적이고 즉흥적인 대화(informal ad-hoc conversations)에 이르기까지 다양하다.
  • 또한 수행의 어떤 측면을 개선해야 하는지에 관한 판단을 내포한다는 의미에서의 ‘피드백(feedback)’도 아니지만, 그 활동은 피코치(coachee)가 주도하는 자발적 대화부터 개선조치(remedial activity)가 요구되어 시작되는 상호작용에 이르기까지 폭넓다.5
  • ‘멘토링(mentoring)’과의 경계는 특히 불분명하다.2 흔히 제시되는 차이는 다음과 같다.
    • (a) 멘토에게는 일반적으로 특정 분야의 지식, 경험, 지혜가 요구되지만, 코치에게 반드시 요구되는 것은 아니다.7
    • (b) 멘토링의 ‘궁극적 목표(end-game)’는 대체로 멘토와 같은 사람이 되는 것이지만, 코칭은 주로 피코치가 더 나은 자기 자신이 되도록 돕기 위해 시행된다.8
    • (c) 코칭은 흔히 멘토링보다 경력개발(career development)에 더 장기적인 초점을 두는 반면, 멘토링은 흔히 특정한 요구를 해결하기 위해 시행된다.9


여기서 우리는 코칭에 대한 단 하나의 보편적 정의를 제시하려는 함정에 빠지지 않고, 다른 사람이 학습목표를 추구하도록 돕기 위해 어떻게, 언제, 어디에서 행동하는지에 따라 달라지는 용어 사용의 차이를 부각하고자 한다.


코칭에 관한 보고는 1980년대 경영학 문헌에서 나타나기 시작했다. 여기서 코칭은 일반적으로 인간 수행(human performance)의 최적화를 의미했지만,5 곧이어 코칭 현상에 접근하는 방식과 그에 따라 권장되는 방법론이 갈라졌다.


  • 스포츠심리학에 뿌리를 둔 한 관점은 수행을 강하게 강조했고,
  • 인본주의 및 실존주의 심리학(humanistic and existential psychology)에 뿌리를 둔 다른 관점은 자아실현(self-actualisation), 즉 자신의 잠재력을 온전히 실현하는 데 더 큰 초점을 두었다.10,11


1990년대에 코칭의 활용이 확대되기 시작한 이후, Grant5와 Stelter6는 코칭과 그 목적 및 가치에 관한 서로 다른 세계관(worldviews)에 주의를 환기해 온 대표적 학자였다. 이 과정에서 두 학자는 오늘날에도 사용되고 있는 세 세대의 사고를 기록했다. 이에 우리는 다른 영역에서 코칭 실무가 어떻게 진화했는지를 이해함으로써, 보건의료전문직교육에서 ‘코칭’이라는 용어를 더 섬세하고 의도적으로 사용할 수 있도록 이들의 세 세대를 지침으로 삼는다(표 1).


세대 간에는 중첩이 있으므로, ‘세대’라는 단어가 암시할 수 있는 것만큼 시간적으로 명확히 구분되지는 않는다는 점을 인정하는 것이 중요하다. 서로 다른 영역에서 일하는 사람들이 특정 접근을 수용하거나 폐기해 온 것은 사실이지만, 세대 프레임워크를 통해 코칭을 이해하면 진화하는 경향에 관한 유용한 관점을 얻을 수 있다. 따라서 주어진 맥락에서 어떤 형태의 코칭이 가장 도움이 될 수 있는지에 관한 의사결정을 촉진하기 위해, 먼저 각 세대를 간략히 검토한 후 이러한 진화가 보건의료전문직교육에서 코칭을 논의하고 실천하는 방식과 어떻게 정렬되는지를 살펴본다.

3. 1세대: 수행관리로서의 코칭
(GENERATION 1: COACHING AS PERFORMANCE MANAGEMENT)
 

1980년대 후반부터 1990년대 전반에 걸쳐, 1세대 코칭 모형은 수행관리에 크게 초점을 두었다.5 즉, 코칭의 주된 목적은 문제를 찾아내고 관리자가 다른 사람들이 그 문제를 극복하도록 코칭하게 하는 것이었다.15 Sir John Whitmore가 『Coaching for Performance』에서 발표한 GROW 모형(GROW model)이 이 세대에 등장했다.16


  • 이 방법은 코치가 피코치가 문제, 즉 추구하고자 하는 ‘목표(Goal)’를 찾아내도록 돕는 데서 시작한다.
    • 이러한 필요에 따라 Whitmore는 코칭에서 오늘날에도 널리 사용되는 SMART 기준(SMART criteria)을 제안했는데, 이는 구체적(Specific), 측정 가능(Measurable), 수용됨(Accepted), 현실적(Realistic), 시간 제한이 있음(Time-based)을 갖춘 목표를 우선시한다.12
  • 목표가 확인되면, 코치의 역할은 피코치가 자신의 ‘현실(Reality)’(현재의 능력과 맥락)을 성찰하도록 격려하고,
  • 개선에 활용할 수 있는 ‘선택지(Options)’를 브레인스토밍하며,
  • 이 선택지 목록 가운데 무엇을 실행하기로 ‘의지(Will)’하고 전념할지를 선택하도록 돕는 것이다.


1세대 코칭을 이해하는 핵심은 통제소재(locus of control)이다. Grant의 표현에 따르면, ‘당시 직장 코칭 문헌은 거의 예외 없이 낮은 수행의 관리와 연관되어 있었다’.5 다시 말해, 코치는 흔히 의무적 수행평가(mandated performance reviews)를 통해 ‘다루기 어려운’ 직원을 찾아내고, 그들이 문제를 극복하도록 어떻게 관리할지를 파악할 책임이 있는 사람이었다. GROW 모형이 잘 보여주듯 피코치가 적극적 역할을 맡을 것으로 기대되기는 했지만, 코칭은 일반적으로 코치가 발견한 문제로부터 시작되어 그 문제에 초점을 두었다.


  • 한 가지 실증적 사례로, 영업관리자가 코칭 역할을 맡도록 훈련하는 5일 과정에 참여한 연구를 살펴보자.17 관리자는 판매 건수가 가장 낮은 직원의 수행이 향상되도록 코칭할 것으로 기대되었다. 영업사원과 고객의 상호작용을 관찰하면서, 관리자는 행동 체크리스트(behavioural checklist)를 사용하여 개선이 필요한 부분을 찾아내도록 훈련받았다. 순매출 증가를 관찰한 저자들은 코칭이 수행에 대한 기대를 명료화하고 피드백 제공을 가능하게 했으며 동기를 부여하는 보상을 제공했다고 결론 내렸다.


이러한 이점을 얻을 수도 있지만, 목표 설정과 문제 해결을 강조하는 1세대 코칭은 수행목표(performance targets)를 달성하기 위해 자신의 수행 수준을 허위로 제시하는 것과 같은 비윤리적 방법을 직원이 의도치 않게 추구하도록 부추길 수 있다는 비판을 받아 왔다.18,19 1세대 코칭에 수반되었던 두려움과 불안의 문화는 흔히 소진(burnout)으로 이어졌고, 결국 조직은 위기 사고방식(crisis mentality)에 의한 관리에서 벗어나게 되었다.5 그렇다고 해도 GROW 모형과 같은 목표 중심 접근(goal-focused approaches)은 여전히 유용하며 광범위하게 적용되고 있다.20 다만 이제는 피코치를 단순히 원하는 해법으로 밀어붙이기보다, 각 피코치의 강점을 활용하고 그들 스스로 목표를 찾아내도록 하는 데 더 자주 사용되며, 이는 2세대의 발전과 일치한다.

4. 2세대: 인재관리로서의 코칭
(GENERATION 2: COACHING AS TALENT MANAGEMENT)
 

21세기의 시작과 지식경제(knowledge economy)의 출현으로, 조직은 숙련된 노동자를 유치하고 유지하기 위한 경쟁이 증가하는 것을 목격하기 시작했다. 이러한 압력은 1세대의 한계와 함께, 소수 직원의 해결해야 할 약점에 초점을 맞추기보다 모든 직원의 강점을 증진하려는 방향으로 코칭 옹호자들이 전환하게 했다. 다시 말해, 피코치의 요구에 관한 협의에 더 많은 주의를 기울이면서 장기적 성장과 발달이 우선시되기 시작했다.21,22 긍정심리학 코칭(positive psychology coaching)과 강점탐구 코칭(appreciative inquiry coaching, AIC)은 2세대의 토대가 되는 강점 지향성(strength-orientation)을 잘 보여주는 사례다. 전자에서는 피코치가 더 나은 수행을 추구하도록 동기를 부여하기 위해 긍정적 정서, 참여(engagement), 의미 만들기를 구축하는 데 중점을 둔다.23 AIC도 마찬가지로, 특정 문제에 대한 해결책을 검토하는 렌즈로서 성공과 강점의 영역을 탐색함으로써 변화에 관한 대화를 전환한다.14


2세대 코칭의 궁극적 목표도 여전히 수행 향상이고, 관리자가 ‘마주 앉아 대화하며’ 특정 문제를 해결하도록 가르치는 것을 여전히 우선시하지만, 정서지능(Emotional Intelligence)과 같은 구성개념이 더해지면서 강조점은 더 높은 수준의 인본주의(humanism)로 이동했다.5 즉, 1세대 코칭은 피코치에게 부족한 것과 약점 영역에 초점을 두고 이를 해결하는 전략을 수립하는 반면, 2세대 코칭은 피코치 고유의 강점을 활용하여 단지 문제를 극복하는 데 그치지 않고 개인발달을 위한 전략을 가능하게 한다. AIC 활용에 관한 메타분석에서 Bushe와 Kassam은 AIC가 변혁적(transformative)이 되려면


  • (a) 사람들이 무엇을 하는지보다 어떻게 생각하는지를 변화시키는 데 사용되어야 하고,
  • (b) 새로운 아이디어로부터 이어지는 변화 과정을 지원하는 데 초점을 두어야 한다고 밝혔다.24


AIC를 적용할 때는 Bushe가 표현한 것처럼 ‘긍정적인 것(positive stuff)’에 눈이 멀지 않는 것이 중요하다.25 매혹(enchantment)을 조장하기보다, AIC의 주된 목적은 더 나은 미래를 향한 자발적 행동을 가능하게 하는 것이다. 다시 말해, 긍정적인 것에 초점을 맞추는 행위는 새롭고 더 나은 실천을 만들어내고, 현재의 문제에만 제한적으로 초점을 맞추는 대신 개방적 사고(open-mindedness)를 유도한다는 목표에 도달하기 위한 수단이다.


이처럼 유망한 결과에도 불구하고, 초기 실천 과정에서 2세대 코칭에는 몇 가지 문제가 나타났다. 코칭의 강조점이 넓어지는 것은 경영진을 코칭할 때 흔히 가치가 있었지만, 많은 직장 기반 과업과의 관련성은 더 낮은 것으로 나타났다. 고도로 전문용어화된 언어(jargonised language)는 사람들을 각각 ‘복음주의적 열의(evangelical zeal)’와 환멸에 찬 반감(disenchanted resentment)을 특징으로 하는 내집단(in-groups)과 외집단(outgroups)으로 나누었다. 또한 공식적으로 구조화된 대화를 강조하면 직장의 제약과 동떨어져 있다는 느낌을 주는 경향이 있었다.5 그러나 가장 핵심적인 문제는 1세대와 2세대 모두 현재 체계 안에서 개인이 목표를 성취하는 데 중점을 두는 반면, 조직을 변화시키려면 코칭이 문화에 어떻게 영향을 미칠 수 있는지를 고려해야 했다는 점이며, 이는 3세대로 이어졌다.

5. 3세대: 문화 변화로서의 코칭
(GENERATION 3: COACHING AS CULTURE CHANGE)
 

3세대 코칭은 개인의 수행뿐 아니라 웰빙과 의미 만들기를 우선시한다. 개인의 목표는 여전히 달성될 수 있고 실제로 달성되지만, 코칭의 초점은 1세대나 2세대보다 훨씬 더 깊어서 피코치가 자신에게 의미 있는 삶이 어떤 모습인지를 탐색하고, 이를 목표를 정의하고 그와 관련된 의사결정을 내리는 수단으로 삼도록 격려한다. 따라서 Stelter는 문제나 성공을 바라보기보다, 3세대 코칭은 내담자의 성찰 능력을 강화하는 것을 목표로 유연한 대화를 강조한다고 주장한다. ‘… 의미 만들기는 우리의 경험, 행동, 타인과의 상호작용, 개인적·직업적 상황에 특정한 가치를 부여할 때 일어난다’.13 이를 통해 피코치는 ‘더 큰 그림(bigger picture)’에 초점을 맞추고, 다양한 도전에 직면했을 때 지속 가능한 대처(sustainable coping)를 가능하게 하는 자기조절(self-regulation)에 참여할 수 있는 능력을 발달시킨다. 다시 말해, 좋은 코칭은 특정 모형을 채택하는 것보다 주체성(agency), 의도성(intentionality), 민첩성(agility), 유연성(flexibility)에 더 관련된다. 따라서 코치와 피코치 간의 관계성(relatedness)은 매우 중요하다. 피코치는 자신의 가치와 정렬되는 변화를 숙고할 기회에 매력을 느낄 필요가 있기 때문이다.


3세대에서 핵심적인 요소는 코치가 경험을 중심으로 대화를 이끌면서, 무엇을 했는지보다 그것이 왜 중요한지에 관한 질문을 제기하는 것이다.26 이를 확립하기 위해 Stelter와 Law21는 코치와 피코치 모두를 각자의 권리를 가진 전문가로 대우하면서 코치가 ‘서사적-협력적 실천(narrative-collaborative practice)’에 참여하도록 장려하는 방법론을 개발했다. 이러한 대화에서 피코치는 자신에게 의미가 있고 자신의 가치를 반영하는 행동을 향한 열망과 목적의식을 가져오며, 이와 대조적으로 코치의 역할은 자기이해(self-understanding)와 목표 추구(goal pursuits)를 정교화하도록 돕는 것이다. Godskesen과 Kobayashi는 이러한 원칙을 활용하여 코칭이 지도교수-학생 관계(supervisor-student relationships)를 개선하고 학생의 진전감(feelings of progress)을 높일 수 있음을 보여주었다.27 마찬가지로 한 무작위대조시험(randomised controlled trial)은 가치 기반 코칭(value-based coaching)이 수련생의 웰빙을 개선할 수 있음을 발견했다.28 자신의 정서와 사고에 대한 자각(awareness)을 위한 코칭이 학생을 더 성찰적이고 마음챙김하며 자기결정적인 존재로 만들 수 있다는 근거가 축적되면서,29 가치 기반 코칭의 성과가 특정 문제를 극복하는 능력보다 더 폭넓은 구성개념과 관련됨을 알 수 있다.


그렇다고 해서 3세대 코칭이 1세대와 2세대의 문제를 ‘해결한다’는 뜻은 아니며, 이들 접근을 대체하는 것도 아니다. 실제로 특정 문제를 해결하는 데 매우 집중하고 있는 피코치는 전인적 코칭(holistic coaching) 노력에 좌절감을 느낄 수 있다고 쉽게 상상할 수 있다. 마찬가지로 3세대를 설명하는 데 필요한 다양한 구성개념은 전문용어화된 언어로 인해 일부 사람이 환멸을 느끼는 문제를 되풀이할 가능성이 있다. 코칭의 세 세대를 상호보완적(complementary)으로 바라보면, 각 세대가 언제 가치가 있는지에 관한 ‘더 큰 그림’의 질문이 제기된다.


  • 즉, 다양한 상황의 어떤 특성이 특정 코치가 특정 전략을 우선시하는 데 도움이 될 수 있는가?
  • 지금 이 순간, 내가 어떻게 도울 수 있는가(How can I help at this moment)?
  • 이와 비슷하게, 어떤 특성이 다른 코치가 상황의 요구에 더 적합하다는 결론을 내리는 데 도움이 될 수 있는가?
  • 지금 이 순간, 내가 도움을 줄 적임자인가(Am I the right person to help at this moment)? 

이러한 질문을 다루기 시작하기 위해, 보건의료전문직교육에서 코칭이 어떻게 설명되어 왔는지에 관한 간략한 요약과 사례를 제시한다.


6. 보건의료전문직교육과 코칭의 세대
(HEALTH PROFESSIONAL EDUCATION AND THE COACHING GENERATIONS)
 

보건의료전문직교육에서 코칭은 점차 더 큰 주목을 받아 왔다. 많은 이들이 자기조절 전문가(self-regulating professionals)가 평생에 걸친 질 향상(lifelong quality improvement) 노력에 참여할 수 있도록 하고, 수련생의 전문직 발달(professional development) 노력을 피드백과 평가(assessment)에 수반되는 위협으로부터 분리하고자 코칭의 가치에 관심을 기울이게 되었다.30–32 그러나 다양한 형태의 코칭을 비교·대조하려는 체계적인 노력은 거의 이루어지지 않았고, 그 결과 이러한 노력이 목적에 맞게 효과적으로 조정되었는지 면밀히 분석하기 어려웠다.


Lovell의 문헌고찰은 의학교육에서 개인적·전문직 발달을 위한 코칭의 큰 잠재력을 부각하면서도, 이 논문에서 개관한 것과 같은 코칭 모형의 상세한 분류체계(taxonomy)가 필요함을 더욱 뒷받침하는 이론적 불확실성(theoretical uncertainty)의 문제를 지적했다.2 저자는 비기술적 술기(non-technical skills)나 웰빙·회복탄력성(resilience)을 위한 코칭에 비해, 기술적 술기(teaching technical skills)를 가르치는 데서 코칭의 이점을 뒷받침하는 근거가 가장 강하다고 결론지었다.


  • 예를 들어 Bonrath와 동료들은 복강경수술(laparoscopic surgery)에서 결함을 교정하고 긍정적 행동을 강화하기 위해 행동모형화(behavioural modelling)를 활용하여, 코칭 개입집단에 좋은 사례와 나쁜 사례를 모두 제시했다. 이 집단은 대조군 참여자보다 더 나은 수술 수행을 보였다.33


그러나 이러한 결과는 Lovell의 문헌고찰에서 코칭의 초점이 행동관찰과 피드백이었고 코치가 관련 맥락의 전문성을 갖추었다는 점을 인식하여 맥락화할 필요가 있다.2 1세대 관점과 매우 잘 부합해 보이는 이러한 정의는 저자의 포함기준(inclusion criteria)을 행동에 초점을 둔 코칭 상호작용으로 제한했다. 실제로 검토된 21편의 논문 가운데 2세대 또는 3세대 코칭에 부합하는 관계 중심 또는 가치 기반 상호작용에 초점을 둔 연구는 없었다. 따라서 이 논문은 1세대가 술기 발달에 어떻게 유용할 수 있는지, 그리고 Lovell이 발견한 근거가 비기술적 술기나 웰빙을 지원하는 코칭에서 왜 더 약했을 수 있는지를 모두 잘 보여주는 사례다.2


강점을 활용하여 원하는 목표를 달성하는 데 초점을 두는 2세대 코칭의 사례는 Bonrath 등의 논문과 같은 해에 출판된 Palamara와 동료들의 연구에서 찾을 수 있다. 이 연구에서 코칭은 내과 전공의 수련 기간의 소진을 최소화하고 성공을 촉진하는 것을 목표로 했다.34 전공의는 긍정심리학 활동(positive psychology exercises)을 활용하는 코치로 훈련받은 교수와 짝을 이루었다. 프로그램은 전공의에게 네 차례 코칭 세션을 제공했으며, 전공의가 스스로 설정한 목표를 달성하기 위한 수단으로 긍정적 정서와 강점에 접근하도록 설계된 구조화 활동을 활용했다. 저자들은 이를 통해 1세대 방식의 코칭 개입 연구에서 도출된 결론으로 예상되는 것보다 더 큰 웰니스(wellness) 향상을 보고했다.


더 최근의 사례이자 자신의 코칭을 상황에 맞게 정렬하는 데 관한 논의를 발전시키는 데 특히 유용한 것은 널리 알려진 R2C2 모형이다.35 촉진된 성찰적 수행 피드백(facilitated reflective performance feedback)에 기반을 둔 R2C2는 네 단계를 설명한다.


  • 관계 형성(build Relationship),
  • 수행자료에 대한 반응 탐색(explore Reactions to performance data),
  • 자료 내용에 관한 이해 탐색(explore understanding of the data Content),
  • 수행 변화를 위한 코칭(Coach for performance change)이다.


이 모형은 주로 학습목표의 개발을 강조한다. 따라서 코칭의 초점에 따라 R2C2는 1세대로 간주될 수 있다. 그러나 이 모형이 장려하는 대화는 피코치가 자신의 강점을 바탕으로 스스로 해결책을 찾기 위해 실행계획(action plans)을 구조화하는 데 초점을 둘 수 있으며, 이는 2세대에 더 부합한다. 더 나아가 R2C2 모형의 명시적 구성요소에는 협력적 대화(collaborative dialogue)와 성찰적 실천(reflective practice)이 포함되며, 피코치의 자기인식(self-awareness)과 의미 만들기 능력을 발달시키는 것을 목표로 하므로 3세대에 해당한다. 이 논문의 앞부분에서 언급했듯이, 피드백은 코칭 대화의 일부가 될 수 있지만 근본적인 필수요건은 아니다. 맥락에 따라 피드백을 유연하게 포함하거나 보류하는 것이 피코치의 수용성(receptivity)과 참여를 유지하는 데 중요할 수 있다.36


Armson 등은 실제 R2C2를 탐색하면서 과정 지향 코칭 기술(process-oriented coaching skills)과 내용 지향 코칭 기술(content-oriented coaching skills)을 구분했다.37 이 과정에서 코치가 준비하고 피코치와 관계를 형성하며 의사소통하는 방식, 즉 과정 지향 코칭 기술이 피드백 제공, 협력적 목표 설정(collaborative goal setting), 학습계획의 공동개발(co-development of learning plans) 같은 내용 지향 코칭 기술과 상호연결되어 있음을 관찰했다. 따라서 이들은 자기주도성(self-direction)을 장려하는 것과 역량(competence)을 보장하는 것 사이에 근본적인 긴장이 존재한다고 보고한다. 둘 다 중요하다고 여겨지지만 반드시 동시에 달성할 수 있는 것은 아니다. 그러므로 ‘코칭 대화(coaching dialogue)와 교수 독백(teaching monologue)’ 사이에서 적절한 균형을 찾는 일은 달성해야 할 구체적인 목표에 크게 좌우되는 것으로 보이며, 어느 코칭 세대든 그 장점과 단점을 더욱 신중히 고려할 것을 요구한다.

7. 함의 (IMPLICATIONS) 

7.1. 어떻게 선택할 것인가? (How to choose?) 

Grant와 Stelter 모두에 따르면, 코칭이 문제 해결과 개인발달, 의미 만들기와 웰빙 가운데 무엇에 초점을 두어야 하는지를 의도적으로 결정하고 인식하는 것이 중요하다.5,6 결국 요구와 기대를 코칭 접근에 정렬하는 것은 피코치의 동기, 참여, 지각된 가치(perceived value)를 유지하는 데 결정적이다. 이들의 연구는


  • 1세대가 개인에게 내재하는 구체적이고 가시적인 문제를 중심으로 한 술기 발달과 피드백 제공에 특히 유용함을 시사한다. 이러한 활동은 흔히 옳고 그른 답이 있기 때문에 알아보기 쉬우며, 따라서 전문가 주도(expert-led)로 합리적으로 수행될 수 있다.
  • 2세대는 자신의 강점을 찾아내고 활용하여 개인이 경력을 어떤 방향으로 이끌고 싶은지와 같은 더 복잡한 문제에 더 적합하다.
  • 마지막으로 3세대는 권력 불균형(power imbalance)이 있거나, 관계를 세심하게 관리해야 하거나, 정체성 위협(identity threat)이 있을 때처럼 피코치의 수용성을 이끌어낼 필요가 있을 때 특히 가치가 있을 수 있다.


표 1에 요약된 이러한 차이를 더 자세히 살펴보고 각 세대의 조작화(operationalisation), 장점, 단점에 관해 성찰하기 위해, 수련생 감독 능력을 향상하고자 하는 외과의사의 사례를 생각해보자.

  • 외과의사가 수련생의 수술 수행을 관찰한 뒤 이루어지는 디브리핑(debriefing) 기술을 개선하고자 한다면, 1세대 모형을 활용한 코칭의 도움을 받을 수 있다.
    • 여기에는 코치가 디브리핑 세션을 관찰하면서 외과의사의 행동에 초점을 맞추고, 직면한 문제와 관련될 수 있는 지표(markers)를 기록하는 것이 포함될 수 있다. 이후 코치는 별도의 코칭 세션에서 관찰내용을 외과의사와 공유하며, 외과의사의 의도와 코치의 관찰이 얼마나 일치하는지를 탐색하고 외과의사의 디브리핑 기술을 향상할 선택지를 찾아낼 기회를 제공한다. 즉, 이 세대 안에서 일하는 코치는 주로 피코치가 해결하고자 하는 특정 문제에 초점을 맞출 것이다. 이러한 상황에서는 목표를 쉽게 정의할 수 있기 때문에 코치와 피코치의 관계는 대체로 중요하지 않을 수 있으며, 논의가 필요한 것은 그곳에 도달하는 가장 좋은 방법 정도일 수 있다.
    • 1세대를 채택하는 이점은 구체적이고 명확한 영향을 이끌어내기 쉽다는 것이다. 그러나 단점으로는 2세대와 3세대에 수반되는 관계적·가치 기반 역동(relational and value-based dynamics)의 중요성을 간과할 가능성이 있다. 다른 문제가 훌륭히 수행하고자 하는 외과의사의 바람을 분산시키는 경우, 코치의 평가에 동의하지 않는 경우, 또는 다루고 있는 문제가 인식되지 않은 더 깊은 문제의 피상적 증상인 경우에는 이러한 한계가 외과의사가 개선을 우선시하도록 동기를 부여받는 정도에 영향을 미칠 수 있다.
  • 반면, 외과의사가 교육 리더(educational leader)가 되고자 하는 바람에서 수련생 감독을 향상하려 한다면, 비슷한 상황에서 자신과 동료에게 잘 작동했던 것이 무엇인지, 그리고 감독 경험에서 언제 활력을 느꼈는지에 피코치의 주의를 이끄는 2세대 모형의 코칭이 도움이 될 수 있다.3
    • 즉, 이 세대 안에서 일하는 코치는 원하는 행동을 강화하는 긍정적 지표(positive markers)를 정확히 찾아내도록 도울 것이다. 그렇게 함으로써 외과의사가 교수자로서 자신의 고유한 강점을 찾아내고 증폭하여 그러한 행동을 더 일상적으로 만들도록 참여시킨다. 여기서는 코치와 피코치의 관계가 더 중요해진다. 코치의 역할에는 외과의사 교육자가 목표를 향한 고유한 경로를 밝힐 수 있도록 그들이 마주했던 성공과 도전을 탐색하면서 변화를 위해 노력하도록 고무하는 일이 일부 포함되기 때문이다. 더 나아가 변화의 초점은 수련생을 평가하는 능력을 향상시키는 것과 같은 더 구체적인 문제를 해결하기보다 피코치의 강점에 기반한다.
    • 이러한 형태의 코칭에서는 코치가 학습자를 감독하는 외과의사의 성공을 직접 수행하거나 그 질을 판단할 기술을 갖출 필요는 없지만, 외과의사가 유익한 정도의 성찰을 하도록 촉진하는 데 초점을 두어야 한다. 수행을 향상하는 ‘하나의 옳은 방법’이 있다고 보기보다, 다양한 형태의 강점이 피코치의 목표를 어떻게 산출할 수 있는지에 초점을 유지하면 유익할 수 있다. 그러나 단점으로는, 더 큰 그림의 목표를 향한 진전이 1세대 코칭에서 기대되는 정도만큼 쉽게 인식되지 않을 경우 피코치의 흥미와 인내를 잃을 위험이 있다.
  • 마지막으로, 낮은 교수평가 점수(poor teacher ratings)를 받았기 때문에 감독 기술 향상에 초점을 두는 외과의사는 3세대 모형을 활용하여 지원하는 코치가 합리적으로 필요할 수 있다.
    • 3세대는 피코치의 가치와 그것이 감독 기술 향상에 어떻게 정렬되는지를 끌어내는 더욱 전인적이고 통합적인 코칭 접근(holistic, integrative approach)을 우선시한다. 이 접근을 취하면 대화가 피코치에게 중요한 것으로 이동하여 낮은 평가점수로 인해 생긴 위협을 완화하고, 전문직 정체성 갈등(professional identity conflicts)이나 진료 제약에 대한 지각된 위험(perceived risk of practice constraints) 같은 개인적 장벽을 더 쉽게 극복하게 한다. 피코치에게 더 큰 의미와 가치를 지니는 수준의 대화를 이루기 위해, 코치는 강력한 관계적 토대(relational foundation)와 외과의사가 자신의 어려움을 편안히 논의할 수 있는 안전하고 신뢰할 수 있으며 개방적인 환경을 조성하는 데 상당한 노력을 기울여야 한다.
    • 따라서 이러한 코칭 세션에는 일반적으로 외과의사 피코치의 경험과 감정을 탐색하는 서사적 대화(narrative dialogue)가 포함되며, 자신의 우선순위와 가치에 부합하는 방식으로 행동을 변화시키기 위해 취할 수 있는 전략을 강조한다. 이러한 형태의 코칭이 주는 이점에는 피코치가 이전 접근의 한계를 더 깊이 이해하도록 돕는 것, 수행의 다른 측면으로 일반화(generalisation)할 수 있게 하는 것, 코치 및 동료와 더 큰 관계성을 형성하는 것이 포함되며, 이는 더 강한 소속감(sense of belonging)과 웰빙에 기여할 수 있다. 그러나 단점으로는, 신뢰감이 확립되지 않을 경우 심리적 장벽이나 ‘타자화(othering)’된다는 느낌을 만들어내어 피코치가 방어적 반응(defensive reactions)이나 피상적 해법을 극복하지 못할 위험이 있다.

요약하면, Armson 등이 ‘감독자에 의한 효과적인 코칭은 개인의 요구에 따라 선택되는 구체적인 과정 기술과 내용 기술의 조합을 필요로 한다’고 결론 내린 것은 적절하다.37 효과적인 코치는 각 코칭 세대가 언제 가장 잘 활용될 수 있는지를 인식하고, 자신의 접근을 조정하거나 상황에 더 잘 맞는 다른 사람에게 피코치를 의뢰할 수 있어야 한다. 이러한 적응성(adaptability)은 코칭이 포괄적으로 이루어져 즉각적인 수행 문제를 다루는 동시에, 필요와 기회에 따라 장기적 발달과 개인적 성장을 촉진할 가능성을 높인다. 이러한 측면들의 균형을 맞춤으로써 코치는 더 섬세하고 효과적인 지원을 제공할 수 있으며, 궁극적으로 자신이 지도하는 사람들에게 더 나은 결과를 가져올 수 있다.

7.2. 어떻게 실행할 것인가? (How to implement?) 

코칭 관계가 성공하도록 하려면 코칭 관계의 목표뿐 아니라 이를 달성하는 최선의 방법도 명료하게 표현하는 것이 중요하다. 모든 코칭 세대에 공통되는 것은 긍정적 변화, 즉 성장에 대한 초점이다. 따라서 사용되는 모형과 무관하게 코칭의 중심 원칙은 피코치가 ‘현재 있는 곳(where they are)’에 비추어 필요로 하는 것을 목표의 토대로 삼는 것이다. 코치가 행하는 것 가운데 코칭에 해당하는 모든 활동은 그 결과를 위해 이루어진다. 그럼에도 어느 세대 안에서 코칭하느냐에 따라 실행 방식에는 차이가 생긴다.

  • 변화가 특정 술기의 개발과 관련되어 있어 1세대가 가장 적합하다면, 코치는 전문성 부족이나 사각지대(blindspots)를 극복하기 어려운 본질적 특성으로 인해 피코치가 아직 갖지 못한 통찰을 제공할 수 있어야 한다. 숙련도 발달(proficiency development)을 지원하려면 코치는 피코치가 변화시키려는 행동에 관한 통찰을 지녀야 한다. 따라서 그러한 통찰을 얻는 과정에는 피코치의 술기 수행을 관찰하고 피드백 순환(feedback cycle)에 참여하는 일이 포함될 수 있다. 초점이 피코치의 전문직 레퍼토리(professional repertoire)에 포함될 것으로 기대되는 것에 맞춰져 있으므로, 코치와 피코치가 강한 관계를 형성하는지는 코칭의 성공에 미치는 영향이 크지 않을 가능성이 높다.
  • 피코치가 원하는 변화가 사고의 전환, 행동을 변화시키기 위한 정서적 반응의 관리, 또는 장기적인 경력목표의 추구와 관련되어 있어 2세대가 가장 적합하다면, 피코치에게 중심이 되는 질문은 ‘이 변화를 이루기 위해 나의 강점을 어떻게 활용할 수 있는가?’가 된다. 피코치는 여전히 어떤 방식으로든 향상하려는 동기를 갖고 있지만, 코칭의 초점은 술기 자체를 연습하는 데 있지 않다. 이는 피코치의 성장과 진전을 방해하는 장애물을 제거하고 강점을 찾아내는 데 관한 것이다. 전문직 발달을 지원하기 위해, 코치는 피코치가 표면적으로 드러나는 어려움과 실제로는 피코치를 더 근본적으로 가로막고 있을 수 있는 더 깊은 개념화(deeper conceptualisations)의 차이를 인식하도록 도와야 할 수 있다.
    • 앞선 사례에서 외과의사가 교육 리더가 되는 것을 가로막는 것은 교육자로서의 능력이 아니라 그러한 전환에 무엇이 필요한지에 대한 오해일 수 있다. 1세대와 비교하면 코치가 피코치가 일하는 영역에 숙련되어 있어야 할 필요는 더 적다. 그러나 코치는 피코치가 일반적으로 기능하는 문화 또는 전문직과 자신의 정렬을 정교화하도록 여전히 도울 필요가 있다. 즉, 피코치가 자신의 현실을 탐색하고 스스로 문제를 찾아 해결하도록 촉진하는 데 필요한 기술을 갖추어야 하며, 지속적인 노력을 강화하는 방식으로 진정성 있게 연결해야 한다.
    • 따라서 2세대 코칭은 문제가 덜 명시적이고 그에 따라 해법도 덜 분명하므로, 상황의 현실과 피코치를 앞으로 나아가게 할 선택지의 실행 가능성(viability)에 관하여 더 길고 깊은 대화를 필요로 할 가능성이 높다. 2세대에 더 잘 부합하는 초점에서는, 인간이 특정한 사고방식에 고착되는 경향 때문에 피코치 자신이 무엇에 가로막혀 있는지를 인식하기 어려울 수 있으며, 그 결과 대안적 해법을 볼 수 있는 역량을 저해하는 사각지대가 발생한다.
  • 피코치가 원하거나 수련생에게 요구되는 변화가 의미 만들기, 즉 가치 기반 과정(values-based process)을 반영한다면, 3세대 코칭이 더 유용할 수 있다. 이는 피코치가 미리 정해진 역할에 어떻게 맞출 것인가에서 벗어나, 일과 삶의 선택 전반에 관해 피코치에게 무엇이 중요한지를 성찰하도록 격려할 기회를 제공하기 때문이다.
    • 이 세대와 관련된 중심 질문은
      • ‘나의 가치와 우선순위는 무엇인가?’,
      • ‘나는 어떻게 그것들에 따라 살아갈 수 있는가?’,
      • ‘나는 어떻게 일에서 의미를 창조할 수 있는가?’,
      • ‘나에게 잘 살아낸 삶(well-lived life)이란 어떤 모습인가?’이다.
    • 이 세대에서 추구할 코칭 성과는 우선순위를 확립하는 것과 관련되므로, 특정 문제가 더 광범위한 문제를 나타내는 지표에 불과하다는 점을 인식해야 하는 경우가 흔하다. 낮은 수행의 징후가 그러한 성찰을 촉발하는 시작 사건인 경우가 흔하고 신뢰와 안전이 필수적이므로, 이때는 코치가 거리를 둔 관찰자(distant observer)인 것이 유익할 수 있다. 앞선 사례를 이어가면, 외과의사는 교육이 단순히 자신의 우선순위가 아니기 때문에 교육에 어려움을 겪는 것일 수 있다. 이러한 이유로 Stelter와 Law는 코치가 중립적일수록 피코치가 자신의 서사를 인식하고 다시 저술하도록 지원하는 데 더 효과적일 수 있다고 주장하면서, 코칭에 대한 서사적 접근을 제안한다.21

모든 형태의 코칭에서 신뢰(trust)는 필수적이다. 피코치는 코치에게 경쟁하는 이해관계(competing interests)나 편향이 아니라 자신의 최선의 이익을 중시하는 마음이 있다고 믿어야 하기 때문이다.38

  • 1세대와 2세대 코칭 목표에서는 원하는 변화가 전문직에 의해 설정되거나 피코치가 원한 것이기 때문에 코치와 피코치가 암묵적으로 정렬되어 있다.
  • 반면 3세대 코칭 목표는 흔히 피코치가 어떤 방식으로든 어려움을 겪고 있는 체계의 일부가 코치일 경우, 상당한 불정렬(misalignment) 위험을 만드는 상황에서 비롯된다.

코치가 피코치를 전적으로 지지하더라도, ‘체계 안에’ 있다는 사실 때문에 피코치는 위협감을 느끼는 상태에서 벗어나 자신의 가치와 정렬되는 더 깊은 문제를 탐색하고 앞으로 나아갈 길을 찾기가 불가능할 수 있다. Godskesen과 Kobayashi는 외부 코치(external coaches)가 성찰을 위한 공간을 마련하고, 피코치가 파급효과의 가능성 없이 의심을 드러내고 약점을 보이며 다른 상황에서는 민감할 수 있는 사안을 공유할 수 있게 한다고 주장한다.27


이 논의를 통해 분명해졌어야 하듯, 세 세대 사이에는 차이만큼이나 유사점도 많다. 그러나 수행해야 할 대화와 과정의 차이는 코치에게 상당한 수준의 기술과 유연성을 요구한다. 코칭을 단일한 구성개념으로 취급하고 코칭이 언제, 왜, 어떻게 이루어지는지에 의도적으로 주의를 기울이지 않으면 이러한 필요성을 쉽게 간과할 수 있다. 더 나아가 피코치가 처음 코칭을 찾는 이유는 궁극적으로 형성되는 목표와 다를 수 있으므로, 특정 접근에 영구히 고착되어서는 안 된다. 대부분의 경우 개인은 무언가가 변화하기를 원하기 때문에 코칭을 선택한다. 그 변화가 무엇인지, 또는 그것을 가능하게 하기 위해 자신이 무엇을 다르게 해야 하는지 인식하는 과정은 코칭 과정의 일부다. 따라서 상황의 실체가 점점 더 명확해짐에 따라 코칭 자체도 민첩성을 유지하고 적응해야 한다. 마찬가지로 코칭 개입을 포함하는 HPE 연구 프로젝트는 조사와 원하는 성과를 정렬하고, 실증적 노력을 통해 더 섬세한 이해를 지속적으로 구축할 수 있도록 어떤 유형의 코칭을 사용하는지 의도적으로 명시해야 한다.


보건의료전문직교육을 위한 연구 의제(research agenda)에 추가적인 지침을 제공하기 위해, 이 논문에 내재한 한계도 언급하고자 한다. 이 프레임워크는 주로 비즈니스와 심리학 문헌에서 도출되었으므로 보건의료전문직교육에의 적용은 해석적(interpretive)이다. 예시를 제시하기는 했지만, 이 분류체계를 실천에 옮길 수 있는 수단에 대해서는 추가적인 체계적 연구가 필요하다. 더 나아가 자기조절학습이론(self-regulated learning theory),39 적응적 전문성(adaptive expertise),40 전문직 정체성 형성(professional identity formation)41과 같이 고려할 가치가 있는 이론적 토대가 더 많이 있으나, 이는 이 논문의 범위를 벗어난다.

8. 결론 (CONCLUSION) 

이 분야 횡단의 최전선 논문에서 우리는 코칭에 관한 사고가 어떻게 진화해 왔는지를 개관했다. 이를 통해 세 세대의 코칭 모두 보건의료전문직교육에서 각각의 자리가 있다고 주장한다. 그러나 서로 다른 목적, 논리, 패러다임에 관한 인식은 보건의료전문직교육의 학자와 교육자가 코칭을 활용하거나 연구하고자 할 때 유용할 수 있다. 지구적(planetary), 기술적, 사회적 변화가 실무의 복잡성과 기대를 증가시키기 시작하고, 그에 따라 코칭의 초점과 예상되는 영향이 더 다양해지는 지금, 이러한 고려를 우리의 사고에 포함하는 것이 특히 중요하다.42


Med Educ. 2026 Jun 21. doi: 10.1111/medu.70252. Online ahead of print.

With great power comes great responsibility: How narrow conceptions of validity in high-stakes testing undermine competence 


들어가며

Kelley가 타당도(validity)에 대해 쓴 지 100년이 됐습니다. Medical Education이 "교육적 타당도를 다시 생각하자(rethink educational validity)"는 기획을 진행하고 있는데, 그 일환으로 Kevin Eva와 Beth-Ann Cummings가 고부담 평가(high-stakes assessment)를 정면으로 다룬 State of the Science 논문을 냈습니다.


타이밍이 절묘합니다. 최근 몇 년 사이 미국과 캐나다는 사회적 압력에 밀려 고부담 시험을 줄였고, 영국은 반대로 국가 의사면허시험(Medical Licensing Assessment)을 새로 도입했거든요. 같은 시기에 정반대 방향으로 움직인 겁니다. 뭐가 맞는 걸까요?


저자들이 던지는 질문은 이겁니다. "고부담 평가는 어떤 형태여야 하는가?"가 아니라 "오늘날의 고부담 의사결정을 정당화하려면 어떤 타당도 논증(validity argument)이 필요한가?"


이 전환이 이 논문의 전부라고 해도 과언이 아닙니다.

논문의 핵심 주장은 초록에 압축돼 있습니다.

역량을 보증하려고 내리는 고부담 의사결정이, 역설적이지만 충분히 예측 가능한 방식으로 오히려 역량을 위협할 수 있다. "High-stakes decisions intended to assure competence can paradoxically, yet predictably, threaten competence"


⚖️ 먼저, 찬반 정리부터

저자들은 논쟁의 출발점을 공평하게 깔아둡니다.

  • 찬성 쪽 논리는 이렇습니다. 아무리 좋은 교육 프로그램도 100% 성공률을 보장할 수 없습니다. 게다가 '낙제시키지 못하는 문제(failure to fail)'는 구조적으로 발생합니다. 교내 평가의 사각지대, 졸업률이 프로그램 성과지표가 되면서 생기는 정치적·평판 압력, 실제로 조치를 취하려 할 때 부딪히는 행정적·법적 부담 때문이죠. 그래서 훈련기관과 거리를 둔(arm's length) 외부 기관의 심리측정학적으로 엄밀한 평가가 필요하다는 겁니다. 여기에 더해 고부담 시험은 촉매(catalytic function) 역할도 합니다. 학습자와 교육과정 책임자를 유도하고, 기관이 자체 평가체계를 갖추도록 압박하는 기능이요.
  • 반대 쪽 논리도 만만치 않습니다. 비용과 기회비용이 크고, 무엇보다 강력한 유도효과(steering effect)로 학습자의 관심을 장기적 숙련에서 멀어지게 만듭니다. 더 근본적인 문제는 고부담 평가가 거의 항상 '특정 시점 평가(point-in-time)'라는 점입니다. 그런데 보건의료 전문직에게 필요한 건 적응적 전문성(adaptive expertise)이고, 이건 맥락 의존적이고 계속 변하는 학습 과정이지 어느 시점에 "완료(signed off)"라고 도장 찍을 수 있는 고정된 상태가 아닙니다.

여기서 저자들이 던지는 뼈아픈 지적 하나. 규제기관들이 확인해 온 바에 따르면, 실제 진료 현장에서 문제가 드러날 때 두드러지는 건 소통 능력, 전문직업성, 협업입니다. 그런데 고부담 시험은 측정의 제약 때문에 대부분 지식(medical expert 영역)에 머물러 있죠. 수십 년간 이 '품질 보증' 체계가 문지기 역할을 해왔는데도 면허를 가진 의사에 의한 위해 보고는 계속됩니다. 저자들은 이것만으로도 전통적 고부담 시험 모델이 환자안전을 보호한다고 주장할 근거가 없다고 봅니다.


🔍 세 가지 신화 (three myths)

논문의 백미입니다. 저자들은 세 개의 신화를 제시하는데, 소제목을 보면 문장이 거의 똑같습니다. 한 단어씩만 바뀌어요.

  • Myth 1: 평가가 총괄인지 형성인지 반드시 결정해야(must) 한다
  • Myth 2: 평가가 총괄인지 형성인지 결정하는 게 맞다(should)
  • Myth 3: 평가가 총괄인지 형성인지 결정할 수 있다(can)

이게 오타가 아니라 의도된 수사(rhetoric)입니다. 같은 이분법을 설계 원칙, 역할 인식, 실현 가능성이라는 세 층위에서 각각 해체하는 구조거든요.

Myth 1 — "반드시 결정해야 한다" 

  • 대부분의 평가 워크숍에서 제일 먼저 가르치는 게 "설계 단계에서 총괄(summative)인지 형성(formative)인지 정하라"입니다. 총괄이면 심리측정학적 엄밀성에 집중하고 피드백은 신경 안 써도 되고, 형성이면 그 반대라는 거죠.
  • 저자들은 이 이분법의 수사가 근본적으로 결함이 있다고 봅니다.
    • 형성평가를 "덜 엄밀해도 되는 것"으로 규정하면, 학습자에게 신뢰하기 어려운 정보로 학습을 이끌라는 말이 됩니다.
    • 반대로 총괄평가를 "교육은 우선순위가 아닌 것"으로 규정하면, 단기 수행을 장기 숙련보다 앞세워 결국 역량 자체를 갉아먹습니다.
  • 재밌는 건 용어는 이미 바뀌었다는 점입니다. 요즘은 총괄/형성 대신 고부담/저부담(high vs low stakes), 질 보증/질 개선(quality assurance vs quality improvement)으로 말하죠. 그런데 행동은 안 바뀌었습니다. 저부담=형성, 고부담=총괄로 그대로 치환해서 쓰고 있을 뿐이거든요. 저자들이 보기에 문제는 용어가 아니라, 이 인위적 이분법이 타당도 논증의 폭 전체를 책임지지 않아도 되게끔 면죄부를 준다는 데 있습니다.

Myth 2 — "결정하는 게 맞다"

  • 고부담 총괄평가에서 형성적 측면을 챙기지 않는 걸 정당화할 때 흔히 나오는 말이 "그건 우리 역할이 아니다(that is not our role)"입니다.
  • 하지만 이렇게 선을 긋는 순간, 고부담 시험이 학습자의 교육 궤적(educational trajectory)에서 뚝 떨어져 나옵니다. 부담이 크면 학생들이 임상실습을 빠지고 필기시험을 준비하는 건 필연이죠. 그렇다면 시험 전 학습 노력이 진짜 진료를 지지하는 행동을 강화하도록 설계돼야 하고, 시험 후에도 피드백과 후속조치가 있어야 합니다. 아무것도 없다면, 간신히 통과한 사람이 그 경험을 다음 성장에 쓸 가능성이 얼마나 될까요?
  • 저자들의 지적이 서늘합니다. 순수 문지기 기능만 하는 시험에서는 컷오프를 간신히 넘긴 사람이 수십 년의 진료 인생으로 들어갑니다. 별다른 평가도 없이요. 그리고 그 사람은, 아주 근소한 차이로 떨어져서 진료에서 배제된 사람보다 오히려 환자에게 더 큰 위험이 됩니다.

Myth 3 — "결정할 수 있다"

  • 가장 근본적인 신화입니다. 저자들은 평가 도구가 자기 정체성을 스스로 정하지 못한다고 말합니다. 결정하는 건 설계자의 의도도, 도구 자체도 아니고 수험자의 해석이에요.
    • '총괄'이라고 이름 붙인 시험은 늘 형성적입니다. 무엇을 공부할지, 무엇을 기억할지, 시험 후 무엇을 더 배울지를 실제로 결정하니까요.
    • '형성'이라고 이름 붙인 평가는 늘 총괄적입니다. 피드백이 정체성을 위협하는 순간 학습자는 '판단받았다'고 느끼거든요.
  • 가장 좋은 예가 역량위원회(competency committee)입니다. 형성평가라고 해놓고 그 자료를 모아서 고부담 결정에 씁니다. 진급이 걸려 있는데 전공의가 관찰받을 순간을 '체리피킹'하는 게 이상한 일인가요? 교육자가 "이건 학습을 위한 평가(assessment-for-learning)야"라고 아무리 말해도, 평소 하던 대로가 아니라 기대되는 모습을 '연기'하는 게 놀라운 일인가요?

💡 그래서 무엇이 문제인가

이 신화들의 진짜 해악은 역량이 무엇인지를 왜곡한다는 데 있습니다.

  • 역량(competence)은 맥락 의존적 과정이지, 정적이고 보편적으로 부여할 수 있는 특질(trait)이 아닙니다. 기억은 흐려지고, 새로 배울 것은 계속 생기고, 사회적·물리적 조건이 수행을 크게 흔듭니다. 그런데 특정 시점 시험에 크게 의존하는 고부담 결정은 그 순간 '측정 가능한 것'으로 초점을 좁혀버리고, 결국 역량을 영원한 것처럼 암시함으로써 역량바탕교육의 취지 자체를 무너뜨립니다.
  • 논문에서 가장 아이러니한 대목이 여기입니다. 고부담 시험 옹호론의 논리는 "역량바탕교육이 아직 성숙하지 않았으니(즉, 교육기관의 판단만으로는 못 믿으니) 외부 시험이 필요하다"는 거죠. 그런데 그 고부담 시험이 계속 특정 시점 시험에 머무는 한, 정작 역량을 만들어내는 장기적 학습 행동과 습관과 기회로부터 노력을 딴 데로 돌려버립니다. 순환이죠.

🛤️ 그럼 어떻게 해야 하나: 세 가지 확장

저자들은 맥락 차이 때문에 구체적 처방은 못 하겠다고 하면서, 대신 고부담 평가 권한을 가진 모든 기관에 보편적으로 해당하는 세 가지 확장을 제안합니다.

1. 초점의 확장 (broadening focus)

  • 지식 기반의, 개인 단위의, 특정 시점 시험이 수행하는 문지기 기능은 현대 진료의 현실(복잡하고, 팀 기반이고, 사회적으로 배태되고, 계속 변하는)과 점점 어긋납니다. 유해사건은 주로 인계 실패, 소통 실패, 전문직업성 문제에서 비롯되는데 왜 필기 지식시험으로 고부담 결정을 내리냐는 거죠. 이건 심리측정학적 엄밀성을 부정하는 것도, 고부담 평가를 교육기관에 떠넘기자는 것도 아닙니다. 프로그램적 평가(programmatic assessment)의 다면적·다맥락적·누적적 속성을 고부담 맥락으로 번역해내자는 요구입니다.
  • 저자들의 마지막 반문이 인상적입니다. 모든 보건의료 전문직에게 효과적 협업과 불확실성 속 판단을 요구한다면, 그들의 역량을 판정하는 쪽에는 왜 그보다 낮은 기준을 적용하느냐고요.

2. 시간축의 확장 (broadening timelines)

  • 시험 '전'의 자료를 끌어오는 게 1번이라면, 2번은 시험 '후'를 챙기는 겁니다.
  • 핵심은 고부담 평가 자료를 개별 학습계획(learning plan)에 통합해서 훈련-진료 연속체를 가로지르게 만드는 것입니다. 지금 학습계획은 필기시험, 일터기반평가(WBA), 다면평가 같은 자료를 종합하는데, 정작 고부담 시험 자료는 거의 안 들어갑니다. 자원 낭비죠.
  • 그리고 이 지점이 중요합니다. 변화하는 지식과 기술, 사회적 기대 속에서 수십 년에 걸쳐 역량을 유지하는 일은 몇 년의 공식 교육으로 역량을 획득하는 일보다 훨씬 어렵습니다. 그렇다면 고부담 평가가 학습의 연속성을 얼마나 가능하게 하는지가 모든 시험 주관기관의 타당도 논증에 필수 요소가 돼야 한다는 겁니다. "그건 우리 소관 밖"이라고 넘길 일이 아니고요.

3. 방어가능성 개념의 확장 (broadening defensibility)

  • 가장 실용적인 제안이라고 봅니다. 저자들은 북미 의료법 체계에서 힌트를 가져옵니다. 의료법은 의사의 판단이 항상 '정답'일 것을 요구하지 않습니다. 합리적인 의사(reasonable physician)라면 같은 행동을 했을 것인가, 즉 방어 가능한가를 물을 뿐이죠.
  • 이 논리를 평가에 적용하면 질문이 바뀝니다.
    • (기존) 두 개의 증거원이 같은 답을 주는가?
    • (제안) 합리적인 판단자라면 이 증거가 개인의 역량에 관한 결론을 지지하기에 충분하다고 볼 것인가?
  • 이렇게 보면 일터기반평가는 지도전문의마다 판단이 갈려도 됩니다. 신뢰할 만한 방식으로 선정된 다양한 사례, 다양한 관점, 기대되는 역량의 폭 위에 세워졌다는 걸 보일 수 있고, 결정이 옳았는지 계속 모니터링하는 노력에 연결돼 있다면 충분히 합리적 근거가 될 수 있다는 겁니다. 고부담 결정의 순간에도 판단은 절대적이거나 최종적일 필요가 없고, 그 시점에 파악된 것에 대한 조건부 표상이면 됩니다.
  • 신뢰도 낮은 시험은 타당하지 않다고들 하죠. 저자들은 진정성(authenticity)을 배제한 신뢰도 역시 그에 못지않은 타당도 위협이라고 말합니다.

🧭 마무리하며

저자들은 이게 van der Vleuten의 효용성 모형(utility model)이 말하는 '타협'의 문제가 아니라고 선을 긋습니다. 실현가능성과 타당도가 충돌할 때 비용-편익을 따지는 건 당연하지만, 지금 걸려 있는 건 타협을 너무 쉽게 받아들이고 타당도를 너무 좁게 봄으로써 효용성의 교육적 영향(educational impact) 요소 자체를 훼손하는 일이라는 거죠.


그리고 McLuhan을 소환합니다. 매체가 곧 메시지라고요. 고부담 평가 프로토콜을 어떻게 설계하는지, 어떤 증거를 고부담 결정에 반영하는지가 그 자체로 "무엇이 중요하고 보건의료 제공자에게 무엇이 기대되는가"를 커리어 전체에 걸쳐 전달합니다. 그러니 평가가 질을 개선하는지 고려하지 않은 채로 질을 보증한다고 주장할 수는 없다는 결론입니다.


🇰🇷 한국 맥락에서 생각해 볼 지점

읽으면서 계속 겹쳐 보이는 장면들이 있었습니다.

  • 의사국가시험.
    • 실기시험 도입은 초점의 확장에 해당하는 진전이었죠. 그런데 시험 후 수험자에게 어떤 정보가 어떻게 전달되고, 그게 인턴·전공의 시기 학습으로 이어지는가 하는 시간축의 확장은 거의 논의되지 않았습니다. 저자들의 기준으로 보면 여기가 타당도 논증의 빈칸입니다.
  • 전공의 수련 평가.
    • WBA 서식을 만들고 보급하는 국면에서 가장 자주 받는 질문이 "이건 형성평가인가요, 총괄평가인가요"입니다. Myth 3의 답이 명쾌합니다. 그건 서식이 정하는 게 아니라 전공의가 해석하는 것이고, 진급에 반영되는 순간 형성평가로 남을 수 없습니다. 그렇다면 "형성평가니까 부담 갖지 마세요"라는 안내보다, 판단이 어떻게 누적되고 어떻게 방어 가능해지는지를 투명하게 설계하는 편이 정직합니다.
  • 역량바탕 수련 전환.
    • 저자들이 제안한 방어가능성 기준은 우리에게 특히 쓸모가 있습니다. 지도전문의 간 평정 불일치를 신뢰도 문제로만 접근하면 결국 체크리스트로 회귀하게 되는데, "합리적 판단자가 보기에 충분한가"로 질문을 바꾸면 사례의 다양성, 관찰자의 다양성, 역량 영역의 포괄성이라는 다른 설계 지렛대가 열리거든요.

1 | 서론 (Introduction) 
보건의료전문직교육(health professions education, HPE)은 광범위한 학문 분야의 이론과 근거를 받아들이는 경향이 있으므로,1 응용 학문 분야인 우리가 평가(assessment)만큼 세상에 많은 것을 되돌려준 영역은 드물다. 주요 진전에는

  • 지식 그 자체를 넘어 지식의 활용을 살펴보는 것의 가치 강조(Miller의 피라미드[Miller's pyramid]2 참조),
  • 초점을 두는 역량의 확장(각자가 선호하는 역량 프레임워크[competency framework] 참조), 그리고
  • 학습에 대한 평가(assessment-of-learning)와 학습을 위한 평가(assessment-for-learning)의 구분에 대한 인식이 포함된다.3

이러한 노력을 통해 보건의료전문직 학습자와 실무자의 평가에 관여하는 이들은 수많은 실제적 혁신뿐 아니라 보건의료에 관한 사고에도 기여해 왔다. 가장 최근에는 이 분야가 평가를 하나의 시스템으로 바라봄으로써 여러 교육적 난제를 극복하려는 노력에 몰두해 왔다.4 널리 알려진 프로그램형 평가(programmatic assessment) 모형에서 이러한 움직임은 주로, 고부담 의사결정이 필요하고 정당화될 때까지 기관 내부 평가(intramural assessment)에 내재한 부담(stakes)을 낮추는 방식으로 나타났다. 여기서 우리는 그 동전의 다른 면, 즉 고부담 목적을 위해 의도적으로 설계된 시험이 역량바탕교육의 더 넓은 목표와 양립할 수 있는지, 그리고 어떻게 그렇게 만들 수 있는지를 성찰한다. 우리는 ‘고부담(high-stakes)’을 실무 수행 준비도(readiness for practice) 또는 허용되는 실무 범위(permitted scope of practice)(예: 면허 또는 인증)에 관한 의사결정을 내리기 위해 평가가 시행되는 순간으로 정의한다.


달리 말해, 이 글은 Kelley의 이 주제에 관한 선구적 연구5 100년 후 Medical Education이 추진하는 ‘교육적 타당도의 재고(rethink educational validity)’의 일환으로, 고부담 시험을 더 넓은 교육 시스템에 최적으로 통합하기 위한 조건을 성찰하지 않은 채 고부담 시험의 타당도 논증을 제시하는 것이 충분한지, 역효과를 낳는지, 심지어 합리적인지를 근본적으로 묻는다.6 우리가 가장 중요하게 다루는 핵심 질문은 ‘고부담 평가는 어떤 형태여야 하는가?’가 아니라 ‘방어 가능한 현대의 고부담 의사결정(defensible contemporary high-stakes decisions)을 뒷받침해야 하는 타당도 논증은 무엇인가?’이다. 달리 말하면,

  • 고부담 평가는 어떤 비용을 치르고 어떤 이익을 얻기 위해 시행되는가?
  • 고부담 시험에 찬성하거나 반대하는 근거는 비판적 검토를 얼마나 잘 견뎌내는가?
  • 그리고 훈련, 실무 및 더 넓게는 세계가 빠르게 변화하는 현대의 현실에 평가를 가장 잘 부합시키려면 무엇을 바꾸어야 하는가?

이러한 문제를 본격적으로 다루기 전에, 고부담 시험에 찬성하거나 반대할 때 흔히 제시되는 입장을 간략히 되짚어본다. 이 근거들은 고부담 시험이 ‘목적에 적합한지(fit for purpose)’, 그리고 어떻게 목적에 적합할 수 있는지에 관한 모든 논의의 토대이며, 따라서 모든 타당도 논증의 기초를 이룬다.

1.1 | 고부담 시험을 지지하는 논거 (The case for high-stakes testing) 
  • HPE 프로그램은 개인과 지역사회의 요구를 충족하는 안전하고 질 높으며 근거에 기반한 보건의료를 제공할 수 있는 실무자를 육성하기 위해 존재한다. 견고한 교육 프로그램과 개별 학습자 지원을 개발하고 실행하는 데 막대한 에너지, 비용, 시간 및 인적 자원이 투입된다. 그러나 어떤 프로그램도 성공률 100%를 기대해서는 안 된다. 달리 말해, 조직의 역량과 의지만으로 모든 개인의 성공을 보장할 수는 없다. 더 나아가, 기관 내부 평가 절차의 약점이나 사각지대, 졸업률을 프로그램 성과 지표로 취급함으로써 발생하는 정치적 또는 평판상의 압력, 그리고 훈련생이 정해진 기준을 충족할 수 없음이 드러났을 때 조치를 취하는 데 따르는 행정적·법적 어려움 등 여러 이유로 ‘낙제시켜야 할 사람을 낙제시키지 못하는 현상(failure to fail)’이 생길 수 있다.7–9 이로부터 외부 기관(예: 의사회, 국가시험위원회 또는 실무 규제기관)이 시행하거나 감독하는 고부담 시험을 옹호할 때 통상적으로 사용하는 근본적 가치 명제가 도출된다. 즉, 인증을 받았는지 여부와 관계없이 질 높은 훈련 프로그램은 필요하지만 충분하지 않다. 질 높은 보건의료와 환자안전을 보장하려면 훈련 프로그램과 일정한 거리를 둔 상태에서 심리측정학적으로 엄밀한 평가(psychometrically rigorous assessment)를 실시해야 한다.10 질 보장을 위해 외부 기관이 문지기 역할(gatekeeping)을 수행하는 것의 가치는, 훈련 프로그램이 역량에 대한 우려가 남아 있는 훈련생을 졸업시켰다고 인정할 때마다 일화적으로 뒷받침되며, 고부담 평가와 임상진료의 질 지표 사이의 연관성을 보고한 다수 연구를 통해 경험적으로도 뒷받침된다.11–13
  • 문지기 역할을 넘어 고부담 평가는 촉매 기능(catalytic function)을 수행한다. 즉, 훈련생과 교육과정 책임자를 이끌고 평가 혁신을 촉진하는 영향 요인(influencer)14,15이자, 훈련 프로그램이 자체 평가 실무를 실행·강화·지속하도록 지원하는 동시에 그렇게 해야 할 당위성을 만들어내는 촉진자(enabler)16로 작용한다. 다시 말해, 전문직이 주도하는 시험 전략(professionally guided testing strategies)은 보건의료전문직 규제와 인증이라는 본래 목적을 넘어 부가가치를 제공한다. 또한 개인의 학습 방향을 유도하고 프로그램 개발의 필요를 드러냄으로써 교육과 보건의료 제공의 질 향상을 촉진한다.

1.2 | 고부담 시험에 반대하는 논거 (The case against high-stakes testing) 
  • 구체적인 양상은 맥락마다 다르지만, 고부담 평가는 훈련생, 훈련 프로그램 및 보건의료체계에 상당한 재정적 비용과 기회비용을 초래한다.17–19 시험 준비, 시험장 이동 및 평가 응시에 시간과 자원이 필요하다. 더욱이 강력한 유도 효과(steering effects)를 통해 임상실무에 필요한 장기적 숙달(long-term mastery)로부터 주의를 돌린다. 이러한 비용이 개인과 집단에 미치는 영향은 그 노력이 앞 절에서 제시한 가치 명제를 충족하는 범위 안에서만 정당화될 수 있다. 그러나 그곳에서 제시된 전제를 받아들인다 하더라도, 실무·훈련·평가의 진화는 기존 고부담 평가 절차의 가치를 약화시키는 문제들을 드러냈다.
  • 앞 절의 논거가 요구하는 심리측정학적·물류적 조건으로 인해 고부담 평가는 거의 언제나 ‘특정 시점(point-in-time)’의 평가로 시행된다. 그러나 보건의료전문가는 적응적 전문성(adaptive expertise)20을 필요로 한다. 이는 지식의 성장과 기술 개발에 지속적으로 투자해야 하는 맥락 의존적이고 역동적인 학습 과정이며,13,21 특정 순간에 달성했다고 의미 있게 ‘승인(sign off)’할 수 있는 고정된 상태가 아니고, 하물며 영구히 달성되는 상태는 더더욱 아니다.22,23 또한 규제기관은 보건의료전문직 실무에서 문제가 확인될 때 의사소통 기술, 전문직업적 행동 및 협업의 문제가 특히 두드러진다는 점을 이해하게 되었다.24–26 그러나 서서히 변화하는 표준화 고부담 시험의 세계에서 흔히 그러하듯, 엄밀성(rigour)을 ‘객관적(objective)’이고27,28 수량화 가능하며 엄격히 통제된 것과 동의어로 취급하고 타당도에 관한 판단을 심리측정학적 속성만으로 내릴 때, 이러한 복잡한 영역의 평가는 제약을 받는다. 평가가 Bloom 분류학(Bloom's taxonomy)의 상위 수준을 목표로 하더라도, 측정의 제약 때문에 고부담 시험은 다른 핵심적인 의사 활동을 배제한 채 대체로 지식(즉, ‘의학전문가[medical expert]’ 내용)을 반영한다.29 안타깝게도 이러한 ‘질 보장(quality assurance)’ 시스템이 수십 년 동안 문지기 역할에 사용되었음에도, 정식 면허를 보유한 저성과 실무자가 유발한 피해에 관한 보고는 계속되고 있다.30,31 이 사실만으로도 전통적인 고부담 시험 개발 모형이 환자안전을 보호한다고 주장할 정당한 근거가 없음을 알 수 있다. 고부담 의사결정을 내릴 때 고부담 평가를 다른 평가 방법에 보완적으로 추가해야 한다고 말하는 것만으로는 충분하지 않다. 고부담 평가가 행사하는 힘은 필연적으로 학습자와 실무자의 우선순위를 규정하기 때문이다.

2 | 논쟁의 재구성 (Reframing the Debate) 

제1절의 논거가 얼마나 설득력 있다고 생각하는지와 관계없이, 앞서 제시한 논쟁은 고부담 시험이 타당성을 가진다고 주장하려면 어떤 기준을 충족해야 하는지를 규정하는 데 핵심적이다.32 이 논쟁은 수십 년 동안 보건의료체계 안팎에서 양극화를 일으켜 왔는데, 이는 충분히 이해할 만하다.33 그 원인 중 하나는 잘못된 질문을 던져왔다는 데 있다. 우리 분야는 고부담 평가가 가치를 더하는지, 또는 해를 끼치는지를 물어서는 안 된다. 그런 질문에 대한 답은 간단하다. ‘그렇다. 둘 다 한다.’ 그보다 우리는 고부담 평가가 더 이상 ‘국가면허시험’, ‘인증시험’ 또는 이와 유사한 특정 시점의 표준화 평가와 동의어로 (오해)되지 않도록 어떻게 재정의할 것인지를 논의해야 한다. 그 방향으로 계속 나아가기 위해, 이 절에서는 특정 실행의 타당성에 관한 논의에 의학교육이 효과적으로 참여하는 것을 방해할 수 있는, 고부담 시험에 관한 잘못되었지만 널리 퍼진 믿음인 세 가지 통념을 자세히 다룬다. 분명히 하자면, 뒤이어 제시할 통념이 보편적으로 받아들여진다고 보지는 않는다. 실제로 이 통념들은 수십 년간 논쟁의 대상이 되어 왔고,34,35 지속 불가능하다는 점도 점점 널리 인정되고 있다.36 오히려 우리는 이 통념을 통해 평가의 형성적 역할과 총괄적 역할 사이에 존재하는 핵심적인 이분법을 드러내고자 한다. 이 이분법은 여전히 실무에 영향을 미치며, 고부담 평가를 시행할 권한을 가진 이들이 자신의 도구가 지속적인 전문직 발달에 능동적으로 기여하도록 보장할 책임까지 함께 지지 않을 때 생기는 위험을 부각한다. 결국 타당도는 시험점수의 진실성(veracity)을 반영하는 것 이상이며, 결과(consequences)를 고려해야 하는 사회적 책무(social imperative)이다.37,38

2.1 | 통념 1: 평가는 총괄평가이거나 형성평가이거나 둘 중 하나로 반드시 결정해야 한다
(Myth 1: One must decide whether an assessment is either summative or formative)
 

  • 대부분의 평가 워크숍, 강좌 또는 훈련 프로그램에서 가장 먼저 가르치는 것은 평가 설계를 시작할 때 목적을 총괄평가(summative assessment) 또는 형성평가(formative assessment)로 규정하는 일이 매우 중요하다는 것이다.
    • 전자를 우선시할 때는 엄격한 심리측정학적 기준에 세심한 주의를 기울여야 하지만, 수행 향상을 위해 학습자에게 정보를 능동적으로 되돌려주는 일은 걱정하지 않아도 된다는 논리가 뒤따른다.
    • 후자를 우선시하면 그 반대가 성립한다. 신뢰성(credibility)은 학습자의 신뢰를 형성하는 핵심 요인이지만,39,40 시험점수 그 자체는 심리측정학적 질과 관계없이 학습을 이끌지 못하는 경향이 있다.41
  • 이분법화(dichotomisation)는 복잡한 난제를 단순화할 수 있지만, 그것이 조장하는 수사는 근본적으로 잘못되었다.42
    • 형성적 목적으로 시행되는 평가를 덜 엄밀한 것으로 틀 짓는 것은 학습자와 학습이 신뢰하기 어려울 수 있는 정보의 지도를 받아야 한다는 의미가 된다.
    • 반대로 역량 보장을 위해 시행되는 평가가 교육을 우선시하지 않는 것으로 틀 짓는 것은 장기적 숙달보다 단기적 수행을 조장하여 역량을 약화시킨다.
  • 이러한 이분법을 극복하려는 노력은, 이제 이 분야가 특정 평가에 수반되는 부담(높음 대 낮음)이나 그 활동이 사용되는 목적(질 보장 대 질 향상)을 더 자주 언급하는 데서 나타난다.43 안타깝게도 행동의 변화는 뒤처져서, ‘저부담(low-stakes)’과 ‘질 향상(quality improvement)’은 대체로 ‘형성적(formative)’과 동의어처럼 취급되고 ‘고부담’과 ‘질 보장’은 ‘총괄적(summative)’과 혼동되고 있다.38 따라서 근본적인 문제는 용어 자체가 아니라, 이러한 인위적 이분법화가 교육적 결과(pedagogical consequences)를 포함한 타당도 논증의 전체 범위에 주의를 기울여야 할 책임을 회피하는 일을 정당화한다는 데 있다.38,44

2.2 | 통념 2: 평가는 총괄평가이거나 형성평가이거나 둘 중 하나로 결정하는 것이 낫다
(Myth 2: One should decide whether an assessment is either summative or formative)
 

  • 주목할 만한 예외가 존재하지만,45 고부담 총괄시험 과정의 형성적 측면에 관심을 기울이지 않는 것은 흔히 ‘그것은 우리의 역할이 아니다’라는 취지의 주장으로 정당화된다. 역사적으로 이해할 수 있고 예측 가능한 일이지만, 이러한 경계 설정은 고부담 시험의 순간을 피평가자의 교육 궤적 연속선(continuum of assessees' educational trajectories)에서 분리함으로써 보건의료체계에서 일하는 이들의 역량을 시험이 보장할 수 있는 능력을 위협한다. 예를 들어, 부담이 크다면 학습자가 필기시험을 공부하기 위해 임상실습을 쉬는 일46은 피할 수 없지만, 그러한 행동은 실제 세계에서 학습자에게 기대되는 것과 시험이 부과하는 요구를 통합해야 할 필요를 낳는다.47,48 평가 전의 학습 노력은 진정성 있는 실무(authentic practice)를 뒷받침하는 형성적 행동을 강화해야 한다. 평가 후 아무런 피드백이나 후속 조치가 없다면, 간신히 기준을 넘었거나 자신의 잠재력보다 낮게 수행한 사람들이 그 경험을 향후 전문직 발달을 이끄는 데 활용할 가능성이 얼마나 되겠는가?39
  • 단 하나의 절단점수(cut score)를 넘었는지 여부만으로 평가의 모든 결과를 결정하고 다음에 무엇을 해야 할지는 전혀 고려하지 않는, 순전히 총괄적인 접근은 목표가 지속적으로 더 나은 보건의료인이 되고 더 잘 실천하려는 장기 여정이 아니라 특정 시점의 측정임을 알리는 신호가 된다.49 따라서 고부담 시험이 총괄적인 문지기 기능만 가진 것으로 제시될 때, 간신히 합격한 사람들은 공식적 평가를 거의 또는 전혀 받지 않은 채 수십 년에 걸친 실무로 진입하며, 능력이 아주 조금 부족해 실무에서 배제된 사람들보다 오히려 환자에게 위해를 가할 위험이 더 커진다. 여러 고부담 시험 노력의 근시안성을 살펴보면, 고부담 평가의 형성적 잠재력을 활용하지 않는 것은 실무자 역량을 추구하는 과정에서 놓친 중대한 기회일 뿐 아니라 보건의료체계 전체에 해가 됨을 알 수 있다. 고부담 목적에 신뢰할 수 있는 자료를 생성하는 데 필요한 과정의 강도가 표준화된 특정 시점 측정을 요구하며 그 형성적 영향을 무시하는 일을 정당화한다는 주장은, 보건의료 실무의 질을 보장한다고 동시에 주장하는 것과 양립할 수 없다.50

2.3 | 통념 3: 평가가 총괄적인지 형성적인지 결정할 수 있다
(Myth 3: One can decide whether an assessment is either summative or formative)
 

  • 교육계가 개인이 의도적이든 그렇지 않든, 더 나은 방향으로든 더 나쁜 방향으로든 자신의 학습에서 수행하는 능동적 역할을 더 잘 이해하게 되면서, ‘평가 도구는 자신이 무엇이 되어야 하는지 알지 못한다(assessment tools do not know what they are supposed to be)’는 명제는 더욱 심오한 의미를 갖게 되었다. 행동과 경험을 좌우하는 것은 평가나 설계자의 의도가 아니라 피평가자가 자신에게 놓인 과제를 해석하는 방식이다.34,51,52 평가 설계자는 이러한 현실에 더 이상 순진한 태도를 취해서는 안 된다.
    • ‘총괄시험(summative testing)’이라는 이름이 붙은 것은 일상적으로 형성적이다. 평가 관행은 학습자가 무엇을 공부할지 결정하고,39 학습해야 할 자료를 기억할 가능성에 영향을 미치며,53 평가 후 어떤 추가 학습을 우선해야 하는지에 관한 의사결정에도 영향을 미치기 때문이다.54
    • ‘형성평가(formative testing)’라는 이름이 붙은 것은 일상적으로 총괄적이다. 피드백이 자신의 정체성을 위협할 때마다 학습자는 자신이 판단받는다고 느끼고, 그로부터 온갖 부정적 영향이 생길 수 있기 때문이다.43,55,56
  • 예를 들어, 고부담 총괄 의사결정을 내리는 역량위원회(competency committee)의 검토를 위해 자료가 합산되는, 명목상 형성적인 평가 순간에 학습자들이 어떻게 반응하는지를 생각해 보라.57
    • 다음 훈련 단계로 진급하는 데 영향을 미칠 수 있다면, 훈련생이 관찰받을 순간을 ‘골라 택하는(cherry-pick)’ 것이 놀라운 일인가?58,59
    • 교육자가 개별 순간을 학습을 위한 평가라고 부르더라도, 훈련생이 평소처럼 행동하기보다 기대된다고 생각하는 방식으로 ‘연기(perform)’하는 것이 놀라운 일인가?60,61
  • 공허한 수사적 주장으로 학습자를 잘못 이끌기보다, 고부담 평가 관행에 참여하는 전 과정에서 의미 있는 학습을 우선하도록 그들을 가장 잘 안내하는 방법에 의도적으로 더 큰 초점을 두어야 한다.

2.4 | 함의 (Implications) 

  • 그 핵심에서 볼 때, 총괄평가 대 형성평가라는 신화적 구분은 역량을 갖춘다는 것이 무엇을 의미하는지 잘못 나타내며, 그 결과 학생·교육자·시험 설계자가 평가 절차의 타당도에 관한 논증을 구축하는 데 필요한 근거의 폭을 오해하게 만든다.34,38 역량(competence)은 정적이거나 보편적인 방식으로 개인에게 귀속할 수 있는 특성이 아니라, 맥락에 따라 달라지는 과정(context-dependent process), 즉 지속적인 노력과 상황에 대한 적응을 요구하는 무엇이다. 따라서 특정 시점의 시험에 크게 의존하는 모든 고부담 의사결정은 역량을 타당하게 반영하기에 불충분하며, 실제로 우리가 원하는 숙련도(proficiency), 전문성(expertise) 및 숙달(mastery)을 반영하기에는 더더욱 부족하다.62 이러한 평가는 필연적으로 특정 순간에 ‘측정 가능한 것’으로 초점을 축소한다. 그 과정에서 (a) 기억은 희미해지고, (b) 새로운 것을 학습해야 하며, (c) 크게 달라지는 사회적·물리적 어포던스(affordances)가 수행에 영향을 미치면서 역량이 끊임없이 변화한다는 사실을 무시한다. 역량을 갖춘다는 것은 교과서를 넘어, 명확한 ‘정답’이 없을 때 무엇을 해야 하는지 결정하는 능력을 요구한다.63 또한 자신의 지식과 기술 집합에 지속적이고 의도적으로 재투자할 것을 요구한다. 그러므로 고부담 의사결정을 내릴 때 특정 시점의 시험에만 의존하는 것은 역량이 영구히 지속되는 것처럼 암시함으로써 역량바탕교육을 지향하는 교육적 노력을 근본적으로 약화시킨다.
  • HPE와 보건의료전문가 평가의 많은 부분이 발전해 왔지만, 특히 면허와 인증 단계에서 고부담 평가에 접근하는 방식은 변화가 더뎠다. 다시 말해 주목할 만한 예외가 나타나고 있지만, 그러한 노력조차 규제기관이 자신의 책임에 대해 상반된 관점을 유지하고 있음을 보여준다.44 너무 많은 이들이 고부담·총괄적·신뢰할 수 있는·특정 시점의 평가를 저부담·형성적·진정성 있는 학습 궤적과 대비해 왔고, 그 결과 성장하고 지속되는 역량의 촉매로서 고부담 평가가 가진 잠재력을 활용할 수 있는 우리의 능력이 훼손되었다. 여기에 제1절에서 제시한 논거의 역설이 있다. 고부담 시험 옹호자들은 진정한 역량바탕교육이 아직 성숙하지 못했기 때문에, 즉 교육 프로그램의 의사결정만으로는 신뢰할 수 없기 때문에 고부담 시험이 필요하다고 주장한다. 그러나 고부담 시험이 특정 시점의 시험에 머무는 한, 실제로 역량을 가능하게 하는 장기적 학습 행동, 습관, 실천 및 기회를 촉진하는 데서 노력을 빗나가게 하여 계속해서 역량을 저해할 것이다. 이 경우 이러한 도구는 협소하고 시간적으로 제한된 초점을 넘어 질을 보장하려는 목적에 적합할 수 없으므로, 타당도 주장은 필연적으로 공허하게 울릴 것이다.

3 | 앞으로 나아갈 길 (A Path Forward) 

역량바탕교육의 현재 모습에 호감을 갖든 혐오감을 갖든, 시간, 자기평가(self-assessment) 및 지도자의 견해가 불충분하다는 사실에 관해 너무 많은 것을 알게 되었으므로, 어떤 형태로든 더 심리측정학적으로 엄밀한 자료 수집을 포함하지 않은 채 이들만으로 역량을 보장할 수 있다고 믿을 수는 없다.64–66 그러나 심리측정학적 기준을 고부담 의사결정을 내리기에 충분한 것과 혼동하면, 역량의 타당한 평가라는 주장을 가능하게 하기보다 오히려 역량을 약화시킨다. 즉, 평가의 문지기 역할에만 배타적으로 초점을 맞춘 터널 시야는 고부담 의사결정(high-stakes decisions)을 고부담 시험(high-stakes tests)과 혼동하며, 그 결과 보건의료전문가가 경력 전체를 준비하는 데 해를 끼친다.

  • 고부담시험의 타당도는 부분적으로 신뢰도(reliability)를 바탕으로 평가할 수 있지만,
  • 고부담 의사결정의 타당도에는 여기에 더해 역량 추구를 맥락 의존적이고 복잡하며 변화하는 것으로 개념화하는 데까지 확장되는 합리성(reasonableness)이 필요하다.

앞으로 나아가려면 고부담 의사결정의 근거가 되는 평가를 단지 넘어야 할 장애물로 취급하게 만드는 ‘양자택일(either/or)’ 사고에서 벗어나야 한다. 그러한 평가는 불평을 유발할 수는 있지만 일단 ‘통과’하고 나면 대체로 ‘과거’의 일로 무시할 수 있다. 우리는 ‘양자병합(both/and)’의 상승효과를 활용하여 단기적으로 안전을 보장하고 장기적으로 발달을 가능하게 하는 방향으로 나아가야 한다.35


서두에서 언급했듯, 맥락의 가변성과 중요성 때문에 앞으로 나아갈 길을 모색하면서 무엇을 바로잡기 위해 구체적으로 어떤 조치를 해야 하는지를 주장하기는 어렵다. 대신 우리는 타당도 논의에서 보편적으로 강조해야 할 의사결정의 세 가지 측면, 즉 고부담 평가를 수행할 권한을 가진 모든 기관에 적용되는 초점의 확장(broadening focus), 시간 범위의 확장(broadening timelines), 방어 가능성 개념의 확장(broadening notions of defensibility)을 제시한다.

3.1 | 초점의 확장 (Broadening focus) 

  • 모든 역량바탕교육 프레임워크는 그 핵심에서, 안전하고 효과적이며 공정한 진료를 보장하기 위해 지식이 필수적이지만 충분하지는 않다는 성찰을 담고 있다. 따라서 우리는 현대의 실무가 임상의에게 효과적인 협업, 불확실한 상황에서의 현명한 의사결정, 빠르게 변화하는 근거와 테크놀로지에 대한 적응 등을 요구하는 이유를 설명하는 데 많은 지면을 할애하지 않겠다. 다만 마지막 문제와 관련하여, 지식 기반의 고부담·개인별·특정 시점 시험이 수행하는 문지기 기능은 복잡하고 팀 기반이며 사회적으로 상황 지워져 있고(socially situated) 끊임없이 진화하는 현대 의료의 현실과 점점 더 어긋나고 있다는 점을 주목할 필요가 있다. 그러므로 제한적인 심리측정학적 기준을 충족한다는 이유로 한 개인이 아는 것 또는 적용할 수 있는 지식에 대한 시험만을 ‘반영할 가치가 있는 것(count)’으로 인정하고, 표준화 시험으로 쉽게 측정할 수 없는 모든 것을 무시하면서 고부담 의사결정에 대한 합리적 타당도 논증을 유지할 수는 없다. 부정적 사건이 주로 불량한 인계, 의사소통 실패 및 전문직업성(professionalism) 문제에서 비롯되는데,25,67 특정 시점의, 흔히 필기 형태인 지식시험을 고부담 의사결정의 근거로 삼는 것이 무슨 의미가 있는가? 더구나 전통적인 고부담 평가 모형이 이미 잘 확립된 보건의료전문직 역량의 폭조차 의미 있게 다루지 못했는데,30 인공지능의 급속한 역할 확대와 사회적 불평등처럼 새롭게 부상하는 변화는 어떻게 따라갈 수 있겠는가?
  • 역량바탕교육의 시대가 점점 더 확고히 자리 잡으면서, 고부담 의사결정에 책임이 있는 이들은 핵심적인 역량 측면을 살펴보지 않은 채 남겨두어 응시자와 대중에게 그 가치를 낮추어 보이게 할 것이 아니라, 기대되는 역량의 전체 범위를 의사결정 과정에 포함하는 모형을 발전시켜야 한다. 일부 지역에서는 자격 유지(maintenance of certification) 단계에서 이러한 변화가 일어나고 있지만,44 훈련 초기 단계에서 사용하는 고부담 모형은 학습자가 지속적인 역량을 어떻게 입증해야 하는지 이해하도록 돕는 데 거의 기여하지 못한다. 오히려 북미에서는 최근 면허 부여 과정에서 수행기반 시험(performance-based examinations)이 폐지되면서 이 문제가 더 심화되었다. 현재의 시대를 타당하게 반영하고 고부담 평가 전략을 미래에도 지속 가능하게 만들려면, HPE는 진정성 있는 전문직 과업(authentic professional tasks)과 관련된 근거를 고부담 의사결정에 투입할 방법을 더욱 발전시켜야 한다. 광범위한 근거 수집으로 나아가려면 고부담 평가를 독립된 사건이 아니라 시스템의 일부로 재개념화해야 한다. 또한 점점 널리 활용되는 프로그램형 평가 모형의 다면적·다맥락적·누적적 측면을 고부담 맥락으로 전환해야 한다. 따라서 타당도 논증은 하나의 시험점수가 지닌 유용성(utility)에만 배타적으로 초점을 맞출 수 없다. 고부담 의사결정은 국가 기준에 부합하도록 수집되고 서로 통합된 여러 출처의 누적 근거에 기반할 수 있고, 또 그래야 한다.68 여러 맥락, 관점 및 시간대를 표집하는 직무현장바탕평가(workplace-based assessment), 수행 관찰 및 성찰 활동을 활용하는 것만이 실무의 신뢰할 만하고 의미 있는 모습을 구축하고,69,70 고부담 특정 시점 시험만이 주는 그릇된 안도감을 극복하는 길이다.
  • 국가 기관은 특정 시점의 시험을 제공할 뿐 아니라, 실무자·규제기관·교육기관·환자 집단·평가기관 사이의 새로운 협업과 공동 책무(shared accountability) 모형에서 소집자(convener)와 기준 설정자(standard setter)로 기능함으로써, 고부담 의사결정으로 이어지는 평가 관행에 영향을 미칠 수 있는 독보적인 위치에 있다. 동시에 시험기관이 수집하는 특정 시점 자료에 실제 현장 수행(in situ performance)에 관한 보완 정보를 더하려면, 훈련 프로그램 내부의 기관 차원 참여와 유연성이 필요하다.71 예를 들어 팀워크, 전문직업성 및 자기조절학습(self-regulated learning)과 같은 역량은 고립된 수행이 아니라 일관성과 성장에 근거해서만 판단할 수 있으며, 다음 절에서 이를 자세히 설명한다. 그러한 자료에 대한 신뢰를 확보하는 방법은 방어 가능성 개념의 확장을 다루는 절에서 다시 논의할 것이다.
  • 여기서는 이것이 고부담 시험에서 입증되어 온 심리측정학적 엄밀성을 거부하는 것도, 고부담 평가를 교육 프로그램에 떠넘기는 것을 정당화하는 것도 아님을 밝힌다. 오히려 이는 현대의 실무에서 역량을 갖는다는 것이 무엇인지를 더 온전히 반영하도록 평가 절차를 진화시키자는 요청이다.72 모든 보건의료전문가가 불확실한 상황에서 효과적으로 협업하고 현명한 결정을 내릴 수 있어야 한다고 기대한다면, 그들의 역량에 관한 고부담 결정을 내리는 책임을 맡은 이들에게 그보다 못한 것을 어떻게 요구할 수 있겠는가?

3.2 | 시간 범위의 확장 (Broadening timelines) 

  • 앞 절에서는 고부담 의사결정에 관한 타당도 주장이 고부담 시험을 보완하고 흔히 그 시험보다 앞서 수집되는 자료 출처를 포함해야 한다고 논증했다. 이 절에서는 그러한 시험이 시험 후의 학습을 어떻게 이끄는지를 고려함으로써 장기적으로 역량을 뒷받침하는 일 역시 반드시 필요하다고 주장한다.
  • 이 글 전체와 Warm et al73이 설명했듯, 특정 시점의 평가는 전문직 역량이 지닌 맥락 의존적이고 발달적인 속성을 타당하게 포착하는 능력에 본질적인 한계가 있다. 고부담 의사결정이 복잡한 전문직 수행을 고부담 시험의 합격-불합격 결과로 축소할 때, 이러한 평가는 역량에 대한 정적이고 이분법적인 개념을 암묵적으로 조장하며, 역량은 계속해서 길러야 하는 것이 아니라 한 사람이 ‘보유한’ 것이라는 문제적 관념을 강화한다.4 더 나쁜 점은 합격선 위의 모든 사람을 동일하게 취급한다는 것이다. 그 결과 경계선에 있던 사람은 매우 뛰어난 사람과 마찬가지로 자신의 결과를 후속 관리할 추가 동기40,74도, 그렇게 할 방법에 관한 안내43,75도 받지 못한다(통념 2에서 상세히 설명한 바와 같다). 고부담·고품질의 특정 시점 평가가 시험 당시 피평가자의 지식과 일부 기술의 발달 수준에 대해 제공할 수 있는 신뢰할 만한 스냅숏이 역량 보장이라는 주장에 기여하려면, 고부담 평가는 질 통제(quality control)에만 초점을 맞추는 방식에서 벗어나 생성된 자료를 질 향상(quality improvement)에 어떻게 투입할 것인지 고려하는 방향으로 전환해야 한다.
  • 이를 의미 있게 수행한다는 것은 단순히 수행 보고서를 제공하고 응시자가 그것을 피드백으로 활용하기를 기대하는 일이 아니다.42 이 재개념화는 고부담 평가 자료를 훈련에서 실무로 이어지는 연속선(training-to-practice continuum) 전반에 걸친 개별화 학습계획(individualised learning plans)에 통합하는 것을 지향한다. 달리 말해, 고부담 평가를 교육적 책임의 종착점으로 취급하는 대신 지속적인 전문직 성장의 촉매로 만들어야 한다.45 학습계획은 필기시험, 직무현장 관찰, 다원적 피드백(multisource feedback), 수행기반 평가 등 다양한 평가 경험에서 얻은 정보를 종합하여 자기조절학습을 지원하는 일관된 지침으로 만든다.76,77 그러나 고부담 시험 자료는 이러한 실천에 거의 포함되지 않는다. 이는 자원을 낭비하고, 지속적인 학습에 차선의 영향을 미치며, 지속적 역량을 보장하는 데 필요한 평생학습에 피평가자가 효과적으로 참여할 역량에 관한 추가 정보를 수집할 기회를 놓치는 일이다.
  • 고부담 시험 자료를 더 큰 시스템의 한 요소로 포함하면 학부교육, 졸업후훈련 및 지속전문직개발(continuing professional development)에 걸친 학습자의 궤적을 스캐폴딩(scaffolding)함으로써 역량의 타당한 평가라는 주장을 강화할 수 있다.73 대부분의 맥락에서 이 ‘연속선’은 후속 학습과 규제 감독 모두에 의미 있는 지원을 제공하지 못하는 방식으로 분절되어 있다.78 고부담 평가에서 흔히 이루어지는 엄밀한 자료 수집을 통합한 구조화된 학습자 인계(structured learner handovers)와 포트폴리오 기반 접근은, 확인된 학습 요구가 주요 전환점에서 소실되거나 무시되지 않도록 함으로써 이러한 분절을 완화할 수 있다.79 이러한 개발은 고부담 평가를 현대 보건의료 실무의 현실과 일치시키는 데 필요하다. 지식·테크놀로지·사회적 기대가 변화하고 세계가 점점 더 역동적으로 변함에 따라, 수십 년의 실무에 걸쳐 역량을 유지하는 일은 몇 년의 정규 훈련 동안 역량을 획득하는 것보다 더 큰 도전이 될 것이다.13 따라서 고부담 평가가 학습의 연속성(continuity of learning)을 얼마나 가능하게 하는지는 ‘범위 밖(out of scope)’이라고 태연하게 일축할 사항이 아니라, 모든 고부담 시험기관의 타당도 논증에서 필수적인 고려사항이 되어야 한다.
  • 종단적이고 자료에 기반한 평가 인프라(longitudinal, data-informed assessment infrastructures)가 없다면, 규제기관은 선제적으로 향상을 지원하는 대신 실패가 발생한 후 대응할 수밖에 없다. 고부담 면허·인증 절차와 함께 학습계획을 교육 시스템에 내장하면, 고부담 의사결정은 순전히 후향적인 질 ‘보장’ 판단, 즉 저성과자에게만 후속 조치라는 징벌적 개입을 제공하는 방식에서 벗어나, 인력 개발을 위한 전향적 질 향상 전략의 의미 있는 일부로 전환될 수 있다. 고부담 시험에서 생성된 자료가 의사들이 경력 전반에 걸쳐 자신의 수행을 더 잘 유지하고 향상하도록 지원할 때, 고부담 의사결정은 환자 보호라는 책무를 더욱 진정성 있게 이행한다. 결국 학습계획을 개발하고 활용하는 행위 자체가 자신의 한계를 인식하고, 외부 자료를 이용해 향상을 이끌며, 시간에 따라 실무를 조정하는 능력을 반영하는 핵심 전문직 역량이다. 그러나 이러한 재개념화를 위해서는 특정 시점의 자료만이 객관적이며,80 ‘객관적’ 정보만이 방어 가능하다는 근시안적인 관념에서 벗어나야 한다.

3.3 | 방어 가능성 개념의 확장 (Broadening notions of defensibility) 

  • 실제 세계에는 본질적으로 가변성이 존재하고 많은 역량을 평가하려면 판단이 필요하다.29,81 따라서 고부담 의사결정에 직무현장바탕평가 자료를 사용할 것인지에 관한 논의는 대체로 불편한 선택의 문제로 구성되어 왔다. 즉, 실무의 불충분한 범위에 관한 매우 정밀한 자료를 바탕으로 결정하거나, 중요한 것의 폭을 다루기 위해 표준화를 덜 받아들이는 것 중 하나를 선택해야 한다는 것이다.82 그러므로 고부담 의사결정의 타당도에 관해 충분한 논증을 구축할 수 있도록 고부담 시험을 시험 시점 전후의 다른 근거 출처로 보완하는 방법에 관한 모든 논의는, 엄밀성과 진정성(authenticity)을 상호 배타적인 것으로 취급하는 데서 어떻게 벗어날지를 고려하는 것에서 출발해야 한다.
  • 진정성 있는 상황에 의존하여 고부담 의사결정에 정보를 제공하는 데 대한 두려움은 부분적으로 보건의료전문가의 업무가 ‘복잡하고 난삽하다(messy)’는 인식에서 비롯된다. 환자는 흔히 명확한 진단을 갖고 있지 않고, 여러 문제가 공존하며, 동반질환은 서로 영향을 미친다. 적절하게 구성한 검사 및 관리 계획은 개인의 요구, 선호 및 기대에 맞추어야 한다. 이러한 환경에 필요한 역량은 객관식 문항(multiple-choice questions, MCQs)으로 충분히 측정할 수 없다. 또한 객관식 문항은 전문성이 단지 정답을 제시하는 일이라는 신호를 줌으로써 장기적 역량을 촉진하지도 못한다. 객관구조화진료시험(objective structured clinical examinations, OSCEs)과 같은 수행기반 시험은 효과적인 실무에 필요한 과정을 평가하는 데 더 가까이 다가갈 수 있다. 그러나 실행 가능성을 위해 각 스테이션의 초점을 좁혀야 하고, 표준화를 위해 체크리스트 기반 채점 절차를 사용해야 하므로, OSCE 채점표와 실제 세계의 기대 사이에는 잘 알려진 괴리가 생겼다.54,83 다시 말하지만 우리는 이러한 평가에 반대하는 것이 아니다. 그것들을 고려하는 일은 중요하다. 다만 고부담 의사결정에서 이러한 평가에만 의존한다면, 그것이 제공하는 이익은 너무 제한적이고 전달하는 메시지는 지나치게 오도적이어서 충분히 설득력 있는 타당도 논증의 토대가 될 수 없다고 주장한다. 복잡하고 난삽한 실제 세계의 맥락에서 임상추론을 해나가는 일이야말로 임상의가 매일 수행하는 진정성 있는 업무이다. 그럼에도 시험기관의 기술 보고서를 잠시 훑어보기만 해도 그러한 맥락에서의 수행에 초점을 두지 않는다는 사실이 근본적인 신뢰성 문제를 낳음을 알 수 있다. 신뢰도가 낮은 시험은 흔히 보건의료전문직 역량의 타당한 측정이 아니라고 지적되지만, 진정성을 배제한 신뢰도 역시 타당도에 그만큼 강력한 위협이다.40
  • 고부담 평가 과정에 무엇을 요구해야 하는지를 둘러싼 이러한 양극화를 넘어, 더 강력한 타당도 논증을 위해 초점과 시간 범위를 확장하려면 실제 실무에서 임상의에게 요구되는 것을 더 직접적으로 살펴보는 것이 도움이 된다. 그곳에서 이루어지는 행동과 의사결정은 특정한 임상 전략을 엄격하게 따르는 것보다 가변성으로 더 잘 특징지어진다. 임상적 불확실성이 있는 상황에서는 이질성(heterogeneity)이 일상적으로 나타난다. 불확실성이 없더라도 비용 부담 가능성, 접근성 및 환자 선호와 같은 맥락적 요인 때문에 임상의의 접근과 결과는 흔히 서로 다르다.84 때로 이러한 변이가 정당하지 않지만, 확립된 임상진료지침을 잘 알고 있는 의사조차 특정 상황에 맞추기 위해 지침에서 벗어나는 것은 흔히 상당히 합리적인 것으로 여겨진다. 실제로 전문가는 초보자보다 그렇게 할 가능성이 높다.85 여기에 개별 의사가 진료하는 환자군이 전문과 내에서조차, 하물며 전문과 사이에서는 더 크게 달라진다는 현실까지 더하면, 정해진 규칙을 항상 따르는지에 근거해 한 사람을 의미 있게 평가할 수 있다는 생각은 곧 상상하기 어려워진다. 미래를 내다보면, 어차피 알고리즘화되어야 하는 실무의 측면은 점점 더 인공지능의 영역이 될 가능성이 크다.
  • 따라서 필요한 것은 가변성을 인정하고 피평가자가 인위적으로 단순한 ‘정답 = 역량 있음(correct = competent)’이라는 관념에 빠지기보다 성실성, 성찰 및 지속적 참여의 중요성을 이해하도록 이끄는 고부담 의사결정이다. 이를 잘 보여주는 예로, 북미의 의료법 체계는 의사의 결정이나 행동이 언제나 옳을 것을 요구하지 않는다. 그보다는 ‘합리적인 의사(reasonable physician)’가 같은 방식으로 행동했을 수 있는지, 즉 그 행동이 방어 가능한지를 묻는다.86 예를 들어 캐나다의료보호협회(Canadian Medical Protective Association)는 ‘모든 의료인은 자신의 과업에 합리적인 수준의 기술과 지식을 적용하고 합리적인 수준의 주의를 기울여야 한다’고 명시한다.87
  • 이러한 방어 가능성 개념을 고부담 평가 관행에 적용하면, 질문은 ‘시험 내부 또는 여러 자료 수집 전략에 걸친 두 근거 출처가 같은 답을 주는가?’에서 멈추어서는 안 되고, ‘합리적인 판단자가 그 근거가 개인의 역량에 관한 결론을 뒷받침하기에 충분하다고 판단할 수 있는가?’까지 나아가야 한다. 이런 방식으로 생각하면, 예를 들어 직무현장바탕평가는 주의를 기울일 가치가 있으려면 서로 다른 지도자로부터 항상 같은 판단을 끌어내야 하는 것이 아니다. 오히려 신뢰할 수 있게 선정된 다양한 사례, 여러 관점 및 기대되는 역량의 폭을 명백히 토대로 삼고, 그 결정이 옳았는지를 지속적으로 모니터링하는 노력에 반영된다면, 의사결정을 위한 합리적 근거로 간주할 수 있다.88
  • 달리 말해, 고부담 의사결정의 순간에도 판단을 절대적이거나 최종적인 것으로 해석할 필요는 없으며, 의사결정 당시 이해한 내용을 조건부로 표상한 것으로 볼 수 있다. 결국 역량이 복잡하고 내용 의존적이며 발달적이라는 속성을 인정하려면, 역량 평가 역시 복잡하고 내용 의존적이며 발달적이라는 속성을 인정해야 한다. 지속적인 수행 모니터링의 가치와 결론이 불가피하게 잠정적이라는 점을 강조하는 타당도 기준을 사용하면서 고부담 평가를 훈련과 실무의 연속선에 통합한다면, HPE는 실무자의 경력 전반에 걸쳐 겸손과 평생학습의 중요성을 전달하는 평가 관행을 개발하기 시작할 수 있다.


4 | 결론 (Conclusion)

원칙적으로 고부담 평가는 보건의료인이 안전한 진료를 제공할 준비와 능력을 갖추었다는 안도감을 대중에게 제공한다. 그러나 국가마다 서로 다른 방향으로 움직이고 있다는 사실은 이러한 관행이 여전히 논쟁적이고 이견이 많다는 점을 보여준다.

  • 영국은 모든 의사가 안전한 실무에 필요한 핵심 지식과 기술을 입증하도록 하기 위해 최근 국가 의사면허평가(national medical licensing assessment)를 시작했다.89 이로 인해 불과 몇 년 전이라면 자유롭게 실무를 수행했을 일부 사람들이 전문직에서 배제될 가능성이 크다.
  • 북미에서는 비용과 적절성에 관한 압력이 커지던 중, COVID-19 팬데믹의 현실로 인해 시험기관이 가상 환경에 쉽게 적용할 수 없는 엄밀한 대면 수행기반 시험을 유지할 수 없게 되면서 그 압력이 더욱 커졌다.90,91 그 결과 면허와 인증 수준 모두에서 고부담 의학 평가 절차가 축소되었고, 이는 불과 몇 년 전이었다면 실무 부적합 판정을 받았을 일부 사람들을 전문직에 포함하는 결과로 이어졌다.

이 분야가 새로운 ‘정상(new normal)’을 향해 나아가는 가운데, 일시적 필요 때문에 사라진 것 중 일부는 사라진 채로 두어야 한다. 그러나 HPE가 고부담 의사결정을 내리는 방식을 바꾸는 데 내재한 위험을 생각하면, 시험을 치르는 순간뿐 아니라 영속적으로 역량 있는 인력을 보장한다는 고부담 평가의 근본적 가치 명제를 재검토해야 할 중대한 시점이다.


Kelley의 타당도에 관한 저술 100주년5을 맞아 이러한 문제를 다시 살펴보면, 현대의 타당도 개념이 타당화(validation)를 논증(argumentation)으로 취급한다는 점에 주목할 필요가 있다. 즉, 시험점수가 관찰 결과를 의미 있게 표상하고, 시험 상황에서 개인의 수행을 반영하도록 일반화되며, 실제 세계로 외삽되고, 의사결정이나 행동에 의미 있는 정보를 제공한다는 주장을 뒷받침할 근거를 어느 정도까지 축적할 수 있는지를 의미한다.33 그러나 모든 논증에서와 마찬가지로, 더 큰 그림의 일부에만 초점을 맞추고 한 영역에서 점점 더 많은 근거를 축적하면서 문제의 폭이 충분히 다루어지지 않았다는 사실을 인식하지 못하는 환원주의(reductionism)의 함정에 빠지기 쉽다. 고부담 평가에서는 역량의 광범위하고 맥락 의존적이며 복잡하고 변화하는 속성을 인정하지 않으면서 역량을 보장한다고 주장할 때 이런 일이 발생한다. 평가 전문가는 심리측정학적 엄밀성에만 초점을 맞춘 타당도 논증을 제시함으로써, 보장하려 한다고 주장하는 장기적 역량을 오히려 훼손한다. 기껏해야 그러한 협소한 타당도 개념은 도구가 한 사람의 지식이나 능력에 관한 순간적인 스냅숏을 제공한다는 목적에 적합함을 보여주는 근거만 생성한다. 방어 가능하고 역량을 보장하려면, 타당도를 평가하기 위해 수집한 근거는 고부담 평가 절차가 특정 시점 시험 이전에 수집된 진정성 있는 실무 정보에 어느 정도 의존하는지, 그리고 시험 이후 역량을 유지하는 데 필요한 행동을 어느 정도 장려하는지도 포함해야 한다.


이는 van der Vleuten의 유용성 모형(utility model)이 말하는 의미에서 절충안을 찾아야 한다는 문제가 아니다.36 예를 들어 실행 가능성(feasibility)과 타당도가 서로 충돌할 수 있고, 따라서 비용-편익 분석을 수행해야 한다는 것은 분명하다. 그러나 여기서 걸려 있는 것은 절충을 너무 쉽게 받아들이고 무엇이 타당도를 구성하는지 지나치게 협소하게 봄으로써, 유용성의 교육적 영향 요소(educational impact component of utility)를 약화시킬 가능성이다. 흔히 고부담 및 저부담과 각각 혼동되는 평가의 총괄적 측면과 형성적 측면은 전통적인 조언이 믿게 하는 것만큼 분리할 수 있지 않다.44 좋든 싫든, McLuhan의 유명한 말처럼 매체가 메시지다(the medium is the message). 고부담 평가 절차가 어떻게 설계되고 고부담 의사결정에서 어떤 근거를 고려하는지는 보건의료인이 경력 전반에 걸쳐 무엇을 중요하게 여기고 무엇을 기대받는지에 관한 정보를 전달한다. 따라서 HPE는 평가 전후에 그러한 노력이 어떻게 질 향상에도 기여할 수 있는지 고려하지 않은 채 질 보장을 주장하는 것을 받아들일 수 없다.


보건의료전문직 실무의 수월성(excellence)을 지원하는 국가 기관은 단순히 질 높은 시험을 제공하는 데 그치지 않는다. 이들은 기준을 높이고, 의학 훈련 프로그램 사이의 협력과 상호 지원을 촉진하며, 흔히 규제기관의 지침에 따라 환자안전을 보장하기 위해 모두가 입증해야 할 역량의 표지를 설정하는 촉매로 기능한다.16 이를 성공적으로 수행하려면 훈련 프로그램, 지속전문직개발 활동 및 개인이 한 단계에서 다음 단계로 이동할 준비가 되었는지를 결정하는 평가 모형을 더욱 통합해야 한다. 또한 모든 수준의 학습자(학생부터 실무자까지)와 그들을 지원하고 평가하는 기관이 더 큰 공동 책임을 느끼게 하는 기전이 필요하다. 따라서 소수에게 필요한 문지기 역할을 수행하는 데 더해 다수에게 의미 있는 교육적 지원으로 기능하는 평가 절차라면, ‘총괄적’이든 아니든 우선시해야 한다.


다시 말해, 이제는 형성평가와 총괄평가의 경계를 명시적으로 흐리고, 교육과 실무의 연속선(선발에서 은퇴까지)을 매끄럽게 하며, HPE 평가 시스템이 장기적 역량을 가능하게 한다는 목적에 적합함을 대중, 훈련생 및 우리 자신에게 보장할 수 있도록 고부담 평가 절차를 현대화해야 할 때다. 이러한 주장은 국가 기관의 근본 목적이 시험을 시행하는 데 있다는 이해와 양립할 수 없다. 그보다 환자안전에 영향을 미치는 방식으로 시험을 효과적으로 시행하려면, 고부담 평가를 범위 면에서 진정성 있고, 방어 가능하며, 평생학습을 가능하게 하는 행동을 장려하는 것으로 다시 중심에 놓음으로써 그 절차가 타당한지에 관한 논증의 초점을 확장해야 한다.


+ Recent posts