Macy Foundation Innovation Report Part II: From Hype to Reality: Innovators' Visions for Navigating AI Integration Challenges in Medical Education
의학교육 문헌은 지금 AI에 대한 낙관으로 넘쳐납니다. 그런데 그 아래로는 회의와 우려의 물살도 계속 흐르고 있죠. 이번에 소개할 논문은 그 낙관과 우려 사이에서, 실제로 AI를 만들고 쓰고 있는 사람들이 무슨 생각을 하는지 들어본 연구입니다.
Josiah Macy Jr. 재단이 2024년 11월 AI 콘퍼런스를 준비하면서 의뢰한 2부작 혁신 보고서(Innovation Report) 중 Part II예요. Part I이 문헌 기반 지형도(landscape review)였다면, Part II는 사람 이야기입니다.
참고로 제1저자 Brian Gin은 예전에 소개했던 'AI에 대한 위임(entrustment)과 EPA' 논문의 저자이기도 합니다. 이 논문에도 그 프레임워크가 인용되어 있어요.
📋 어떻게 한 연구인가
- 대상: 의학교육 AI '혁신가(innovators)' 25명. 학습자 3명, 교수·기관 리더 15명, AI 산업계 7명. 30명에게 연락해 25명이 참여했습니다.
- 혁신가의 정의: 개발자, 기관 리더와 교육자, 학습자를 포함해 의학교육 영역에서 AI 기반 기술을 개발·적용·활용하는 최전선의 개인들.
- 방법: 반구조화 면담(semistructured interviews), 2024년 6월~8월, 온라인. 주제분석(thematic analysis)으로 코딩.
- 결과 구조: 크게 두 덩어리 - (1) AI가 교수·학습과 평가에 미치는 영향, (2) 위협과 완화 전략.
🎓 1. 교수·학습: '어떻게 배우는가'와 '무엇을 배우는가'
어떻게 배우는가
혁신가들이 가장 많이 이야기한 건 역시 AI 튜터(AI tutor) 와 가상 환자(virtual patient) 입니다. AI가 학습자의 필요를 진단하고, 사례와 연습문제를 즉석에서 만들어내고, 면담 기술에 반응하며 대화하는 표준화 환자 역할을 한다는 그림이죠.
여기서 반복해서 등장하는 목표어가 정밀교육(precision education) 입니다. 논문은 이를 이렇게 정의합니다.
"적절한 교육적 개입을, 적절한 학습자에게, 적절한 시점에" 제공하는 것
"right educational intervention to the right learner at the right time"
두 번째로 흥미로운 건 중앙집중식 교육(centralized teaching) 아이디어예요. 참여자들은 이를 '허브 앤 스포크(hub-and-spoke)' 모델로 설명했습니다. 원격지의 학습자도 중앙의 교육에 접근할 수 있게 되고, 결국 각 분야에서 가장 잘 가르치는 교육자에게 배울 수 있다는 구상입니다. 매력적이면서 동시에 조금 서늘한 이야기이기도 하죠. 지역 의과대학 교수의 역할은 그럼 뭐가 되나, 하는 질문이 자연스럽게 따라옵니다.
강의실 형태에 대한 예측도 나옵니다. 전통적 강의 형식이 언젠가 쓸모없어지고(obsolete) 능동학습(active learning)의 비중이 커질 것이라는 전망, 그리고 소그룹 토론에서 동료(peer)의 역할을 AI가 대체할 수 있다는 전망까지요.
무엇을 배우는가
여기가 개인적으로 가장 논쟁적인 지점이라고 봅니다. 참여자들은 암기에서 지식 탐색으로(from memorizing knowledge toward navigating knowledge) 의 이동을 이야기했어요.
한 참여자가 든 예가 인상적입니다. AI가 Krebs 회로의 분자 수준 기전을 이미 알고 있으니, 학습자는 기전의 세부를 암기하는 대신 그것이 질병 과정이나 약물과 어떻게 상호작용하는지에 집중할 수 있다는 것이죠. 이게 여러 면담에서 반복된 인지적 오프로딩(cognitive offloading) 개념입니다.
임상추론 영역에서도 마찬가지입니다. AI가 여러 출처를 끌어와 감별진단을 확장하는 임상의사결정지원(clinical decision support, CDS) 도구로 기능한다는 구상인데, 여기서 참여자들의 의견이 갈립니다.
- 한쪽: 학습자가 최소한의 역량 기준(minimum threshold of competence) 에 도달하기 전까지는 CDS 사용을 제한해야 한다
- 다른 쪽: CDS는 이미 임상 현장에 스며들고 있고, 결국 처음부터 표준 진료의 일부가 될 것이다
AI를 얼마나 깊이 알아야 하는가에 대해서도 스펙트럼이 넓었습니다.
- 한 극단에는 "의대생도 PyTorch로 코딩을 배워야 한다"는 주장이,
- 반대편에는 "AI를 만들 줄 몰라도 쓰고 평가할 수 있다"는 주장이 있었어요.
📊 2. 평가: 채점 자동화를 넘어서
평가 영역의 논의는 세 층위로 정리됩니다.
- ① 기존 평가의 자동화
- 채점 기준표, 마일스톤, 역량에 대한 자동 채점. 특히 OSCE 채점과 가상 표준화 환자와의 상호작용 채점에 관심이 컸습니다. 서술형 평가와 수치 점수가 뒤섞인 대량의 다중양식 데이터(multimodal data) 해석도 여기 포함됩니다.
- ② 새로운 데이터 원천
- 가장 흥미로운 대목입니다. 참여자들은 '환자 진료의 흔적(artifacts of patient care)' 에서 학습자 수행 데이터를 끌어낼 수 있다고 봤습니다. 전자의무기록(EMR) 상호작용, 환자와의 소통, 다른 의료진과의 소통이 여기 해당하죠.
- 한 참여자는 당뇨 환자 여러 명을 진료하며 전공의가 남긴 '디지털 발자국(digital footprints)' 을 AI로 분석하면 표준 진료에 대한 순응과 이탈을 모두 드러낼 수 있다고 했습니다.
- ③ 피드백 생성
- 혁신가들이 가장 열정적이었던 부분입니다. 학습자 개인의 필요와 목표에 맞춘 피드백과 맞춤형 평가를 AI가 생성한다는 것. 이들은 가상 튜터가 '안전한 공간(safe space)' 을 만들어 사실상 무제한의 형성평가(formative assessment) 기회를 준다고 상상했습니다.
⚠️ 3. 네 가지 위협, 그리고 완화 전략
여기가 이 논문의 진짜 알맹이입니다. 표로 정리하면 이렇습니다.
| 위협 | 핵심 문제 | 완화 전략 |
| 투명성·타당도 | AI 모니터링 피로, 'human in the loop'의 한계 | 투명성을 설계 목표로, 산학 파트너십 |
| 편향(bias) | 훈련 데이터의 알려진/알려지지 않은 편향 | 모델 '성적표', 맥락별 사용 평가 |
| 탈숙련·과의존 | 기초 역량의 침식 | '기초 임상역량' 정의, 비판적 평가 능력 |
| 기관 간 불평등 | 가진 기관과 못 가진 기관 | 협력과 자원 공유, 오픈소스 |
투명성과 타당도 🔍
- 가장 먼저 지적된 건 출처 표시의 부재입니다. 인기 있는 AI 모델이 생성한 정보의 출처가 표시되지 않아 정확성과 신뢰성을 검증하기 어렵다는 것. 임상 결정에 쓰이거나 수업 보조자료로 쓰일 때 특히 문제가 되죠. 게다가 특정 교육·임상 맥락에서 AI 모델의 타당도를 재는 표준화된 방법 자체가 없습니다.
- 여기서 나온 개념이 'AI 모니터링 피로(AI monitoring fatigue)' 입니다. 인간 감독자가 AI 출력의 오류를 계속 감시하다 압도되는 상태예요. 'human in the loop' 접근이 좋아 보이지만, AI 출력의 규모 자체가 교육자와 임상의의 감독 역량을 넘어선다는 지적입니다. 저는 이 개념이 이 논문에서 가장 실무적으로 중요한 통찰이라고 봅니다.
- 완화 전략으로는 'AI 도구 성적표(AI tool report cards)' 가 제안됐습니다. 정확도, 편향, 훈련에 사용된 지식 출처 같은 모델 성능 정보를 상세히 제공하자는 것이죠.
편향 ⚖️
- LLM 훈련 데이터의 상당 부분이 인터넷과 공공 영역에서 왔고, 여기엔 편향된 정보, 허위, 유해한 관점, 특정 집단의 과소대표가 포함됩니다. 역사적으로 소외된 인구집단에 대해 편향된 예측이나 권고가 나올 수 있다는 것이죠.
- 한 가지 더 날카로운 지적: 개발자가 윤리나 임상적 신뢰성보다 재정적·시장적 고려를 우선할 수 있다는 점입니다. 그러면 모델은 다양한 사용자 집단의 필요가 아니라 제작자의 이익에 복무하게 되겠죠.
- 완화책으로는 데이터 대표성 평가, 검증된 출처(동료심사 문헌, 큐레이션된 임상 데이터베이스) 기반 훈련, 소외 지역 배포 후 피드백 수집, 이차 AI 모델을 통한 실시간 감시, 적대적 훈련(adversarial training) 등이 거론됐습니다.
과의존과 탈숙련 🧠
- 참여자들은 계산기, 검색엔진, 위키피디아 같은 이전의 기술적 파괴를 비유로 들었습니다. 처음엔 위험하다고 했지만 결국 적응했다는 것이죠. 그럼에도 우려는 구체적입니다.
- 추론을 AI에 맡기면 비판적 사고와 임상추론 능력이 저하될 수 있다
- 오프로딩이 가능하면 스스로 지식을 종합할 동기 자체가 줄어든다
- '생산적 분투(productive struggles)' 와 실패로부터의 학습이 사라진다. 학습자가 AI에 손을 뻗기 전 얼마나 버텨야 하는지 판단할 자기조절 능력이 있을까?
- 부정행위, 그리고 AI 생성물과 인간 생성물을 교육자도 AI 자신도 신뢰성 있게 구별하지 못한다는 문제
- 초기 학습자가 AI의 잘못된 피드백을 교정 없이 초기 인지에 각인시킬 위험
- AI 튜터가 동료나 교수자를 대체하면서 생기는 사회적 고립과 협력적 문제해결·팀워크 역량 미발달
- 핵심 완화 전략은 '기초 역량(foundational competencies)' 정의입니다. AI 지원이 있든 없든 갖춰야 할 최소한의 지식과 기술을 규정해서, 학습자가 필수 영역에서 자율적으로 기능할 수 있게 하자는 것이죠. 그리고 단계적 접근(staged approach): 기본 개념을 먼저 숙달하고 핵심 영역에서 숙련도를 입증한 다음에야 복잡한 과제에 AI를 쓰게 하는 것. 구구단을 뗀 뒤에 계산기를 주는 것과 같은 논리입니다.
기관 간 불평등 🏛️
- 데이터 가용성, AI 관련 기관 정책, 안전한 컴퓨팅 인프라, AI 지식과 전문성, 재원. 이 다섯 가지에서 '가진 기관과 못 가진 기관(haves and have-nots)' 의 격차가 혁신이 진행될수록 더 벌어질 수 있다는 우려입니다.
- 해법으로는 기관 간 데이터 공유 네트워크, 그리고 오픈소스화(open-sourcing) 가 강조됐습니다. 한 참여자는 개방형 파라미터 LLM과 하드웨어의 발전 덕에 이제 노트북에서도 모델을 돌릴 수 있다고 언급했어요. 기관 자체 보안 기준으로 관리할 수 있다는 뜻이죠. 오픈소스의 대상은 모델 파라미터만이 아니라 프롬프팅 전략, 파인튜닝 프로토콜까지 포함됩니다.
- 그리고 마지막 한 문장이 의미심장합니다. 여러 기관의 이해를 묶은 중앙 AI 협력체가 개발사의 기업 이익에 맞서 의학교육의 우선순위(형평성, 편향 완화, 투명성, 타당도)를 대변할 수 있다는 것.
🎯 4. 저자들이 정리한 5대 우선과제
- AI 역량 강화(Enhancing AI competence) — 학습자용 AI 역량 프레임워크와 학부 교육과정 목록이 출발점. 교수진에게는 TPACK 기반 프레임워크가 유용할 수 있음
- 기초 의학역량의 정의(Defining foundational medical competencies) — CDS와 앰비언트 AI 스크라이브가 임상 현장의 일부가 될 미래에도 인간이 역량을 유지하도록 계획
- 윤리적이고 신뢰할 수 있는 AI 사용(Establishing ethical and trustworthy AI use) — 공정성, 투명성, 데이터 보안 가이드라인
- 공동생산과 협력(Fostering coproduction and collaboration) — 학습자, 교육자, 개발자, 이해관계자가 함께 최적화
- AI 영향의 모니터링과 평가(Monitoring and evaluating AI impact) — 특히 모니터링 피로를 줄이기 위해 AI가 스스로 불확실한 출력에 플래그를 달도록 설계·훈련
💬 읽고 나서
몇 가지 남는 생각을 적어둡니다.
- 첫째, 이 논문의 미덕은 '합의'를 만들지 않았다는 점입니다. CDS를 언제 허용할지, AI를 얼마나 깊이 알아야 하는지에서 참여자들의 입장이 갈리는데, 저자들은 이를 봉합하지 않고 그대로 보여줍니다. 서론의 질문 - "우리는 먼저 혁신할 것인가, 먼저 검증할 것인가(Do we innovate first or do we validate first?)" - 은 여전히 열려 있습니다.
- 둘째, 'AI 모니터링 피로'는 우리가 지금 당장 마주할 문제입니다. AI 기반 피드백이나 자동 채점을 도입할 때 우리는 습관적으로 "최종 확인은 교수가 한다"고 씁니다. 그런데 출력 규모가 커지면 그 안전장치는 형식적으로만 남습니다. 도입 설계 단계에서 검토 가능한 분량과 불확실성 플래그를 함께 설계하지 않으면 위임의 외양만 남게 되겠죠.
- 셋째, 기관 간 격차 논의는 한국에서 다르게 읽힙니다. 미국 맥락의 '가진 기관 vs 못 가진 기관'은 우리에게도 그대로 적용되지만, 우리는 상대적으로 학회와 협의체 중심의 협력 기반이 있는 편입니다. 공통 프롬프트, 평가 문항, 파인튜닝 프로토콜을 대학 간에 공유하는 실험이 개별 대학의 자체 개발보다 현실적일 수 있습니다.
- 넷째, '무엇을 가르칠 것인가'로 논의를 옮길 때입니다. Krebs 회로 예시가 상징적입니다. 이 논문은 AI 도입 방법론을 넘어 기초 역량의 재정의를 요구하고 있어요. 2028 교육과정 개편을 준비하는 입장에서, 이건 도구 도입 논의가 아니라 졸업성과 논의입니다.
의학교육 문헌에는 인공지능(artificial intelligence, AI)이 우리가 가르치고, 배우고, 진료하는 방식을 혁신할 것이라는 낙관론이 넘쳐난다. 그러나 AI의 위험에 대한 회의와 우려의 저류도 계속 표면화되고 있다. AI는 주로 자원집약적 과업(resource-intensive tasks)의 자동화를 통해 역량기반 의학교육(competency-based medical education, CBME)과 정밀교육(precision education)에서 오랫동안 추구해 온 목표를 달성할 잠재적 수단으로 환영받았지만, AI가 의학교육에 미칠 단기 및 장기 영향은 여전히 알려져 있지 않다.
생성형 AI(generative AI), 즉 다양한 영역에서 인간의 폭넓은 인지 및 추론 활동을 모방하는 기계의 새롭게 출현한 능력은 의학교육에서 AI 활용을 바라보는 교육자들의 인식에 패러다임 전환(paradigm shift)을 일으켰다.1–3 문헌은 의학교육자와 AI 응용기술 사이에서 이루어진 놀라운 공진화(coevolution)의 과정을 보여준다. 초기 연구들은 생성형 AI 모델의 하위 유형으로서 자연어로 응답을 처리하고 생성할 수 있는 대규모언어모델(large language models, LLMs)의 지식과 추론 능력의 한계를 탐색하였다.4 (AI 용어집은 http://links.lww.com/ACADMED/B730의 Supplemental Digital Appendix 1을 참조하라.) 이러한 연구가 임계 규모에 이르면서, LLM이 표준화시험 문항(예: United States Medical Licensing Examination 및 전문의 자격시험)에 평균적인 인간 수험자보다 더 정확하게 답하고, 그 답에 대한 설명도 제공할 수 있다는 사실이 확인되었다.5–8
이러한 개념증명(proof-of-concept)은 의학교육자들의 상상력을 사로잡았다. 이들은 AI가 “적절한 시점에 적절한 학습자에게 적절한 교육적 개입”을 제공하는 정밀교육을 가능하게 할 잠재력을 내다보았다.9,10 이 주장의 핵심은 AI를 학생의 학습 요구를 진단하고 지식 및 비판적 사고의 전달과 평가를 자동화할 수 있는 “가상 튜터(virtual tutor)” 또는 “코치(coach)”로 활용할 수 있다는 것이었다.11 이러한 낙관론은 AI의 정확성/타당화, 투명성, 정보 출처(편향을 확산시킬 가능성 포함)에 관한 우려로 완화되었다.12–15 이에 대응하여 여러 집단은 AI 역량, 리터러시, 윤리 및 신뢰성(trustworthiness)을 위한 프레임워크를 포함해 생성형 AI 사용에 관한 지침을 개발하고자 하였다.16–19
의학교육 문헌에 드러나듯, AI 통합의 약속은 아직 완전히 실현되지 않았다. 그 결과 정밀교육과 기타 목표를 향한 진전은 중대한 갈림길에 놓여 있으며, 핵심 질문에 관한 공동체의 집단적 결정에 따라 형성될 준비가 되어 있다.
- 우리는(의학교육자 공동체로서) 먼저 혁신해야 하는가, 아니면 먼저 타당화해야 하는가?
- 환자, 학습자, 교육자, 교육프로그램을 포함한 모든 이해관계자를 위해 AI 혁신의 형평성을 어떻게 보장할 것인가?
- AI는 미래 의사와 환자의 지식 및 술기에 어떤 영향을 미칠 것인가?
Josiah Macy Jr. Foundation의 의뢰를 받아 작성된 2부 구성 혁신 보고서의 제2부를 통해, 우리는 의학교육 AI 혁신가의 관점에서 이러한 질문의 답을 찾고자 하였다. 우리는 혁신가를 의학교육 영역에서 AI 기반 기술을 개발하고, 적용하며, 활용하는 최전선에 있는 개인—개발자, 기관 리더 및 교육자, 학습자—으로 정의하였다. 구체적으로 우리는 AI가 의학교육에 미치는 영향, AI 통합이 제기하는 기회와 도전과제, 그리고 위험을 완화하거나 극복할 수 있는 방법에 관한 혁신가들의 인식을 포착하고자 하였다. 혁신가들이 공유한 비전은 혁신 보고서 제1부에 제시된 AI 환경 검토와 함께20 2024년 11월 Macy Foundation Conference on AI in Medical Education에서 이루어진 논의와 개발된 권고21의 맥락 및 토대를 형성하였다.
방법 (Method)
혁신가 선정 (Selection of innovators)
혁신가에는 학습자(n = 3), 교수 및 기관 리더(n = 15), AI 산업계 관계자(n = 7)가 포함되었으며, 문헌에 대한 기여 또는 의학교육이나 보건의료 AI의 핵심 이해관계자로 확인된 사실을 바탕으로 선정하였다. 우리는 30명에게 연락하였고, 25명이 참여에 동의하였다. (면담 참여자의 역할과 직함을 대표적으로 정리한 목록은 http://links.lww.com/ACADMED/B730의 Supplemental Digital Appendix 2를 참조하라.)
반구조화 면담 (Semistructured interviews)
면담 가이드(http://links.lww.com/ACADMED/B730의 Supplemental Appendix 3 참조)는 연구 질문—AI가 의학교육에 미치는 영향에 대한 인식, AI 통합이 제기하는 기회와 도전과제, 위험 완화 전략—에 근거하여 연구팀원 2명(C.K.B., B.C.G.)이 개발하였다. 최초 가이드는 프로토콜과 질문의 명료성을 확보하기 위해 다른 연구팀원 2명(A.K., S.C.)이 검토하였다. 일부 면담 질문은 특정 참여자의 역할에 맞게 수정하고 조정하였다. 면담은 2024년 6월부터 2024년 8월까지 연구팀원 3명(C.K.B., B.C.G., A.K.)이 화상회의로 실시하였으며, 녹음, 전사, 비식별화하였다.
자료 분석 및 코딩 (Data analysis and coding)
면담 자료를 분석하기 위해 주제분석(thematic analysis)을 사용하였다.22 먼저 면담 전사자료를 검토하며 메모하였다. 연구계획서와 면담 가이드를 사용하여 초기 코드를 개발하였다. 정기 회의와 코드북 검증을 반복하는 과정을 통해 코드북을 정교화하였다. 면담 수는 사전에 계획하였지만, 연구팀은 분석 과정 전반에 걸쳐 각 초점집단 내외에서 깊이(경험의 풍부성)와 폭(경험의 범위)이라는 측면의 주제적 충분성(thematic sufficiency)을 모두 고려하였고, 최종적으로 이 자료 세트가 분석적으로 충분하다고 판단하였다. 이 질적 연구의 엄밀성(rigor)을 강화하기 위해 확립된 질적 연구 보고 기준에 따라 보고서를 작성하였다.23 분석에는 Dedoose를 사용하였다.24
성찰성/입장성 (Reflexivity/positionality)
분석팀은 의학(B.C.G., A.K.), 교육연구 방법론(B.C.G., C.K.B.), 사회학(K.L.)에 관한 학문적 훈련을 받았다. 자료 분석에 참여한 연구자 3명(C.K.B., B.C.G., K.L.) 모두 질적 자료를 분석한 경험이 있으며 질적 연구방법을 활용한 논문을 출판하였다.
결과 (Results)
면담 전사자료를 사용하여 혁신가들로부터 수집한 정보를 두 가지 주요 주제로 종합하였다. (1) 의학교육에 AI를 통합함으로써 발생하는 영향과 함의, (2) 잠재적 위험, 우려 및 완화 전략이다.
의학교육에 대한 AI의 영향 (Impact of AI on medical education)
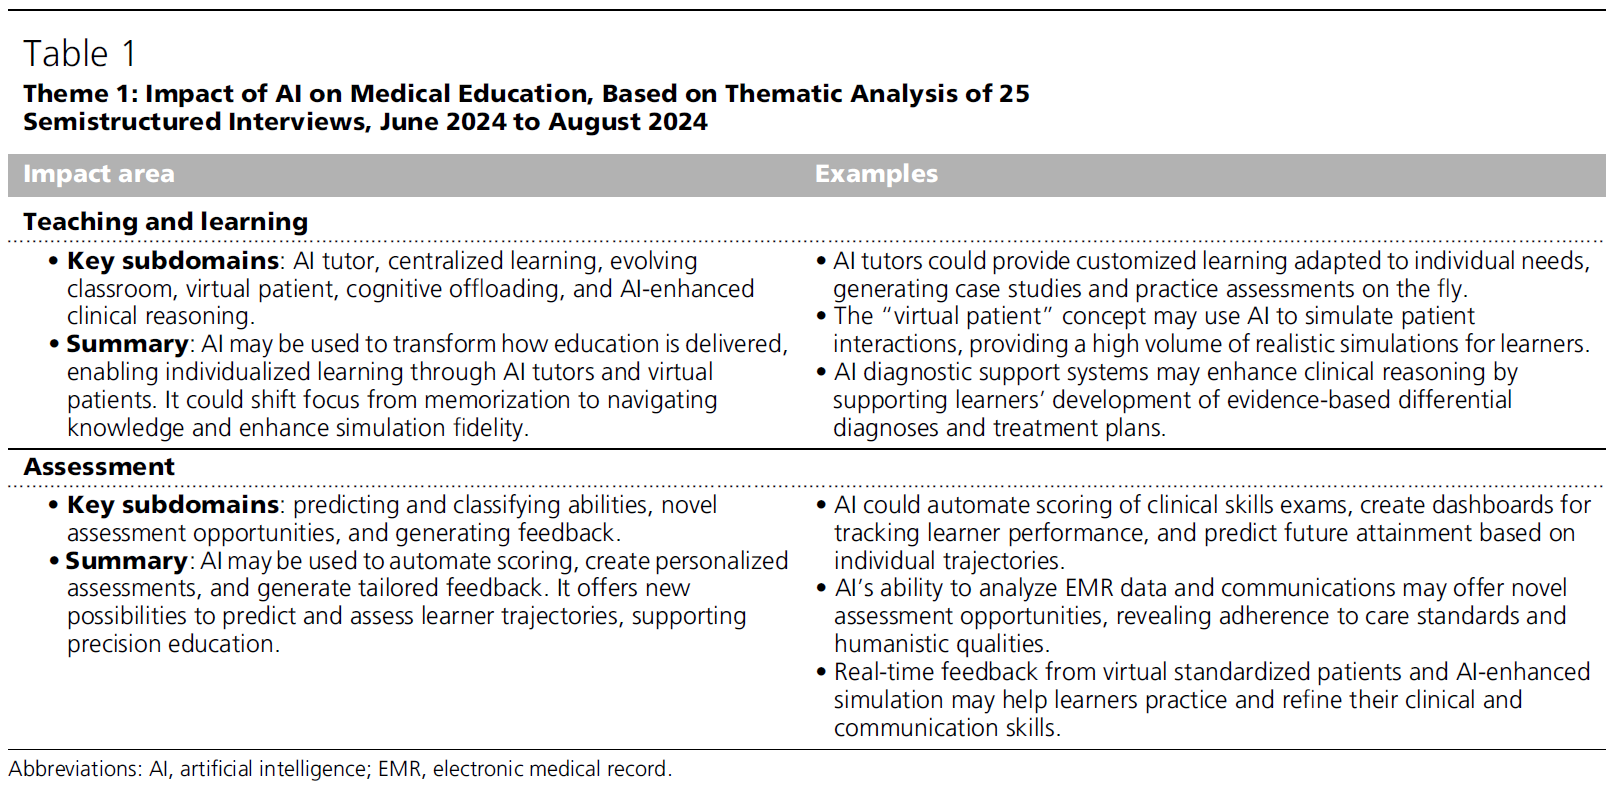
참여자들은 AI가 의학교육에 미치는 영향을 주로 두 영역, 즉 교수·학습과 평가로 인식하였다(표 1).
교수와 학습 (Teaching and learning)
- 참여자들은 학습이 어떻게 이루어지는지, 그리고 무엇을 학습하는지라는 관점에서 AI가 학습과 교수에 미치는 영향을 설명하였다.
- 학습자는 어떻게 학습하는가(How learners learn).
- 참여자들은 LLM이 지식 자원의 역할을 하고 그 지식을 바탕으로 추론하는 능력이 새롭게 발전하고 있다는 점을 비롯하여, AI가 학습자의 지식 및 술기 습득에 도움이 될 수 있다고 생각하는 여러 방식을 설명하였다. 참여자들은 이러한 능력을 활용하여 AI가 가상 튜터와 가상 교사(virtual teacher)의 역할을 하도록 할 수 있다고 설명하였다.
- 면담 참여자들은 AI를 활용해 중앙집중형 교수(centralized teaching)를 가능하게 하는 개념을 논의하면서, 원격지의 학습자들이 중앙집중형 교수에 접근할 수 있는 “허브 앤드 스포크(hub-and-spoke)” 모형을 설명하였다. 여러 참여자에 따르면, 이를 통해 학생들은 각 학문분야에서 가장 효과적이라고 평가된 교육자에게 배울 수 있다.
- 교실과 학습 형식(classroom and learning formats)의 변화도 참여자들이 제기한 잠재적 영향이었다. 여러 참여자는 AI가 장차 전통적 강의 형식을 쓸모없게 만들고, 능동학습(active learning)을 더 강조하게 할 잠재력이 있다고 설명하였다. 일부는 소그룹 토의에서 AI가 동료의 역할을 대신하여 학습자가 인간 동료 대신 AI와 상호작용할 가능성을 설명하였다.
- AI 도구가 시뮬레이션(simulation)을 보강할 잠재력도 강조되었다. 참여자들은 AI를 특정 임상 양상과 사례로 훈련할 수 있으며, 학습자의 면담 술기에 반응하여 대화 방식으로 질문에 답할 수 있다고 설명하였다.
- 학습자는 무엇을 학습하는가(What learners learn).
- 참여자들은 지식을 암기하는 데서 지식을 탐색하고 활용하는 방향으로 전환이 계속되고 있다고 설명하였다. 한 참여자는 AI가 Krebs cycle의 분자적 기전을 알고 있으므로, 학습자가 기전의 세부사항을 암기할 필요 없이 그것이 질병 과정과 약물에 어떻게 상호작용하는지에 집중할 수 있다고 설명하였다. 암기 과업을 AI에 “오프로딩(offloading)”한다는 발상은 여러 면담에서 나타났으며, 그 이점으로 학습자가 비판적 사고 술기와 고차원 인지 과업(higher-level cognitive tasks)의 학습에 집중할 수 있다는 점이 인식되었다.
- “인지적 오프로딩(cognitive offloading)”25이라는 발상은 임상학습환경(clinical learning environment)의 맥락에서도 설명되었다. 참여자들은 AI를 활용해 학습자의 임상추론 능력(clinical reasoning capabilities)을 보강할 수 있다고 설명하였다. 이 발상에는 AI가 여러 출처를 활용하여 감별진단을 개발하거나 확장하고, 임상의사결정지원(clinical decision support, CDS) 도구로 기능하는 능력이 포함된다.26 그러나 참여자들은 CDS 도구를 학습자의 발달 궤적에 어떻게 통합할 것인지에 관해 의견이 나뉘었다. 일부는 학습자가 최소 역량 기준에 도달할 때까지 사용을 제한해야 한다고 주장한 반면, 다른 이들은 CDS 도구가 이미 임상실무에 스며들기 시작했고 결국 처음부터 진료의 표준(standard of practice)이 될 수 있다고 주장하였다.
- 다수의 참여자는 학습자에게 AI 도구를 언제, 어떻게 효과적으로 사용할지, 그리고 AI 생성 산출물을 어떻게 비판적으로 평가(appraise)할지를 가르쳐야 한다는 믿음도 공유하였다. 그러나 학습자가 AI의 기술적 세부사항을 얼마나 알아야 하는지에 대해서는 의견이 일치하지 않았다.
- 한 극단에서 어느 참여자는 의과대학생에게 PyTorch(신경망을 구현하기 위한 응용 프로그램 인터페이스, application programming interface, API)로 코딩하는 법을 가르쳐야 한다고 단언하였다.27
- 다른 극단에서 일부는 AI 응용기술을 만들거나 코딩하는 법을 아는 것이 그것을 사용하거나 평가하는 데 필요하지 않으며, AI가 스스로를 지시하는 데 점점 더 능숙해지는 지점에 가까워지고 있다고 주장하였다.
평가 (Assessment)
- 혁신가들은 특정 시험의 채점 루브릭이나 보다 일반적인 마일스톤(milestones) 및 역량과 같은 확립된 기준에 비추어 학습자의 수행을 자동 채점하기 위해 AI 도구가 현재 사용되고 있다고 설명하였다. 향후 적용에서 특히 관심을 끈 것은 AI를 사용하여 객관구조화임상시험(objective structured clinical examinations, OSCEs)28과, 더 나아가 가상 표준화환자와의 학습자 상호작용을 채점할 가능성이었다.29,30 기존 평가에 AI를 적용할 또 다른 기회에는 AI를 사용해 대량의 다중양식 자료(multimodal data), 즉 서술형 평가와 수치 점수를 함께 해석하도록 돕는 것이 포함되었다.27 이러한 활용은 학습자의 서술형 평가를 요약하고 분류하는 AI의 능력을 이용할 수 있다.
- 혁신가들은 수행 자료를 집계, 요약, 시각화함으로써 학습자의 강점과 약점을 파악하고 해석하는 데 AI를 활용한다고 설명하였다.
- 혁신가들은 기존 평가를 향상시킬 AI의 잠재력에 더해, 학습자의 전자의무기록(electronic medical record, EMR) 사용, 환자(실제 및 모의 환자 모두)와의 의사소통, 다른 의료제공자와의 의사소통을 포함하는 “환자진료의 인공물(artifacts of patient care)”에서 파생된 추가적인 학생 수행 자료에 접근하기 위해 AI를 활용할 가능성을 논의하였다.31,32 예를 들어 한 참여자는 여러 당뇨병 환자를 진료하는 동안 전공의가 남긴 “디지털 발자국(digital footprints)”을 AI로 이해하면, 전공의가 표준 진료를 준수하거나 이탈한 양상을 모두 밝혀낼 수 있다고 논의하였다.33,34
- 혁신가들은 학습자의 요구와 목표에 맞춘 피드백과 맞춤형 평가를 생성하기 위해 AI 도구를 사용하는 데 특히 큰 기대를 표했다.35 혁신가들은 AI 생성 기능이 학습자에게 성장을 촉진하는 저부담 평가(lower-stakes assessments)의 기회를 더 많이 제공할 수 있다고 예측하였다. 그들은 가상 튜터가 학습자에게 형성평가(formative assessment)와 피드백을 받을 수 있는 거의 무제한의 기회를 제공하는 “안전한 공간(safe space)”을 만들 것이라고 전망하였다.
표 1. 주제 1: 2024년 6월부터 2024년 8월까지 실시한 반구조화 면담 25건의 주제분석에 근거한 의학교육에 대한 AI의 영향
| 영향 영역 | 핵심 내용 | 예시 |
| 교수와 학습 |
|
|
| 평가 |
|
|
약어: AI, 인공지능(artificial intelligence); EMR, 전자의무기록(electronic medical record).
AI 통합의 도전과제와 완화 전략 (AI integration challenges and mitigation strategies)
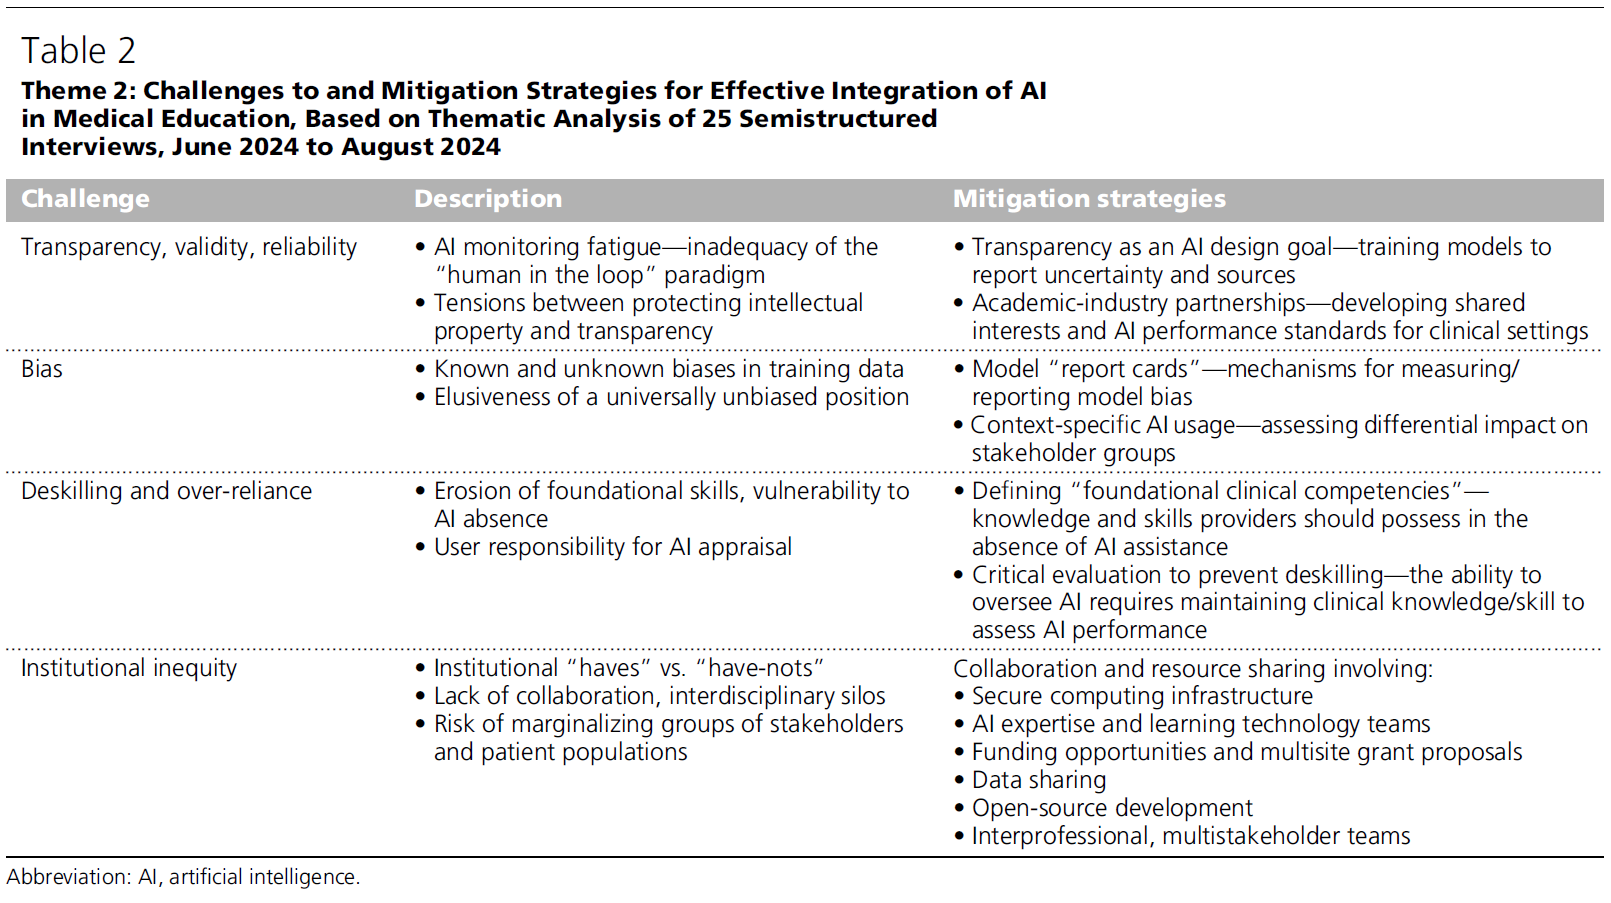
참여자들은 의학교육에 AI를 통합할 때 예상되는 도전과제를 설명하였다. 이들은 AI의 일반적 도전과제(투명성, 타당도, 편향)와 의학교육 AI에 특수한 도전과제(교수/학습 및 형평성)를 모두 설명하였다(표 2). 또한 이러한 도전과제를 다루기 위한 완화 전략도 제시하였다.
AI의 일반적 도전과제: 투명성과 타당도 (General AI challenges: Transparency and validity)
- 참여자들은 인기 있는 AI 모델이 생성한 정보의 출처에 대한 인용이 부족하다는 점이 일차적 문제라고 성찰하였다. 이 때문에, 예를 들어 AI가 임상의사결정에 정보를 제공할 자료를 만드는 데 사용되거나 과목의 보충 학습자료를 제공하는 데 사용될 경우, 모델이 생성한 내용의 정확성과 신뢰도를 검증하기 어렵다. 또한 참여자들은 특정 교육 및 임상 맥락에서 AI 모델의 타당도를 측정하는 표준화된 방법이 부족하다고 지적하였다. 참여자들은 일부 모델이 일반 과업에서는 우수한 수행을 보이지만, 희귀질환의 진단이나 교육적 개입의 맞춤화와 같은 전문 영역에서의 효과는 대체로 타당화되지 않은 상태라는 우려를 공유하였다.4
- 더 나아가 인간 감독자가 AI 산출물의 오류를 지속적으로 모니터링해야 하는 부담에 압도될 수 있는 “AI 모니터링 피로(AI monitoring fatigue)” 개념에 대한 우려가 제기되었다.36 참여자들은 AI 산출물의 방대한 규모가 교육자와 임상의가 AI 생성 산출물을 효과적으로 감독하고 타당화할 수 있는 역량을 초과할 수 있으므로, 인간 운영자가 작업흐름에 참여하여 AI 산출물을 지속적으로 평가하는 “인간 개입형(human in the loop)”37 모니터링 접근을 유지하기 어렵다고 설명하였다.
- 투명성과 타당도에 대한 위협 완화(Mitigating threats to transparency and validity).
- AI 사용의 투명성과 타당도를 확보하기 위해, 참여자들은 의학교육 AI 시스템의 신뢰도와 신뢰성(trustworthiness)을 높이기 위한 여러 전략을 제안하였다. 이러한 전략은 AI 산출물의 타당화, 신뢰할 수 있는 자료원을 확보하기 위한 파트너십 구축, 교육 및 임상 환경에 AI를 체계적으로 평가·통합하기 위한 프레임워크 개발에 초점을 두었다.18,19,38
- 참여자들은 AI가 조작되거나 부정확한 정보를 제공하는 사례인 오류와 환각(hallucinations)39을 발견하고 교정하기 위해 AI 생성 내용을 타당화하는 것이 중요하다고 강조하였다.
- AI 타당화를 보다 제도화하기 위해, 참여자들은 AI 평가 절차를 의학교육과 임상실무에서 사용되는 확립된 타당화 패러다임(validation paradigms)27과 일치시킬 것을 제안하였다.
- 투명성을 높이기 위해 참여자들은 정확도, 편향(아래 참조), 훈련에 사용된 지식 출처 등의 지표를 포함하여 모델 수행에 관한 상세 정보를 제공하는 “AI 도구 성적표(AI tool report cards)”40를 만드는 방안을 논의하였다. 이러한 성적표는 사용자가 다양한 교육 및 임상 적용에서 서로 다른 AI 도구의 적합성에 관하여 더 충분한 정보를 바탕으로 결정하도록 할 수 있다. 이러한 투명성은 AI 개발자의 책무성(accountability)도 촉진하고, AI 산업과 의학교육 공동체 사이의 지속적인 피드백과 협업을 장려할 수 있다.
AI의 일반적 도전과제: 편향 (General AI challenges: Bias)
- 참여자들은 AI 모델에 내재된 다양한 형태의 편향에 우려를 표했다. 이러한 편향은 여러 출처에서 비롯될 수 있으며 의학교육과 임상실무 모두에 중대한 함의를 갖는다. 편향의 일차적 출처는 AI 모델 개발에 사용되는 훈련자료(training data)이다. LLM의 경우 이러한 자료의 상당 부분이 인터넷과 기타 공개 영역에서 유래하는데, 여기에는 편향된 정보, 허위정보, 유해한 관점, 특정 집단이나 관점의 과소대표가 포함될 수 있어 더 광범위하고 다양한 인구집단에 대한 적용 가능성을 제한한다.41,42 이는 특히 역사적으로 주변화되거나 과소대표된 인구집단이 관련된 사례에서 편향된 예측이나 권고를 낳을 수 있다. 또한 개발자가 윤리적 우려나 임상적 신뢰도보다 재정적 또는 시장적 고려를 우선시할 수 있으며, 그 결과 다양한 사용자 집단의 필요보다 개발자의 이익에 복무하고 기존의 불평등을 악화시키며 최초 훈련자료에 존재하는 편향을 확산시키는 모델이 만들어질 수 있다.
- 편향 완화(Mitigating bias).
- AI 모델의 편향 문제를 다루기 위해 참여자들은 훈련자료의 질과 투명성을 개선하고, 다양한 인구집단을 개발 과정에 적극적으로 참여시키며, 견고한 모니터링 및 평가 프레임워크를 실행하는 다면적 접근을 권고하였다. 이들은 자료의 대표성과 다양성을 평가하고, 자료에 부호화된 편향을 식별하며, 이러한 편향이 AI 산출물에 어떻게 영향을 미칠 수 있는지 이해할 것을 제안하였다.14,15,43 또한 고정관념과 부정확성의 확산을 줄이기 위해 동료심사를 거친 의학문헌이나 선별·관리된 임상 데이터베이스와 같이 정확성과 대표성을 검토받은 타당화된 자료원을 사용하여 AI 모델을 훈련하거나 보강할 것을 권고하였다.
- 이들은 서비스가 부족한 지역사회와 주변화된 지역사회에 AI 도구를 배치하고, 이러한 인구집단으로부터 피드백을 구해 AI 모델의 잠재적 편향과 한계에 관한 실제 세계의 통찰(real-world insights)을 수집할 것을 제안하였다. 이러한 참여는 개발자가 모델을 정교화하고 다양한 인구집단의 요구와 맥락에 적용할 수 있도록 보장하는 데 도움을 줄 수 있다.
- 참여자들은 실시간으로 편향을 탐지하고 다루기 위해 이차 AI 모델과 같은 추가적인 자동화 모니터링 층을 사용하는 방안을 언급하였다. 적대적 훈련(adversarial training)도 AI 모델 개발 중 편향을 식별하고 완화하기 위한 기법으로 권고되었다. (이 기법은 숨겨진 편향을 드러내도록 설계된 도전적인 시나리오에 AI 모델을 노출함으로써 모델을 더 견고하고 편향된 결과를 산출할 가능성이 낮게 만든다.)
의학교육 AI의 도전과제: 과도한 의존으로 인한 학습 감소와 탈숙련화 (Medical education AI challenges: Reduced learning and deskilling from over-reliance)
- 참여자들은 AI에 대한 과도한 의존의 위험이 학습자의 학습 감소와 탈숙련화(deskilling, 술기를 개발하거나 유지하지 못하는 것)로 이어질 수 있다고 설명하였다. 잠재적인 위험 완화 전략을 도출하기 위해, 이들은 처음에는 학습자 위험과 연관되었으나 교육자와 학습자가 궁극적으로 적응하고 혜택을 얻었다고 믿는 과거의 기술적 파괴(계산기, 검색엔진, Wikipedia 등)에 비유하였다.
- 추론을 AI에 과도하게 의존하면 비판적 사고와 임상추론 술기가 감소할 수 있다. 참여자들은 추론 술기가 충분히 발달하지 못하는 것에 더해, 그러한 과업을 AI에 오프로딩할 수 있다면 학습자가 스스로 지식을 종합하려는 동기를 덜 갖게 될 수 있다고 우려하였다. AI가 “실패를 통한 학습(learning from failure)”이나 “생산적 고투(productive struggles)”를 저해할 수 있다는 발상도 나타났다.44 참여자들은 학습자가 AI의 도움을 구하기 전에 얼마나 오랫동안 스스로 문제를 해결하려고 노력해야 하는지 판단할 자기조절 규율(self-regulatory discipline)을 갖추지 못할 수 있다고 우려하였다.
- 교육자들은 학습자가 평가에서 부정행위를 하기 위해 AI를 사용하는 것에도 우려를 표했다. 특히 교육자(또는 AI 자체)가 AI 생성 결과물과 인간이 만든 결과물을 신뢰할 만하게 구별할 수 없다는 점이 우려되었다. 참여자들은 학습자가 피드백과 지침을 AI에 과도하게 의존하면 잠재적인 AI 오류, 부정확성 또는 결함에 취약해질 수 있다는 우려도 표했다. 이처럼 “오도하는(misleading)” 피드백은 초기 학습자의 상대적 경험 부족과 결합할 경우, 교정되기 전에 초기 인지에 각인되어 중대한 도전과제를 초래할 수 있다. 마지막으로 AI 튜터/코치가 동료나 교원을 대체할 가능성은 학습자의 사회적 고립과 협력적 문제해결 또는 팀워크 술기를 적절히 발달시키지 못할 우려로 이어졌다.
- 학습 위험 완화(Mitigating learning risks).
- AI 과의존과 관련된 잠재적 위험을 다루기 위해, 참여자들은 학습자가 기초지식과 핵심 술기를 유지하도록 보장하는 명확한 지침과 프레임워크를 확립하는 것이 중요하다고 강조하였다. 한 가지 제안된 전략은 AI 지원의 이용 가능 여부와 관계없이 요구되는 최소한의 지식과 술기 수준인 “기초역량(foundational competencies)”을 정의하고 유지하는 것이었다. 이를 통해 학습자가 필수 영역에서 자율적으로 기능할 수 있도록 보장할 수 있다.
- 또 다른 공통 권고는 특히 평가와 AI 지원 학습의 맥락에서 AI를 언제, 어떻게 사용할 수 있는지에 관한 명시적 지침을 정의하는 것이었다. 앞서와 마찬가지로 평가에서 AI 도구의 단계적 사용 접근이 제안되었다. 즉, 학습자는 더 복잡한 과업이나 문제해결에 AI 도구를 활용하도록 허용되기 전에 먼저 기본 개념을 숙달하고 핵심 영역에서 능숙함을 보여야 한다. 학생이 구구단과 산술의 기본 원리를 숙달한 뒤 계산기를 도입하는 비유가 제시되었다. 이와 유사하게 참여자들은 인터넷 검색엔진과 위키가 지식의 출처가 되었을 때 교육자들이 처음 우려했지만 학습자에게 중대한 부정적 영향이 없었다는 점도 언급하였다.
- 타당화된 자원을 보장하는 것에 더해, 참여자들은 AI 산출물을 비판적으로 평가하고 감독하는 방법을 학습자에게 가르치는 것이 중요하다고 강조하였다.16,41 AI 평가 술기를 개발하면 학습자가 AI 시스템이 제공한 제안을 질문하고 검증할 역량을 갖게 되어, 인간 판단과 AI 지원 사이의 균형을 촉진할 수 있다.
의학교육 AI의 도전과제: AI 자원 격차의 확대 (Medical education AI challenges: Widening AI resource disparities)
- 참여자들은 혁신이 진전되면서 더 커질 수 있는, AI 자원을 가진 기관과 가지지 못한 기관(institutional “haves and have-nots”) 사이의 기존 분배 불균형을 설명하였다. 이러한 자원에는 자료의 이용 가능성, AI에 관한 기관 정책, 안전한 컴퓨팅 인프라, AI 지식과 전문성, 재정 지원이 포함된다.45
- 불평등 완화(Mitigating inequity).
- 참여자들은 AI 혁신에 대한 기관의 접근성 격차를 줄이기 위한 한 단계로서 AI 이해관계자 집단 사이의 협업을 강화할 것을 공통적으로 촉구하였다. 이러한 협업은 자료 공유를 촉진하고, 자료보안 정책을 중앙집중화하며, 컴퓨팅 자원의 격차를 줄이고, AI 개발자와의 관계를 육성할 수 있다. 혁신가들은 교육 관련 자료와 임상 자료 모두에 대한 접근을 촉진하기 위해 기관 간 자료공유 네트워크를 확립할 것을 촉구하였다. 일부는 확립된 임상 자료공유 프로그램46을 본떠 자료공유 노력을 설계하거나, 그러한 프로그램의 범위를 교육자료까지 확장할 것을 제안하였다.
- 참여자들은 오픈소싱(open-sourcing), 즉 AI 도구와 그 기반 매개변수 및 코드를 자유롭게 이용할 수 있도록 하는 것을 혁신가와 기관 사이의 협업을 개선하는 전략으로 설명하였다. 한 참여자는 개방형 매개변수 LLM(open-parameter LLMs)과 컴퓨터 하드웨어의 발전 덕분에 노트북 컴퓨터처럼 흔한 장치에서도 그러한 모델을 로컬로 실행할 수 있게 되었다고 언급하였다. 이러한 개방형 매개변수 LLM은 무료로 내려받아 로컬 컴퓨팅 자원에서 실행할 수 있으며, 로컬 기관의 기준에 맞추어 보안을 확보할 수 있다. 오픈소싱의 발상은 AI 모델(즉, 신경망 매개변수)에 국한되지 않았으며, 프롬프팅 전략(prompting strategies), 미세조정 프로토콜(fine-tuning protocols), 기타 모델 보강 전략을 공동체에 공개하는 것도 포함할 수 있다.
- 중앙집중형 AI 협력체(centralized AI collaborative)를 통해 여러 기관의 이해를 결합하는 것은 형평성, 편향 완화, 투명성, 타당도와 같은 의학교육의 우선과제를 옹호하고 개발자의 기업적 이해와 균형을 이루는 잠재적 수단으로 여겨졌다.
표 2. 주제 2: 2024년 6월부터 2024년 8월까지 실시한 반구조화 면담 25건의 주제분석에 근거한 의학교육 AI의 효과적 통합을 위한 도전과제와 완화 전략
| 도전과제 | 설명 | 완화 전략 |
| 투명성, 타당도, 신뢰도 |
|
|
| 편향 |
|
|
| 탈숙련화와 과도한 의존 |
|
|
| 기관 간 불평등 |
|
다음을 포함하는 협업과 자원 공유:
|
약어: AI, 인공지능(artificial intelligence).
논의 및 권고 (Discussion and Recommendations)
참여자들은 AI가 임상학습환경에서 학습자가 학습하는 방식과 학습하는 내용 모두를 변화시키는 다양한 방식을 설명하였다. 이들은 AI가 학습 방식(예: 가상 튜터 및 가상 환자)을 재정의하고, 기초 의학지식(예: Krebs cycle의 세부사항처럼 덜 자주 사용되는 정보를 암기할 필요를 줄임)을 재정의할 수 있는 방식을 강조하였다. 또한 AI를 활용하여 각 학생의 고유한 요구에 맞게 학습경험을 맞춤화하고 정밀교육의 목표를 가능하게 한다는 공통 목표를 되풀이하였다. 동시에 탈숙련화와 과도한 의존, 모니터링 피로, 편향의 확산을 포함하여 AI가 의학교육에 제기하는 위협도 설명하였다. 참여자들은 이러한 위협을 완화하기 위한 명확한 전략을 제안하였으며, 이를 의학교육에 AI를 통합하기 위한 참여자들의 최우선 영역으로 아래와 같이 종합하였다.
1. AI 역량 강화 (Enhancing AI competence)
- 교육자와 학습자는 AI 도구 사용에 능숙해야 하며 AI 도구와 효과적으로 상호작용하는 전략을 개발해야 한다. 학습자의 경우, 제안된 AI 역량16,41,47과 기본의학교육(undergraduate medical education)의 AI 교육과정 목록48이 검토를 시작하기 위한 좋은 출발점이다. 교수자의 경우, 테크놀로지·교수법·내용 지식(technological, pedagogical, and content knowledge, TPACK)에 대한 AI 관련 영향에 초점을 둔 새로운 프레임워크49가 AI 교수역량(AI pedagogical competencies)의 윤곽을 제시하는 데 도움이 될 수 있다.
2. 의학 기초역량 정의 (Defining foundational medical competencies)
- AI가 의학교육에 통합됨에 따라, 의료실무에 필요한 기초역량을 식별하고 유지하는 것이 매우 중요하다. 환자 결과를 개선할 잠재력이 있는 내장형 CDS 시스템(embedded CDS systems)과 주변형 AI 기록도구(ambient AI scribes)는 곧 임상 환경의 일부가 될 수 있다. 교육자들은 학습과 임상실무의 이러한 변화가 학습자가 의료를 실천하기 위해 알아야 하는 지식과 술기를 어떻게 바꿀 수 있는지 파악해야 하며, 동시에 AI의 지원이 있더라도 인간이 역량을 유지하는 미래를 계획해야 한다.
3. 윤리적이고 신뢰할 수 있는 AI 사용 확립 (Establishing ethical and trustworthy AI use)
- 개인화된 학습경로(personalized learning pathways)에 AI를 통합하려면 공정성, 투명성, 자료보안을 보장하는 지침을 수립하는 것이 필수적이다. 엄격한 감독과 책무성을 유지함으로써 교육자는 AI 도구가 책임감 있게 사용되도록 보장하고, 교육자와 학습자 사이의 신뢰를 구축하며, 테크놀로지가 교육경험을 방해하는 대신 향상시키는 지원적 교육환경을 조성할 수 있다. 윤리17,18,50와 신뢰19,51에 기반한 프레임워크는 이러한 지침을 수립하고 실행하기 위한 잠재적 로드맵으로 제안되었다.
4. 공동생산과 협업 촉진 (Fostering coproduction and collaboration)
- AI로 보강된 교육에 공동생산 모형(coproduction model)을 적용하면 학습자, 교육자, AI 개발자, 기타 이해관계자가 함께 학습과정을 최적화하는 협력적 접근을 촉진한다. 교육자, 기관, 산업계 파트너 사이의 협력 노력은 학습을 진정으로 개인화하는 데 효과적인 AI 도구를 개발하기 위해 매우 중요하다. 자료와 자원을 공유하고 오픈소스 이니셔티브(open-source initiatives)에 참여함으로써, 이해관계자는 의학교육의 변화하는 요구를 충족하도록 AI 응용기술을 지속적으로 정교화하고 조정하는 풍부한 생태계를 만들 수 있다.
5. AI의 영향 모니터링 및 평가 (Monitoring and evaluating AI impact)
- AI 도구가 학습성과, 임상술기, 환자진료에 미치는 영향을 지속적으로 모니터링하고 평가하는 것이 필수적이다. 여기에는 실제 교육 환경에서 AI 응용기술의 효과를 평가하는 견고한 기제를 개발하고, 그것이 정밀교육 및 기초역량의 목표와 일치하도록 보장하는 일이 포함된다. 이를 위해 정확도와 편향 같은 AI 수행 지표를 교육 도구 및 CDS 시스템을 평가하는 기존 프레임워크에 통합할 수 있다. AI 모니터링 피로의 영향을 완화하기 위해, 확신도가 낮거나 교정적 주의가 필요할 가능성이 높은 산출물을 표시하도록 AI 도구를 설계하거나 훈련할 수 있다.
결론 (Conclusion)
의학교육 AI 혁신가와의 면담에서 수집한 관점은 이러한 초기 단계 기술을 교수와 학습에 통합할 때의 우선과제와 도전과제에 관한 귀중한 통찰을 제공한다. 이들이 논의한 우선과제는 의학교육 AI 통합의 위협과 위험을 우회하는 로드맵을 제공하며, 정밀교육을 실현하고 핵심 의학역량을 유지하며 궁극적으로 미래 의료전문가의 준비를 향상시키는 달성 가능한 경로를 제시한다.
'논문 읽기 (with AI)' 카테고리의 다른 글
| 학부 의학교육을 위한 기초 역량 (AAMC, AACOM, ACGME, 2024) (0) | 2026.09.26 |
|---|---|
| 의대 성적에 등급을 매기는 관행, 도대체 어디서 온 걸까? (Teaching and Learning in Medicine. 2026) (0) | 2026.09.01 |
| AI는 지금 의학교육의 어디쯤 와 있을까 — Macy Foundation 혁신 보고서 Part I (Acad Med, 2025) (0) | 2026.09.01 |
| AI를 의학교육에 어떻게 넣을 것인가: AI-PACE 프레임워크 (npj Digital Medicine, 2026) (0) | 2026.09.01 |
| "지금 이 순간, 내가 어떻게 도울 수 있을까?" — 코칭의 세 세대 이야기 (Med Educ, 2026) (0) | 2026.09.01 |